


 Lar
ESI-Bench, de Li Feifei: a IA evolui de observadora para atuante
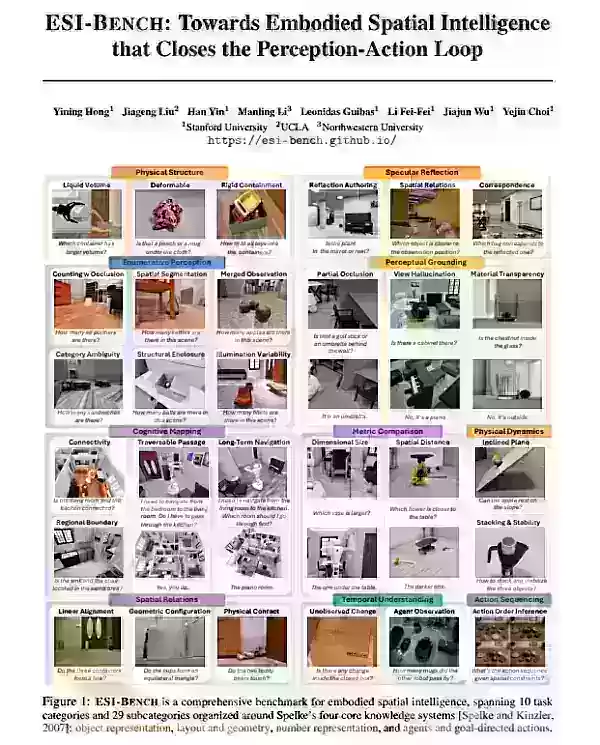
Recentemente, o ESI-Bench (Embodied Spatial Intelligence Benchmark), lançado pela equipe de Fei-Fei Li, tem chamado bastante atenção. Considerado o “ImageNet da inteligência incorporada”, esse benchmark revela deficiências críticas dos principais modelos de grande porte ao interagirem com o espaço físico.
Por que o ESI-Bench estabelece um novo padrão para a inteligência incorporada
As avaliações anteriores de inteligência espacial em IA dependiam amplamente da “percepção passiva”: alimentavam o modelo com algumas imagens de ângulo ideal e deixavam que ele raciocinasse logicamente. Essa abordagem testa essencialmente a “visão” do modelo, e não sua “cognição espacial”.
A principal inovação do ESI-Bench é a imposição do ciclo percepção-ação.
Os observadores tornam-se atores: no ESI-Bench, o modelo não pode permanecer parado e julgar a partir de imagens fornecidas; ele deve decidir ativamente para onde ir, o que observar, quais objetos pegar e quais estruturas mecânicas operar, revelando informações espaciais ocultas por meio de uma série de ações interativas.
Fundamento do projeto: O benchmark baseia-se no “sistema de conhecimento central de bebês humanos”, da psicóloga cognitiva Elizabeth Spelke, abrangendo quatro dimensões: representação de objetos, disposição e geometria, representação de quantidade e ação direcionada a objetivos.
Escala e plataforma: inclui 10 categorias, 29 subcategorias e 3.081 instâncias de tarefas, construídas na plataforma de simulação OmniGibson com materiais da biblioteca de cenas BEHAVIOR-1K.
Três verdades fundamentais reveladas pela avaliação
A equipe de pesquisa realizou testes aprofundados em modelos multimodais de ponta, como o GPT-5 e a série Gemini. Os resultados são instigantes:
1. A percepção não é o gargalo — a estratégia de ação é
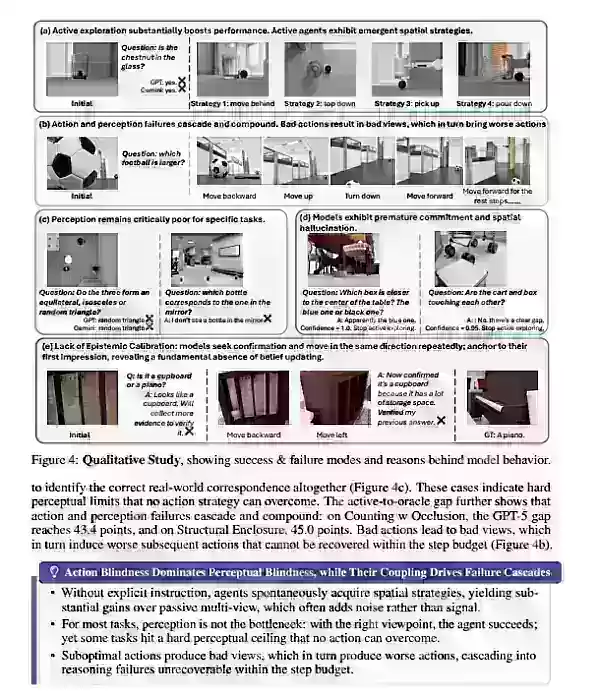
Quando recebem a visão ideal, os modelos costumam fornecer respostas precisas — a precisão pode saltar de 14,6% para 95,1%. Mas, quando precisam encontrar ativamente essa visão, a precisão cai drasticamente.
Cegueira de ação: os modelos carecem de estratégias de navegação e manipulação; ações incorretas levam a visões inadequadas, o que desencadeia erros em cascata nos julgamentos subsequentes.
2. A reconstrução 3D imperfeita é mais enganosa do que imagens 2D
O estudo refuta a suposição de que “mapas 3D são uma solução universal”.
Quando alimentado com dados de referência 3D aéreos perfeitos, o desempenho do raciocínio é excelente. No entanto, o uso do VGGT avançado atual para reconstrução em tempo real introduz artefatos geométricos, erros de oclusão e desvios de profundidade — essencialmente alimentando o modelo de raciocínio com dados tóxicos, o que resulta em um desempenho pior do que simplesmente visualizar imagens 2D.
3. Déficit metacognitivo: a IA não sabe que “não viu o suficiente”
Essa é a maior lacuna cognitiva entre humanos e IA:
Diferença na cautela cognitiva: os seres humanos buscam ativamente perspectivas contraditórias quando as informações são ambíguas e reduzem a confiança em situações de incerteza.
Alucinação do modelo: os modelos frequentemente param de explorar muito cedo, mesmo com informações extremamente limitadas, e apresentam conclusões incorretas com confiança. A equipe chama isso de “déficit metacognitivo” — o modelo carece de um mecanismo interno de dúvida e não consegue avaliar se as informações atuais são suficientes.
Para onde caminha a inteligência incorporada
O ESI-Bench sinaliza uma mudança de paradigma da “correspondência estática entre imagem e texto” para a “interação física real” na avaliação da inteligência incorporada. Conforme observa a equipe de Fei-Fei Li, alcançar a verdadeira inteligência espacial requer mais do que simplesmente empilhar codificadores visuais ou aumentar o poder de computação.
As futuras pesquisas sobre inteligência incorporada devem se concentrar em dotar os modelos de:
Capacidade de tomada de decisão em sequências de exploração ativa, em vez de simples reconhecimento de imagens;
Maior robustez, para manter o julgamento lógico mesmo com observações imperfeitas da cena;
Um ciclo metacognitivo integrado, para que a IA aprenda a explorar quando não tiver respostas, em vez de produzir falsas alucinações.
Artigo relacionado
 Otter.ai garante US$ 320 milhões em financiamento de crescimento da General Catalyst para sua ferramenta de reuniões
Na terça-feira, a Otter.ai, uma plataforma de anotação em reuniões, anunciou um investimento de US$ 320 milhões do Fundo de Valor ao Cliente (CVF) da General Catalyst. Este fundo apoia startups sem exigir diluição acionária, buscando retornos baseado
A Anthropic lança o Claude Haiku 5.5, reduzindo os custos de modelos pequenos em 75% e permitindo que os usuários ajustem a intensidade da inferência
Em 8 de outubro, a Anthropic apresentou seu modelo mais eficiente e capaz até o momento: o Claude Haiku 5.5. Posicionado como o modelo pequeno mais rápido e capaz da linha da Anthropic, ele foi projetado para aplicações de alta frequência e sensíveis
A Claude revela o primeiro mapa completo do céu ultravioleta, mapeando 119 milhões de estrelas
Com o poderoso auxílio do Claude, o modelo de linguagem grande da Anthropic, astrofísicos geraram com sucesso o primeiro mapa completo do céu inteiro em ultravioleta da história. Este vasto mapa estelar, que apresenta 119 milhões de estrelas, foi amp
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (1)
![BrianWalker]()
「観測者からアクターへ」という転換、確かに興味深いですね。Fei-Fei Liさんのチームが提唱するESI-Bench、単なる画像認識の限界を超えて、物理世界での行動能力を測る試みは壮大です。でも正直、今のLLMが本当に「行動」できるのか?という懐疑的な視点も持っています。ロボットの制御と大規模言語モデルの融合は容易ではないはず。このベンチマークがどの程度の実効性を持つのか、今後の展開に注目です。🤖✨
Recentemente, o ESI-Bench (Embodied Spatial Intelligence Benchmark), lançado pela equipe de Fei-Fei Li, tem chamado bastante atenção. Considerado o “ImageNet da inteligência incorporada”, esse benchmark revela deficiências críticas dos principais modelos de grande porte ao interagirem com o espaço físico.
Por que o ESI-Bench estabelece um novo padrão para a inteligência incorporada
As avaliações anteriores de inteligência espacial em IA dependiam amplamente da “percepção passiva”: alimentavam o modelo com algumas imagens de ângulo ideal e deixavam que ele raciocinasse logicamente. Essa abordagem testa essencialmente a “visão” do modelo, e não sua “cognição espacial”.
A principal inovação do ESI-Bench é a imposição do ciclo percepção-ação.
Os observadores tornam-se atores: no ESI-Bench, o modelo não pode permanecer parado e julgar a partir de imagens fornecidas; ele deve decidir ativamente para onde ir, o que observar, quais objetos pegar e quais estruturas mecânicas operar, revelando informações espaciais ocultas por meio de uma série de ações interativas.
Fundamento do projeto: O benchmark baseia-se no “sistema de conhecimento central de bebês humanos”, da psicóloga cognitiva Elizabeth Spelke, abrangendo quatro dimensões: representação de objetos, disposição e geometria, representação de quantidade e ação direcionada a objetivos.
Escala e plataforma: inclui 10 categorias, 29 subcategorias e 3.081 instâncias de tarefas, construídas na plataforma de simulação OmniGibson com materiais da biblioteca de cenas BEHAVIOR-1K.
Três verdades fundamentais reveladas pela avaliação
A equipe de pesquisa realizou testes aprofundados em modelos multimodais de ponta, como o GPT-5 e a série Gemini. Os resultados são instigantes:
1. A percepção não é o gargalo — a estratégia de ação é
Quando recebem a visão ideal, os modelos costumam fornecer respostas precisas — a precisão pode saltar de 14,6% para 95,1%. Mas, quando precisam encontrar ativamente essa visão, a precisão cai drasticamente.
Cegueira de ação: os modelos carecem de estratégias de navegação e manipulação; ações incorretas levam a visões inadequadas, o que desencadeia erros em cascata nos julgamentos subsequentes.
2. A reconstrução 3D imperfeita é mais enganosa do que imagens 2D
O estudo refuta a suposição de que “mapas 3D são uma solução universal”.
Quando alimentado com dados de referência 3D aéreos perfeitos, o desempenho do raciocínio é excelente. No entanto, o uso do VGGT avançado atual para reconstrução em tempo real introduz artefatos geométricos, erros de oclusão e desvios de profundidade — essencialmente alimentando o modelo de raciocínio com dados tóxicos, o que resulta em um desempenho pior do que simplesmente visualizar imagens 2D.
3. Déficit metacognitivo: a IA não sabe que “não viu o suficiente”
Essa é a maior lacuna cognitiva entre humanos e IA:
Diferença na cautela cognitiva: os seres humanos buscam ativamente perspectivas contraditórias quando as informações são ambíguas e reduzem a confiança em situações de incerteza.
Alucinação do modelo: os modelos frequentemente param de explorar muito cedo, mesmo com informações extremamente limitadas, e apresentam conclusões incorretas com confiança. A equipe chama isso de “déficit metacognitivo” — o modelo carece de um mecanismo interno de dúvida e não consegue avaliar se as informações atuais são suficientes.
Para onde caminha a inteligência incorporada
O ESI-Bench sinaliza uma mudança de paradigma da “correspondência estática entre imagem e texto” para a “interação física real” na avaliação da inteligência incorporada. Conforme observa a equipe de Fei-Fei Li, alcançar a verdadeira inteligência espacial requer mais do que simplesmente empilhar codificadores visuais ou aumentar o poder de computação.
As futuras pesquisas sobre inteligência incorporada devem se concentrar em dotar os modelos de:
Capacidade de tomada de decisão em sequências de exploração ativa, em vez de simples reconhecimento de imagens;
Maior robustez, para manter o julgamento lógico mesmo com observações imperfeitas da cena;
Um ciclo metacognitivo integrado, para que a IA aprenda a explorar quando não tiver respostas, em vez de produzir falsas alucinações.








 Otter.ai garante US$ 320 milhões em financiamento de crescimento da General Catalyst para sua ferramenta de reuniões
Na terça-feira, a Otter.ai, uma plataforma de anotação em reuniões, anunciou um investimento de US$ 320 milhões do Fundo de Valor ao Cliente (CVF) da General Catalyst. Este fundo apoia startups sem exigir diluição acionária, buscando retornos baseado
 A Anthropic lança o Claude Haiku 5.5, reduzindo os custos de modelos pequenos em 75% e permitindo que os usuários ajustem a intensidade da inferência
Em 8 de outubro, a Anthropic apresentou seu modelo mais eficiente e capaz até o momento: o Claude Haiku 5.5. Posicionado como o modelo pequeno mais rápido e capaz da linha da Anthropic, ele foi projetado para aplicações de alta frequência e sensíveis
 A Claude revela o primeiro mapa completo do céu ultravioleta, mapeando 119 milhões de estrelas
Com o poderoso auxílio do Claude, o modelo de linguagem grande da Anthropic, astrofísicos geraram com sucesso o primeiro mapa completo do céu inteiro em ultravioleta da história. Este vasto mapa estelar, que apresenta 119 milhões de estrelas, foi amp

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

「観測者からアクターへ」という転換、確かに興味深いですね。Fei-Fei Liさんのチームが提唱するESI-Bench、単なる画像認識の限界を超えて、物理世界での行動能力を測る試みは壮大です。でも正直、今のLLMが本当に「行動」できるのか?という懐疑的な視点も持っています。ロボットの制御と大規模言語モデルの融合は容易ではないはず。このベンチマークがどの程度の実効性を持つのか、今後の展開に注目です。🤖✨












