


 首页
Nvidia 推出可切换推理的开源人工智能模型 Nemotron-Nano-9B-v2
小型语言模型正掀起波澜。 继麻省理工学院衍生公司Liquid AI推出智能手表尺寸的视觉模型、谷歌推出智能手机适配产品后,英伟达现携精简版竞品Nemotron-Nano-9B-V2入局。该模型在关键基准测试中领跑同类产品,并引入独特功能:用户可启用或禁用AI"推理"机制——这实质是生成最终答案前的自我检查流程。
尽管90亿参数规模仍远超近期报道的数百万参数微型模型,但英伟达强调这是对其原始120亿参数模型的重大优化。该模型经过专门设计,可在单块广泛适用的Nvidia A10 GPU上运行。
英伟达AI模型后训练总监奥列克西·库恰耶夫在X平台回应提问时解释道:"我们将120亿参数模型精简至90亿,使其完美适配主流部署GPU A10。该模型采用混合架构,可处理更大批量数据,运行速度较同等规模传统Transformer模型提升六倍。"
作为参考,当前多数领先的大型语言模型参数规模在700亿以上。参数是定义模型行为的内部设置,数量越高通常意味着更强的能力,但也需要显著更高的计算资源。
该模型支持英语、德语、西班牙语、法语、意大利语和日语等多语言处理,扩展能力还涵盖韩语、葡萄牙语、俄语及中文。其适用场景广泛,从执行指令到代码生成皆能胜任。
Nemotron-Nano-9B-V2及其预训练数据集现已登陆Hugging Face平台,并可通过英伟达自有模型目录获取。
融合Transformer与Mamba架构
该模型基于Nemotron-H构建,该系列混合Mamba-Transformer模型是英伟达最新AI产品的基础架构。
主流大型语言模型通常仅依赖Transformer架构及其注意力机制,但随着输入序列长度增加,这种架构在内存和计算成本方面会变得极其昂贵。
Nemotron-H 模型及其他采用 Mamba 架构的模型(该架构由卡内基梅隆大学和普林斯顿大学的研究人员率先提出)整合了选择性状态空间模型(SSM)。这些 SSM 通过维护内部状态来高效管理超长序列。
这些层级随序列长度线性扩展,使其能够处理远超标准自注意力模型的上下文长度,且不产生同等计算开销。
混合Mamba-Transformer设计通过用线性时间状态空间层替代多数注意力层来降低成本。在保持相当准确率的前提下,该方案可在长上下文任务中实现2-3倍的吞吐量提升。
英伟达并非唯一采用此方法的机构;其他人工智能研究实验室(如AI2)也发布了基于Mamba架构的模型。
通过简单指令开启或关闭推理功能
Nemotron-Nano-9B-v2作为统一的纯文本模型,兼具对话交互与复杂推理能力,且完全采用从零开始的训练方式。
默认情况下,系统会在生成最终答案前创建详细推理轨迹。用户可通过/think或/no_think等简单命令令牌控制此行为。
该模型还引入了运行时"思考预算"管理机制,开发者可设定模型进行内部推理的最大令牌数量上限,超出后必须立即给出响应。
该机制旨在平衡准确性与响应延迟,这对客服聊天机器人或自主代理等应用至关重要。
基准测试展现强劲性能
评估结果表明,该模型在准确性方面与其他领先的小型开源模型具有竞争力。在启用推理功能并使用NeMo-Skills测试套件进行测试时,Nemotron-Nano-9B-v2在AIME25、MATH500、GPQA和LiveCodeBench测试中分别取得72.1%、97.8%、64.0%和71.1%的得分。
在指令遵循与长上下文基准测试中同样表现优异:IFEval达90.3%,RULER 128K测试达78.9%,并在BFCL v3及HLE基准测试中取得可量化的额外提升。
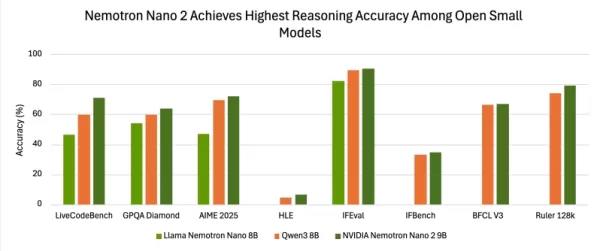
在多项评估中,Nano-9B-v2的准确率始终高于常用对照模型Qwen3-8B。
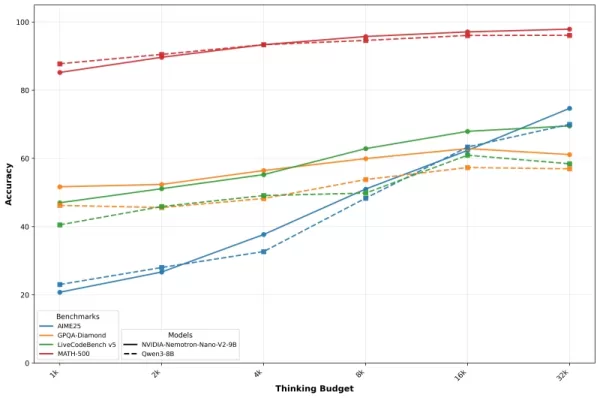
英伟达通过准确率与预算曲线展示这些结果,直观呈现推理令牌配额增加时性能的提升。该公司指出,精确的预算控制使开发者能在生产环境中同时优化质量与速度。
基于合成数据集训练
Nano模型及更广泛的Nemotron-H家族均基于精心筛选的网络数据、专有数据源及合成训练数据混合集进行训练。
训练语料库涵盖通用文本、代码、数学、科学文献、法律及金融文件,以及专注于对齐的问答数据集。
英伟达确认使用其他大型模型生成的合成推理轨迹,以提升复杂基准任务的性能。
许可与商业用途
Nano-9B-v2模型依据英伟达开放模型许可协议发布,该协议最后更新于2025年6月。
该许可协议设计为宽松且企业友好。英伟达明确声明模型开箱即具商业可用性,开发者可自由创建并分发衍生作品。
关键在于,英伟达不主张对模型生成的任何输出内容拥有所有权,所有权利与责任均归属于使用该模型的开发者或组织。
对企业开发者而言,这意味着无需另行协商商业许可协议,也无需根据使用量、营收或用户数量支付费用,即可立即将模型投入生产环境。与其他供应商分层开放许可不同,该协议不含企业规模达到特定门槛即触发付费许可的条款。
不过协议仍包含若干企业需遵守的重要条款:
- 防护机制:用户不得绕过或禁用内置安全机制(即"防护机制"),除非为其特定部署实施了等效替代方案。
- 再分发:模型或其衍生作品的任何再分发行为,必须包含完整的NVIDIA开放模型许可文本及正确署名("由NVIDIA公司根据NVIDIA开放模型许可授权")。
- 合规要求:用户须遵守所有适用的贸易法规与限制,例如美国出口管制法律。
- 可信赖AI条款:使用行为须符合NVIDIA可信赖AI指南,该指南涵盖负责任部署原则及伦理考量。
- 诉讼条款:若用户因模型相关侵权问题对第三方发起版权或专利诉讼,本许可将自动终止。
这些条款侧重于确保法律合规与负责任使用,而非限制商业规模。企业无需为开发产品、服务变现或扩大用户基数向英伟达寻求额外许可或支付版税,但必须确保部署实践符合安全要求、提供正确署名并满足所有合规义务。
市场定位
Nvidia Nemotron-Nano-9B-v2 面向需在小规模部署中平衡推理能力与部署效率的开发者。
其运算预算控制与推理开关功能,旨在赋予系统构建者在精度与响应速度之间灵活权衡的能力。
该模型在Hugging Face和英伟达模型目录的同步上线,彰显了其广泛可及性的战略意图,旨在鼓励实验与集成应用。
Nvidia发布Nemotron-Nano-9B-v2彰显了其在语言模型领域持续聚焦效率与可控推理的战略。
通过融合混合架构与先进压缩及训练技术,英伟达旨在为开发者提供兼顾高精度、低运算成本与低延迟的解决方案。
相关文章
 Gecko Robotics 与 NVIDIA 合作,整合 AI 代理的安全性和控制
Gecko Robotics 正在其检测机器人舰队中利用 NVIDIA 最新的智能体 AI 安全层。来源:Gecko RoboticsNVIDIA 公司今天发布了其开放智能体安全平台(Open Agent Safety Platform),其中包括开源的 OpenShell 软件和 Sentry 参考系统设计。这些工具旨在增强运行 AI 智能体的机器人在硬件、计算和软件层面上的治理与控制。Gecko Robotics Inc. 是与 NVIDIA 技术合作的 100 多家组织之一。在 OpenA
英伟达H200中国交易在特朗普与习近平峰会后得以保留,但结果与预期不符
特朗普总统前往北京,黄仁勋在最后一刻加入了代表团,两天后离京时仅就芯片出口的潜在进展发表了含糊其辞的言论。双方未达成任何协议。自特朗普于2025年12月首次批准销售以来,尚未有一颗英伟达H200芯片进入中国。 美国贸易代表杰米森·格里尔向彭博社证实,半导体限制措施甚至未被列入双边议程。在峰会的盛况之下,隐藏着更重大的转变。H200芯片的供应受阻并非源于华盛顿的拒绝;美国实际上已经批准了出口。 包括
英伟达明年25%的营收将来自其资助的实验室
英伟达已向采购其芯片的人工智能实验室投入近500亿美元,并获得了总额超过5000亿美元的订单承诺。8月26日,首席财务官科莱特·克雷斯向分析师表示,这些由英伟达资产负债表提供支持的实验室,明年将占公司业务总量的约四分之一。这种通常被称为“循环融资”的模式,早在分析师们创造出这个术语之前,英伟达就已经认可了。克雷斯在财报电话会议上指出,虽然公司认识到其支持的规模之大,但对这种安排有不同的看法。该机制
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (1)
0/500
![DanielThomas]()
이 작은 언어 모델 경쟁이 정말 흥미롭네요! Nvidia가 추론 기능을 끄고 켤 수 있는 옵션을 넣은 건 실용적이면서도 재미있는 접근법인 것 같아요. 개인적으로는 이런 경량화 모델들이 스마트워치나 스마트폰 같은 엣지 디바이스에서 어떻게 활용될지 궁금해요. 🤔 AI가 점점 더 일상 속으로 스며들고 있는 느낌이에요.
小型语言模型正掀起波澜。 继麻省理工学院衍生公司Liquid AI推出智能手表尺寸的视觉模型、谷歌推出智能手机适配产品后,英伟达现携精简版竞品Nemotron-Nano-9B-V2入局。该模型在关键基准测试中领跑同类产品,并引入独特功能:用户可启用或禁用AI"推理"机制——这实质是生成最终答案前的自我检查流程。
尽管90亿参数规模仍远超近期报道的数百万参数微型模型,但英伟达强调这是对其原始120亿参数模型的重大优化。该模型经过专门设计,可在单块广泛适用的Nvidia A10 GPU上运行。
英伟达AI模型后训练总监奥列克西·库恰耶夫在X平台回应提问时解释道:"我们将120亿参数模型精简至90亿,使其完美适配主流部署GPU A10。该模型采用混合架构,可处理更大批量数据,运行速度较同等规模传统Transformer模型提升六倍。"
作为参考,当前多数领先的大型语言模型参数规模在700亿以上。参数是定义模型行为的内部设置,数量越高通常意味着更强的能力,但也需要显著更高的计算资源。
该模型支持英语、德语、西班牙语、法语、意大利语和日语等多语言处理,扩展能力还涵盖韩语、葡萄牙语、俄语及中文。其适用场景广泛,从执行指令到代码生成皆能胜任。
Nemotron-Nano-9B-V2及其预训练数据集现已登陆Hugging Face平台,并可通过英伟达自有模型目录获取。
融合Transformer与Mamba架构
该模型基于Nemotron-H构建,该系列混合Mamba-Transformer模型是英伟达最新AI产品的基础架构。
主流大型语言模型通常仅依赖Transformer架构及其注意力机制,但随着输入序列长度增加,这种架构在内存和计算成本方面会变得极其昂贵。
Nemotron-H 模型及其他采用 Mamba 架构的模型(该架构由卡内基梅隆大学和普林斯顿大学的研究人员率先提出)整合了选择性状态空间模型(SSM)。这些 SSM 通过维护内部状态来高效管理超长序列。
这些层级随序列长度线性扩展,使其能够处理远超标准自注意力模型的上下文长度,且不产生同等计算开销。
混合Mamba-Transformer设计通过用线性时间状态空间层替代多数注意力层来降低成本。在保持相当准确率的前提下,该方案可在长上下文任务中实现2-3倍的吞吐量提升。
英伟达并非唯一采用此方法的机构;其他人工智能研究实验室(如AI2)也发布了基于Mamba架构的模型。
通过简单指令开启或关闭推理功能
Nemotron-Nano-9B-v2作为统一的纯文本模型,兼具对话交互与复杂推理能力,且完全采用从零开始的训练方式。
默认情况下,系统会在生成最终答案前创建详细推理轨迹。用户可通过/think或/no_think等简单命令令牌控制此行为。
该模型还引入了运行时"思考预算"管理机制,开发者可设定模型进行内部推理的最大令牌数量上限,超出后必须立即给出响应。
该机制旨在平衡准确性与响应延迟,这对客服聊天机器人或自主代理等应用至关重要。
基准测试展现强劲性能
评估结果表明,该模型在准确性方面与其他领先的小型开源模型具有竞争力。在启用推理功能并使用NeMo-Skills测试套件进行测试时,Nemotron-Nano-9B-v2在AIME25、MATH500、GPQA和LiveCodeBench测试中分别取得72.1%、97.8%、64.0%和71.1%的得分。
在指令遵循与长上下文基准测试中同样表现优异:IFEval达90.3%,RULER 128K测试达78.9%,并在BFCL v3及HLE基准测试中取得可量化的额外提升。
在多项评估中,Nano-9B-v2的准确率始终高于常用对照模型Qwen3-8B。
英伟达通过准确率与预算曲线展示这些结果,直观呈现推理令牌配额增加时性能的提升。该公司指出,精确的预算控制使开发者能在生产环境中同时优化质量与速度。
基于合成数据集训练
Nano模型及更广泛的Nemotron-H家族均基于精心筛选的网络数据、专有数据源及合成训练数据混合集进行训练。
训练语料库涵盖通用文本、代码、数学、科学文献、法律及金融文件,以及专注于对齐的问答数据集。
英伟达确认使用其他大型模型生成的合成推理轨迹,以提升复杂基准任务的性能。
许可与商业用途
Nano-9B-v2模型依据英伟达开放模型许可协议发布,该协议最后更新于2025年6月。
该许可协议设计为宽松且企业友好。英伟达明确声明模型开箱即具商业可用性,开发者可自由创建并分发衍生作品。
关键在于,英伟达不主张对模型生成的任何输出内容拥有所有权,所有权利与责任均归属于使用该模型的开发者或组织。
对企业开发者而言,这意味着无需另行协商商业许可协议,也无需根据使用量、营收或用户数量支付费用,即可立即将模型投入生产环境。与其他供应商分层开放许可不同,该协议不含企业规模达到特定门槛即触发付费许可的条款。
不过协议仍包含若干企业需遵守的重要条款:
- 防护机制:用户不得绕过或禁用内置安全机制(即"防护机制"),除非为其特定部署实施了等效替代方案。
- 再分发:模型或其衍生作品的任何再分发行为,必须包含完整的NVIDIA开放模型许可文本及正确署名("由NVIDIA公司根据NVIDIA开放模型许可授权")。
- 合规要求:用户须遵守所有适用的贸易法规与限制,例如美国出口管制法律。
- 可信赖AI条款:使用行为须符合NVIDIA可信赖AI指南,该指南涵盖负责任部署原则及伦理考量。
- 诉讼条款:若用户因模型相关侵权问题对第三方发起版权或专利诉讼,本许可将自动终止。
这些条款侧重于确保法律合规与负责任使用,而非限制商业规模。企业无需为开发产品、服务变现或扩大用户基数向英伟达寻求额外许可或支付版税,但必须确保部署实践符合安全要求、提供正确署名并满足所有合规义务。
市场定位
Nvidia Nemotron-Nano-9B-v2 面向需在小规模部署中平衡推理能力与部署效率的开发者。
其运算预算控制与推理开关功能,旨在赋予系统构建者在精度与响应速度之间灵活权衡的能力。
该模型在Hugging Face和英伟达模型目录的同步上线,彰显了其广泛可及性的战略意图,旨在鼓励实验与集成应用。
Nvidia发布Nemotron-Nano-9B-v2彰显了其在语言模型领域持续聚焦效率与可控推理的战略。
通过融合混合架构与先进压缩及训练技术,英伟达旨在为开发者提供兼顾高精度、低运算成本与低延迟的解决方案。








 Gecko Robotics 与 NVIDIA 合作,整合 AI 代理的安全性和控制
Gecko Robotics 正在其检测机器人舰队中利用 NVIDIA 最新的智能体 AI 安全层。来源:Gecko RoboticsNVIDIA 公司今天发布了其开放智能体安全平台(Open Agent Safety Platform),其中包括开源的 OpenShell 软件和 Sentry 参考系统设计。这些工具旨在增强运行 AI 智能体的机器人在硬件、计算和软件层面上的治理与控制。Gecko Robotics Inc. 是与 NVIDIA 技术合作的 100 多家组织之一。在 OpenA
 英伟达H200中国交易在特朗普与习近平峰会后得以保留,但结果与预期不符
特朗普总统前往北京,黄仁勋在最后一刻加入了代表团,两天后离京时仅就芯片出口的潜在进展发表了含糊其辞的言论。双方未达成任何协议。自特朗普于2025年12月首次批准销售以来,尚未有一颗英伟达H200芯片进入中国。 美国贸易代表杰米森·格里尔向彭博社证实,半导体限制措施甚至未被列入双边议程。在峰会的盛况之下,隐藏着更重大的转变。H200芯片的供应受阻并非源于华盛顿的拒绝;美国实际上已经批准了出口。 包括
 英伟达明年25%的营收将来自其资助的实验室
英伟达已向采购其芯片的人工智能实验室投入近500亿美元,并获得了总额超过5000亿美元的订单承诺。8月26日,首席财务官科莱特·克雷斯向分析师表示,这些由英伟达资产负债表提供支持的实验室,明年将占公司业务总量的约四分之一。这种通常被称为“循环融资”的模式,早在分析师们创造出这个术语之前,英伟达就已经认可了。克雷斯在财报电话会议上指出,虽然公司认识到其支持的规模之大,但对这种安排有不同的看法。该机制

2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai

2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai

2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai

2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai

2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai

2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

이 작은 언어 모델 경쟁이 정말 흥미롭네요! Nvidia가 추론 기능을 끄고 켤 수 있는 옵션을 넣은 건 실용적이면서도 재미있는 접근법인 것 같아요. 개인적으로는 이런 경량화 모델들이 스마트워치나 스마트폰 같은 엣지 디바이스에서 어떻게 활용될지 궁금해요. 🤔 AI가 점점 더 일상 속으로 스며들고 있는 느낌이에요.












