


 家
Nvidia、トグル可能な推論機能を備えたオープンソースAIモデル「Nemotron-Nano-9B-v2」を発表
小型言語モデルが注目を集めている。 MITスピンオフ企業Liquid AIのスマートウォッチサイズ視覚モデルやGoogleのスマートフォン対応モデルの登場に続き、Nvidiaも独自の軽量モデル「Nemotron-Nano-9B-V2」で参入した。この新モデルは主要ベンチマークで同クラスをリードし、AIの「推論」機能(最終回答前の自己チェックプロセス)をユーザーが有効/無効にできる独自機能を導入している。
90億パラメータは、最近報じられた数百万パラメータのマイクロモデル規模を上回るものの、NVIDIAはこれを当初の120億パラメータからの大幅な最適化と位置付けている。この改訂サイズは、単一の汎用NVIDIA A10 GPU上で動作するよう特別に設計されている。
NVIDIAのAIモデルポストトレーニング担当ディレクター、オレクシー・クチアエフ氏はXでの質問に対し次のように説明している:「120億パラメータモデルを90億に削減し、普及しているデプロイ用GPUであるA10に完全に適合させました。ハイブリッドアーキテクチャを採用しているため、より大きなバッチサイズを処理可能で、同規模の従来型トランスフォーマーモデルと比較して最大6倍の速度を達成します」
参考までに、多くの主要大規模言語モデルは700億以上のパラメータで動作します。パラメータとはモデルの動作を定義する内部設定であり、通常は数が多いほど能力が高いことを示しますが、同時に大幅な計算能力も必要とします。
本モデルは英語、ドイツ語、スペイン語、フランス語、イタリア語、日本語を含む複数言語に対応。拡張機能により韓国語、ポルトガル語、ロシア語、中国語もカバーする。指示の遂行からコード生成まで幅広いタスクに適している。
Nemotron-Nano-9B-V2およびその事前学習データセットは現在、Hugging FaceおよびNvidiaの自社モデルカタログを通じて利用可能です。
トランスフォーマーとマンバアーキテクチャの融合
このモデルは、Nvidiaの最新AI製品の基盤となるハイブリッドMamba-Transformerモデル群であるNemotron-Hを基盤として構築されています。
主流のLLMは通常、Transformerアーキテクチャとその注意機構のみに依存していますが、入力シーケンスの長さが増すにつれて、メモリと計算の面で非常に高価になる可能性があります。
カーネギーメロン大学およびプリンストン大学の研究者によって開発された Mamba アーキテクチャを利用した Nemotron-H モデルなどは、選択的状態空間モデル (SSM) を組み込んでいます。これらの SSM は、内部状態を維持することで、非常に長いシーケンスを効率的に管理します。
これらの層はシーケンス長に比例してスケーリングするため、標準的な自己注意機構と同等の計算オーバーヘッドなしに、はるかに長いコンテキストを処理できる。
ハイブリッドなマンバ-トランスフォーマー設計では、ほとんどの注意層を線形時間の状態空間層に置き換えることでコストを削減します。これにより、同等の精度を維持しながら、長い文脈を必要とするタスクにおいて最大2~3倍のスループット向上が可能です。
このアプローチはNvidiaだけのものではありません。AI2などの他のAI研究所も、マンバアーキテクチャに基づくモデルをリリースしています。
シンプルなコマンドで推論のオン/オフを切り替え
Nemotron-Nano-9B-v2は、会話型インタラクションと複雑な推論の両方を可能とする統一的なテキスト専用モデルとして設計され、完全にゼロから訓練されています。
デフォルトでは、システムは最終回答を生成する前に詳細な推論トレースを生成します。ユーザーは/thinkや/no_thinkといったシンプルなコマンドトークンでこの動作を制御できます。
また、このモデルは実行時の「推論予算」管理機能を導入しています。これにより開発者は、モデルが応答を返す前に内部推論に使用できるトークン数の上限を設定できます。
この仕組みは、顧客サポートチャットボットや自律エージェントなどのアプリケーションにおいて極めて重要な、応答遅延と精度のバランスを取ることを目的としています。
ベンチマークで示された高い性能
評価結果では、他の主要な小規模オープンモデルと競合する精度が実証されています。NeMo-Skillsスイートを用いた推論有効時のテストでは、Nemotron-Nano-9B-v2はAIME25で72.1%、MATH500で97.8%、GPQAで64.0%、LiveCodeBenchで71.1%のスコアを達成しました。
指示順守および長文脈ベンチマークでも高いスコアを記録:IFEvalで90.3%、RULER 128Kテストで78.9%を達成し、BFCL v3およびHLEベンチマークでも測定可能な改善が見られました。
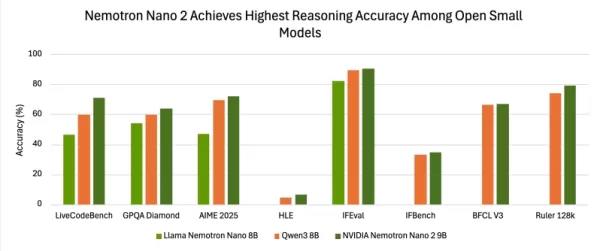
複数の評価において、Nano-9B-v2は比較対象として一般的なQwen3-8Bモデルよりも一貫して高い精度を示しています。
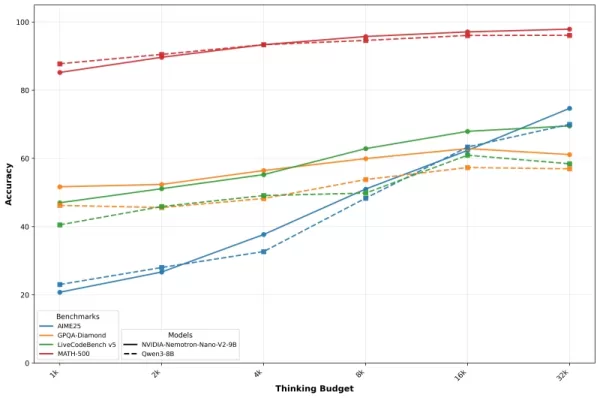
Nvidia は、推論に割り当てられるトークン数が増えるにつれてパフォーマンスが向上することを示す、精度対予算の曲線を用いてこれらの結果を発表しています。同社は、慎重な予算管理により、開発者は実稼働環境において品質と速度の両方を最適化できると述べています。
合成データセットで訓練
Nanoモデルとより広範なNemotron-Hファミリーの両方は、慎重に精選されたウェブデータ、独自ソース、合成トレーニングデータの混合で訓練されています。
トレーニングコーパスには、一般テキスト、コード、数学、科学文献、法律・金融文書に加え、アライメントに焦点を当てた質問応答データセットが含まれる。
Nvidia は、複雑なベンチマークタスクのパフォーマンス向上のために、他の大規模モデルによって生成された合成推論トレースの使用を確認しています。
ライセンスおよび商用利用
Nano-9B-v2モデルは、2025年6月に最終更新されたNvidiaオープンモデルライセンス契約に基づき公開されています。
このライセンスは寛容で企業向けであることを意図しています。Nvidiaは、モデルがそのまま商用利用可能であり、開発者が派生作品の作成と配布を自由にできることを明示しています。
重要な点として、Nvidiaはモデルが生成する出力物に対する所有権を一切主張せず、すべての権利と責任はモデルを利用する開発者または組織に帰属します。
企業開発者にとって、これは別途商用ライセンスを交渉したり、使用量・収益・ユーザー数に基づく料金を支払うことなく、モデルを即座に本番環境に展開できることを意味します。他プロバイダーの段階的オープンライセンスとは異なり、企業が一定規模に達した際に有料ライセンスを義務付ける条項は存在しません。
ただし、本契約には企業が遵守すべき重要な条件がいくつか含まれています:
- ガードレール:ユーザーは、特定の導入環境向けに適切かつ同等の代替手段を実装しない限り、組み込みの安全機構(「ガードレール」と呼ばれる)をバイパスまたは無効化できません。
- 再配布:モデルまたはその派生作品の再配布には、Nvidia Open Model Licenseの全文と適切な帰属表示(「Nvidia CorporationよりNvidia Open Model Licenseに基づきライセンス供与」)を含める必要があります。
- コンプライアンス:ユーザーは、米国輸出管理法など、適用されるすべての貿易規制および制限を遵守しなければなりません。
- 信頼できるAIに関する条項:使用は、責任ある導入と倫理的配慮に関する原則を網羅するNvidiaの信頼できるAIガイドラインに準拠しなければなりません。
- 訴訟条項:ユーザーがモデルに関連する侵害を主張して他者に対して著作権または特許訴訟を提起した場合、本ライセンスは自動的に終了します。
これらの条件は、商業規模を制限するのではなく、法的コンプライアンスと責任ある利用の確保に重点を置いています。企業は、製品開発、サービスの収益化、ユーザーベースの拡大について、Nvidiaに追加の許可を求める必要も、ロイヤルティを支払う必要もありません。代わりに、導入方法が安全性を尊重し、適切な帰属表示を行い、すべてのコンプライアンス義務を満たしていることを確認する必要があります。
市場ポジショニング
Nvidiaは、小規模な環境において推論能力と導入効率のバランスを必要とする開発者を、Nemotron-Nano-9B-v2のターゲットとしています。
ランタイム予算制御と推論切り替え機能は、システム構築者が精度と応答速度のトレードオフをより柔軟に管理できるように設計されています。
Hugging Face および Nvidia のモデルカタログでの提供開始は、幅広いアクセシビリティと実験・統合の促進を意図したものです。
NvidiaによるNemotron-Nano-9B-v2のリリースは、言語モデルにおける効率性と制御可能な推論への同社の継続的な注力を強調しています。
ハイブリッドアーキテクチャと高度な圧縮・トレーニング技術を融合させることで、Nvidiaは運用コストとレイテンシを削減しつつ高精度を維持するツールを開発者に提供することを目指しています。
関連記事
 OneRail、NvidiaのAIを活用してリアルタイムのラストマイル配送を最適化
OneRailは、Nvidiaの技術を活用したAI駆動型の配送プラットフォームを導入し、小売業者、卸売業者、流通業者が個々の注文に対して最も効率的な配送方法を決定できるよう支援しています。OneRailによると、OmniSTARと名付けられたこのシステムは、自社保有の車両、宅配業者、小包配送サービス、その他の物流手段など、さまざまな配送チャネルを評価し、サービスレベル契約(SLA)を満たしつつ、最
アップルの新ハードウェア責任者ジョン・テルヌスが、将来製品のビジョンを牽引
プレイヤーを読み込み中…Appleにおけるターナス時代が正式に始まった。ティム・クックは先週CEOを退任し、リーダーシップを元ハードウェア担当シニアバイスプレジデントのジョン・ターナスに委ねた。ターナスの最初の社内文書には「来週、大きな発表がある」と記されており、これは次のiPhoneイベントが、彼が完全に業務に慣れる前に彼の机の上に届くことを意味している。ただし、クックは姿を消すわけではない:彼は最高経営責任者(CEO)から最高経営責任者会議議長(Executive Chairman)に転
Groq、AIチップからネオクラウドへの転換を加速するため3億5000万ドルの資金調達を実施
AIインフラ企業Groqは、3億5000万ドルの新たな資金調達を完了し、専門的なチップ開発者から、堅牢なGPUおよびAIインフラサービスを提供するネオクラウドプロバイダーへの移行を継続していることを示した。Disruptive Technologiesの支援を受け、Nvidiaの参加も予想される最新ラウンドにより、Groqの企業価値は35億ドルと評価された。この金額は、Nvidiaがスタートアップの創設者兼CEOであるJonathan Rossおよび主要なチームメンバーをライセンス契約を通じて
関連特集おすすめ
チャットボット
 言語練習、面接対策、そして日常の流暢さのための最高のAIロールプレイチャットアプリ
2026年最新版・最高評価のAIロールプレイチャットアプリ|語学練習、面接対策、日常会話の流暢さ向上に!XIX.AIは、無料と有料の比較、実世界でのテスト、毎週更新されるランキングを提供する革新的なコレクションを厳選しています。これらの必須ツールは、ライティングスキルの向上、流暢さの課題克服、そしてあらゆる日常シナリオにおけるコミュニケーション効率の改善をサポートします。今すぐ探索して、あなたの言語成長に最適なツールを見つけましょう!
 10 ツール
 xix.ai
作曲
リミックス制作、サンプリングの準備、カラオケマスター作成のためのAIステム分離ツール
2026年最新・最高評価のAIステム分離ツール。リミックス制作、サンプリング準備、カラオケマスター向けに厳選されました。これらの強力で画期的なツールは、実環境でのテストを経て、正確なオーディオ分離を実現し、生産性を大幅に向上させます。 XIX.AIでは、ニーズに合った「必試」のソリューションを見つけるお手伝いをするため、無料版と有料版の比較ガイドを毎週更新して提供しています。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
データ分析
収益ダッシュボード、ファネル分析、および製品指標向けのAI SQLコピロット
2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai
作曲
曲のドラフト作成に最適なAIメロディ作成ツール
2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai
チャットボット
面接練習用のベストなAI会話トレーニングツール
2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai
デザインとアート
クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

 コメント (1)
0/500
![DanielThomas]()
이 작은 언어 모델 경쟁이 정말 흥미롭네요! Nvidia가 추론 기능을 끄고 켤 수 있는 옵션을 넣은 건 실용적이면서도 재미있는 접근법인 것 같아요. 개인적으로는 이런 경량화 모델들이 스마트워치나 스마트폰 같은 엣지 디바이스에서 어떻게 활용될지 궁금해요. 🤔 AI가 점점 더 일상 속으로 스며들고 있는 느낌이에요.
小型言語モデルが注目を集めている。 MITスピンオフ企業Liquid AIのスマートウォッチサイズ視覚モデルやGoogleのスマートフォン対応モデルの登場に続き、Nvidiaも独自の軽量モデル「Nemotron-Nano-9B-V2」で参入した。この新モデルは主要ベンチマークで同クラスをリードし、AIの「推論」機能(最終回答前の自己チェックプロセス)をユーザーが有効/無効にできる独自機能を導入している。
90億パラメータは、最近報じられた数百万パラメータのマイクロモデル規模を上回るものの、NVIDIAはこれを当初の120億パラメータからの大幅な最適化と位置付けている。この改訂サイズは、単一の汎用NVIDIA A10 GPU上で動作するよう特別に設計されている。
NVIDIAのAIモデルポストトレーニング担当ディレクター、オレクシー・クチアエフ氏はXでの質問に対し次のように説明している:「120億パラメータモデルを90億に削減し、普及しているデプロイ用GPUであるA10に完全に適合させました。ハイブリッドアーキテクチャを採用しているため、より大きなバッチサイズを処理可能で、同規模の従来型トランスフォーマーモデルと比較して最大6倍の速度を達成します」
参考までに、多くの主要大規模言語モデルは700億以上のパラメータで動作します。パラメータとはモデルの動作を定義する内部設定であり、通常は数が多いほど能力が高いことを示しますが、同時に大幅な計算能力も必要とします。
本モデルは英語、ドイツ語、スペイン語、フランス語、イタリア語、日本語を含む複数言語に対応。拡張機能により韓国語、ポルトガル語、ロシア語、中国語もカバーする。指示の遂行からコード生成まで幅広いタスクに適している。
Nemotron-Nano-9B-V2およびその事前学習データセットは現在、Hugging FaceおよびNvidiaの自社モデルカタログを通じて利用可能です。
トランスフォーマーとマンバアーキテクチャの融合
このモデルは、Nvidiaの最新AI製品の基盤となるハイブリッドMamba-Transformerモデル群であるNemotron-Hを基盤として構築されています。
主流のLLMは通常、Transformerアーキテクチャとその注意機構のみに依存していますが、入力シーケンスの長さが増すにつれて、メモリと計算の面で非常に高価になる可能性があります。
カーネギーメロン大学およびプリンストン大学の研究者によって開発された Mamba アーキテクチャを利用した Nemotron-H モデルなどは、選択的状態空間モデル (SSM) を組み込んでいます。これらの SSM は、内部状態を維持することで、非常に長いシーケンスを効率的に管理します。
これらの層はシーケンス長に比例してスケーリングするため、標準的な自己注意機構と同等の計算オーバーヘッドなしに、はるかに長いコンテキストを処理できる。
ハイブリッドなマンバ-トランスフォーマー設計では、ほとんどの注意層を線形時間の状態空間層に置き換えることでコストを削減します。これにより、同等の精度を維持しながら、長い文脈を必要とするタスクにおいて最大2~3倍のスループット向上が可能です。
このアプローチはNvidiaだけのものではありません。AI2などの他のAI研究所も、マンバアーキテクチャに基づくモデルをリリースしています。
シンプルなコマンドで推論のオン/オフを切り替え
Nemotron-Nano-9B-v2は、会話型インタラクションと複雑な推論の両方を可能とする統一的なテキスト専用モデルとして設計され、完全にゼロから訓練されています。
デフォルトでは、システムは最終回答を生成する前に詳細な推論トレースを生成します。ユーザーは/thinkや/no_thinkといったシンプルなコマンドトークンでこの動作を制御できます。
また、このモデルは実行時の「推論予算」管理機能を導入しています。これにより開発者は、モデルが応答を返す前に内部推論に使用できるトークン数の上限を設定できます。
この仕組みは、顧客サポートチャットボットや自律エージェントなどのアプリケーションにおいて極めて重要な、応答遅延と精度のバランスを取ることを目的としています。
ベンチマークで示された高い性能
評価結果では、他の主要な小規模オープンモデルと競合する精度が実証されています。NeMo-Skillsスイートを用いた推論有効時のテストでは、Nemotron-Nano-9B-v2はAIME25で72.1%、MATH500で97.8%、GPQAで64.0%、LiveCodeBenchで71.1%のスコアを達成しました。
指示順守および長文脈ベンチマークでも高いスコアを記録:IFEvalで90.3%、RULER 128Kテストで78.9%を達成し、BFCL v3およびHLEベンチマークでも測定可能な改善が見られました。
複数の評価において、Nano-9B-v2は比較対象として一般的なQwen3-8Bモデルよりも一貫して高い精度を示しています。
Nvidia は、推論に割り当てられるトークン数が増えるにつれてパフォーマンスが向上することを示す、精度対予算の曲線を用いてこれらの結果を発表しています。同社は、慎重な予算管理により、開発者は実稼働環境において品質と速度の両方を最適化できると述べています。
合成データセットで訓練
Nanoモデルとより広範なNemotron-Hファミリーの両方は、慎重に精選されたウェブデータ、独自ソース、合成トレーニングデータの混合で訓練されています。
トレーニングコーパスには、一般テキスト、コード、数学、科学文献、法律・金融文書に加え、アライメントに焦点を当てた質問応答データセットが含まれる。
Nvidia は、複雑なベンチマークタスクのパフォーマンス向上のために、他の大規模モデルによって生成された合成推論トレースの使用を確認しています。
ライセンスおよび商用利用
Nano-9B-v2モデルは、2025年6月に最終更新されたNvidiaオープンモデルライセンス契約に基づき公開されています。
このライセンスは寛容で企業向けであることを意図しています。Nvidiaは、モデルがそのまま商用利用可能であり、開発者が派生作品の作成と配布を自由にできることを明示しています。
重要な点として、Nvidiaはモデルが生成する出力物に対する所有権を一切主張せず、すべての権利と責任はモデルを利用する開発者または組織に帰属します。
企業開発者にとって、これは別途商用ライセンスを交渉したり、使用量・収益・ユーザー数に基づく料金を支払うことなく、モデルを即座に本番環境に展開できることを意味します。他プロバイダーの段階的オープンライセンスとは異なり、企業が一定規模に達した際に有料ライセンスを義務付ける条項は存在しません。
ただし、本契約には企業が遵守すべき重要な条件がいくつか含まれています:
- ガードレール:ユーザーは、特定の導入環境向けに適切かつ同等の代替手段を実装しない限り、組み込みの安全機構(「ガードレール」と呼ばれる)をバイパスまたは無効化できません。
- 再配布:モデルまたはその派生作品の再配布には、Nvidia Open Model Licenseの全文と適切な帰属表示(「Nvidia CorporationよりNvidia Open Model Licenseに基づきライセンス供与」)を含める必要があります。
- コンプライアンス:ユーザーは、米国輸出管理法など、適用されるすべての貿易規制および制限を遵守しなければなりません。
- 信頼できるAIに関する条項:使用は、責任ある導入と倫理的配慮に関する原則を網羅するNvidiaの信頼できるAIガイドラインに準拠しなければなりません。
- 訴訟条項:ユーザーがモデルに関連する侵害を主張して他者に対して著作権または特許訴訟を提起した場合、本ライセンスは自動的に終了します。
これらの条件は、商業規模を制限するのではなく、法的コンプライアンスと責任ある利用の確保に重点を置いています。企業は、製品開発、サービスの収益化、ユーザーベースの拡大について、Nvidiaに追加の許可を求める必要も、ロイヤルティを支払う必要もありません。代わりに、導入方法が安全性を尊重し、適切な帰属表示を行い、すべてのコンプライアンス義務を満たしていることを確認する必要があります。
市場ポジショニング
Nvidiaは、小規模な環境において推論能力と導入効率のバランスを必要とする開発者を、Nemotron-Nano-9B-v2のターゲットとしています。
ランタイム予算制御と推論切り替え機能は、システム構築者が精度と応答速度のトレードオフをより柔軟に管理できるように設計されています。
Hugging Face および Nvidia のモデルカタログでの提供開始は、幅広いアクセシビリティと実験・統合の促進を意図したものです。
NvidiaによるNemotron-Nano-9B-v2のリリースは、言語モデルにおける効率性と制御可能な推論への同社の継続的な注力を強調しています。
ハイブリッドアーキテクチャと高度な圧縮・トレーニング技術を融合させることで、Nvidiaは運用コストとレイテンシを削減しつつ高精度を維持するツールを開発者に提供することを目指しています。








 OneRail、NvidiaのAIを活用してリアルタイムのラストマイル配送を最適化
OneRailは、Nvidiaの技術を活用したAI駆動型の配送プラットフォームを導入し、小売業者、卸売業者、流通業者が個々の注文に対して最も効率的な配送方法を決定できるよう支援しています。OneRailによると、OmniSTARと名付けられたこのシステムは、自社保有の車両、宅配業者、小包配送サービス、その他の物流手段など、さまざまな配送チャネルを評価し、サービスレベル契約(SLA)を満たしつつ、最
 アップルの新ハードウェア責任者ジョン・テルヌスが、将来製品のビジョンを牽引
プレイヤーを読み込み中…Appleにおけるターナス時代が正式に始まった。ティム・クックは先週CEOを退任し、リーダーシップを元ハードウェア担当シニアバイスプレジデントのジョン・ターナスに委ねた。ターナスの最初の社内文書には「来週、大きな発表がある」と記されており、これは次のiPhoneイベントが、彼が完全に業務に慣れる前に彼の机の上に届くことを意味している。ただし、クックは姿を消すわけではない:彼は最高経営責任者(CEO)から最高経営責任者会議議長(Executive Chairman)に転
 Groq、AIチップからネオクラウドへの転換を加速するため3億5000万ドルの資金調達を実施
AIインフラ企業Groqは、3億5000万ドルの新たな資金調達を完了し、専門的なチップ開発者から、堅牢なGPUおよびAIインフラサービスを提供するネオクラウドプロバイダーへの移行を継続していることを示した。Disruptive Technologiesの支援を受け、Nvidiaの参加も予想される最新ラウンドにより、Groqの企業価値は35億ドルと評価された。この金額は、Nvidiaがスタートアップの創設者兼CEOであるJonathan Rossおよび主要なチームメンバーをライセンス契約を通じて

2026年最新版・最高評価のAIロールプレイチャットアプリ|語学練習、面接対策、日常会話の流暢さ向上に!XIX.AIは、無料と有料の比較、実世界でのテスト、毎週更新されるランキングを提供する革新的なコレクションを厳選しています。これらの必須ツールは、ライティングスキルの向上、流暢さの課題克服、そしてあらゆる日常シナリオにおけるコミュニケーション効率の改善をサポートします。今すぐ探索して、あなたの言語成長に最適なツールを見つけましょう!
10 ツール
xix.ai

2026年最新・最高評価のAIステム分離ツール。リミックス制作、サンプリング準備、カラオケマスター向けに厳選されました。これらの強力で画期的なツールは、実環境でのテストを経て、正確なオーディオ分離を実現し、生産性を大幅に向上させます。 XIX.AIでは、ニーズに合った「必試」のソリューションを見つけるお手伝いをするため、無料版と有料版の比較ガイドを毎週更新して提供しています。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai

2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai

2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

이 작은 언어 모델 경쟁이 정말 흥미롭네요! Nvidia가 추론 기능을 끄고 켤 수 있는 옵션을 넣은 건 실용적이면서도 재미있는 접근법인 것 같아요. 개인적으로는 이런 경량화 모델들이 스마트워치나 스마트폰 같은 엣지 디바이스에서 어떻게 활용될지 궁금해요. 🤔 AI가 점점 더 일상 속으로 스며들고 있는 느낌이에요.












