


 首頁
Nvidia 推出具備可切換推理功能的開放原始碼 AI 模型 Nemotron-Nano-9B-v2
小型語言模型正掀起波瀾。 繼麻省理工學院衍生公司Liquid AI推出智慧手錶尺寸的視覺模型,以及Google推出適用於智慧型手機的產品後,Nvidia如今也以精簡版競爭者Nemotron-Nano-9B-V2進軍市場。此新型號在關鍵基準測試中領先同級產品,並引入獨特功能:使用者可啟用或停用AI「推理」機制——此機制實質上是在提供最終答案前進行自我檢查的流程。
儘管90億參數規模仍高於近期報導的數百萬參數微型模型,但Nvidia強調此乃對原始120億參數的重大優化。經重新設計的模型體積,可完美運行於單顆廣泛普及的Nvidia A10 GPU之上。
NVIDIA人工智慧模型後訓練總監Oleksii Kuchiaev在X平台回應提問時解釋:「我們將120億參數模型精簡至90億參數,使其完美適配主流部署GPU A10。此模型採用混合架構,能處理更大批次規模,運算速度較同等規模傳統變壓器模型提升六倍。」
為便於理解,當前多數頂尖大型語言模型參數規模皆達七十億以上。參數即定義模型行為的內部設定,參數數量通常代表更強大的能力,但也需耗費顯著更高的運算資源。
該模型支援多種語言,包含英語、德語、西班牙語、法語、義大利語及日語。擴展功能更涵蓋韓語、葡萄牙語、俄語與中文。其適用範圍廣泛,從執行指令到生成程式碼皆游刃有餘。
Nemotron-Nano-9B-V2及其預訓練資料集現已於Hugging Face平台及Nvidia自有模型目錄開放取得。
融合Transformer與Mamba架構的創新設計
該模型基於 Nemotron-H 架構開發,此系列混合型 Mamba-Transformer 模型構成了 Nvidia 最新 AI 產品線的技術基石。
主流大型語言模型通常僅依賴Transformer架構及其注意力機制,但隨著輸入序列長度增加,此類機制在記憶體與運算成本方面可能變得難以承受。
Nemotron-H 模型及其他採用 Mamba 架構的模型(由卡內基梅隆大學與普林斯頓大學研究人員開創)整合了選擇性狀態空間模型(SSMs)。這些 SSMs 透過維持內部狀態,能有效管理極長序列。
此類層級能隨序列長度線性擴展,使其得以處理遠超標準自關注機制的長上下文,且無需承擔同等運算開銷。
混合式Mamba-Transformer架構透過以線性時間狀態空間層取代多數注意力層,有效降低運算成本。此設計在處理長上下文任務時,可提升2至3倍吞吐量,同時維持相近的準確度。
採用此方法的不僅是Nvidia;其他AI研究實驗室,例如AI2,也發布了基於Mamba架構的模型。
透過簡易指令啟用或停用推理功能
Nemotron-Nano-9B-v2 作為統一的純文本模型,兼具對話互動與複雜推理能力,且完全從零開始訓練。
系統預設會在生成最終答案前產出詳細推理軌跡,使用者可透過 /think 或 /no_think 等簡易指令控制此行為。
該模型同時導入運行時「思考預算」管理機制,允許開發者設定模型進行內部推理時可使用的最大標記數上限,超過此限即必須輸出回應。
此機制旨在平衡準確性與回應延遲,對於客戶支援聊天機器人或自主代理程式等應用至關重要。
基準測試展現強勁表現
評估結果顯示,本模型在準確度方面與其他頂尖小型開放模型不相上下。啟用推理功能並使用NeMo-Skills測試套件時,Nemotron-Nano-9B-v2在AIME25、MATH500、GPQA及LiveCodeBench基準測試中分別取得72.1%、97.8%、64.0%與71.1%的成績。
在指令遵循與長上下文基準測試中同樣表現優異:IFEval達90.3%、RULER 128K測試達78.9%,並在BFCL v3與HLE基準測試中取得可量化的額外提升。
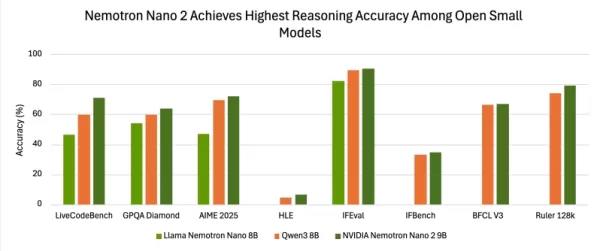
在多項評估中,Nano-9B-v2 的準確度始終高於常見對照模型 Qwen3-8B。
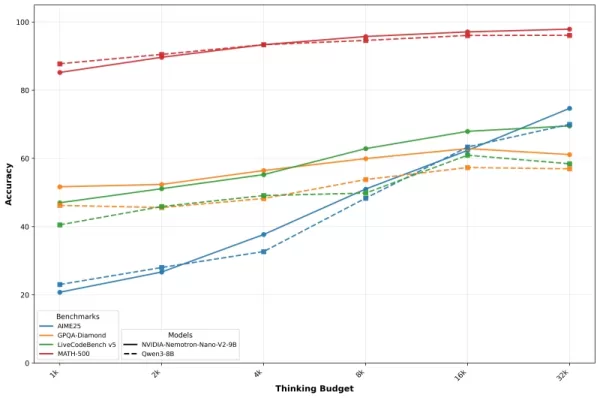
Nvidia透過精準度對預算曲線呈現這些結果,圖表清晰展示隨著推理代幣配額增加,效能如何逐步提升。該公司強調,精細的預算管控使開發者能在生產環境中同時優化品質與速度。
基於合成資料集訓練
Nano模型與更廣泛的Nemotron-H家族皆採用精心彙編的網路資料、專有來源及合成訓練資料混合訓練而成。
訓練語料庫涵蓋通用文本、程式碼、數學、科學文獻、法律與金融文件,以及專注於對齊問題的問答資料集。
Nvidia 確認採用其他大型模型生成的合成推理軌跡,以提升複雜基準任務的執行效能。
授權與商業用途
Nano-9B-v2模型依據Nvidia開放模型授權協議發佈,該協議最後更新於2025年6月。
此授權條款設計為寬鬆且企業友善。Nvidia明確聲明模型可直接商用,開發者可自由創建及分發衍生作品。
關鍵在於,Nvidia 不主張對模型產出內容擁有任何所有權,所有權利與責任均歸屬於使用該模型的開發者或組織。
對企業開發者而言,這意味著模型可立即投入生產環境,無需另行協商商業授權或支付基於使用量、營收或用戶數的費用。與其他供應商的分級開放授權不同,本協議不存在企業規模達標後觸發付費授權的條款。
然而協議仍包含企業必須遵守的幾項重要條款:
- 防護機制:使用者不得繞過或停用內建安全機制(稱為「防護欄」),除非針對其特定部署環境實施合適的等效替代方案。
- 再分發規範:任何模型或衍生作品的再分發行為,必須完整包含NVIDIA開放模型授權條款全文,並標註正確來源歸屬(「經NVIDIA公司依據NVIDIA開放模型授權條款授權」)。
- 合規要求:使用者須遵守所有適用貿易法規與限制,例如美國出口管制法律。
- 可信賴人工智慧條款:使用行為須符合Nvidia可信賴人工智慧指南,該指南涵蓋負責任部署原則與倫理考量。
- 訴訟條款:若使用者針對模型相關侵權行為,對其他方提起著作權或專利訴訟,本授權將自動終止。
這些條款著重確保法律合規與負責任使用,而非限制商業規模。企業無需為產品開發、服務變現或用戶擴展向英偉達申請額外許可或支付版稅,但必須確保部署實踐符合安全規範、提供正確署名並滿足所有合規義務。
市場定位
NVIDIA 推出 Nemotron-Nano-9B-v2,鎖定需在小型規模上平衡推理能力與部署效率的開發者。
其運算預算控制與推理切換功能,旨在賦予系統建構者更大彈性,以管理精準度與回應速度之間的權衡取捨。
該模型現已於Hugging Face及Nvidia模型目錄上架,彰顯其廣泛普及的意圖,旨在鼓勵實驗與整合應用。
Nvidia 推出 Nemotron-Nano-9B-v2,彰顯該公司持續聚焦於語言模型的效能與可控推理能力。
透過融合混合架構與先進壓縮及訓練技術,Nvidia 旨在為開發者提供兼具高精準度、降低運算成本與延遲的解決方案。
相關文章
 OneRail 運用 NVIDIA 人工智慧來優化即時「最後一哩」配送
OneRail 推出了一套採用 Nvidia 技術的人工智慧驅動配送平台,旨在協助零售商、批發商及經銷商為每筆訂單確定最有效的配送方式。據 OneRail 表示,這套名為 OmniSTAR 的系統會評估各種配送管道——包括自有車隊、快遞員、包裹服務及其他物流模式——以找出既符合服務水準協議,又最具成本效益的解決方案。該平台整合了 NVIDIA 的 cuOpt 決策優化引擎與 cuDF 資料處理軟體
蘋果新任硬體主管約翰·特努斯主導未來產品願景
正在載入播放器…蘋果公司的特納斯時代已正式開啟。蒂姆·庫克本週卸任執行長職務,將領導權移交給前硬體負責人約翰·特納斯。特納斯在首份備忘錄中承諾“下週將有一場重磅釋出會”,這意味著下一場iPhone活動將在他尚未完全安頓下來之前就擺在他面前。然而,庫克並未完全隱退:他仍擔任執行主席,專注於政策關係,這些關係最近將一些小問題(如地圖示籤)變成了公眾平衡的難題。這一過渡引發了一個關鍵問題:特納斯時代意味著什麼,股東將給予他多大的空間來應對這一挑戰?在本期TechCrunch的Equity播客
Groq 籌集 3.5 億美元,以推動其從 AI 晶片向“新雲”(neocloud)的戰略轉型
AI基礎設施公司Groq已獲得3.5億美元的新融資,標誌著其從專業晶片開發商向提供強大GPU和AI基礎設施服務的“新雲”提供商的持續轉型。由Disruptive Technologies領投,Nvidia預計也將參與,本輪融資將Groq的估值定為35億美元。這一數字較去年9月Nvidia透過許可協議收購該公司創始人兼執行長Jonathan Ross及核心團隊成員時記錄的69億美元估值大幅下跌。公司發言人向TechCrunch澄清,估值降低並不構成“降價融資”(down round)。相反
相關專題推薦
音樂創作
 最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
 8 個工具
 xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai
會議助理
頂尖 AI 會議摘要工具:清晰追蹤決策與後續行動
2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai
數據分析
最佳人工智慧資料清洗工具:快速處理缺失值與重複資料
2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai

 評論 (1)
0/500
![DanielThomas]()
이 작은 언어 모델 경쟁이 정말 흥미롭네요! Nvidia가 추론 기능을 끄고 켤 수 있는 옵션을 넣은 건 실용적이면서도 재미있는 접근법인 것 같아요. 개인적으로는 이런 경량화 모델들이 스마트워치나 스마트폰 같은 엣지 디바이스에서 어떻게 활용될지 궁금해요. 🤔 AI가 점점 더 일상 속으로 스며들고 있는 느낌이에요.
小型語言模型正掀起波瀾。 繼麻省理工學院衍生公司Liquid AI推出智慧手錶尺寸的視覺模型,以及Google推出適用於智慧型手機的產品後,Nvidia如今也以精簡版競爭者Nemotron-Nano-9B-V2進軍市場。此新型號在關鍵基準測試中領先同級產品,並引入獨特功能:使用者可啟用或停用AI「推理」機制——此機制實質上是在提供最終答案前進行自我檢查的流程。
儘管90億參數規模仍高於近期報導的數百萬參數微型模型,但Nvidia強調此乃對原始120億參數的重大優化。經重新設計的模型體積,可完美運行於單顆廣泛普及的Nvidia A10 GPU之上。
NVIDIA人工智慧模型後訓練總監Oleksii Kuchiaev在X平台回應提問時解釋:「我們將120億參數模型精簡至90億參數,使其完美適配主流部署GPU A10。此模型採用混合架構,能處理更大批次規模,運算速度較同等規模傳統變壓器模型提升六倍。」
為便於理解,當前多數頂尖大型語言模型參數規模皆達七十億以上。參數即定義模型行為的內部設定,參數數量通常代表更強大的能力,但也需耗費顯著更高的運算資源。
該模型支援多種語言,包含英語、德語、西班牙語、法語、義大利語及日語。擴展功能更涵蓋韓語、葡萄牙語、俄語與中文。其適用範圍廣泛,從執行指令到生成程式碼皆游刃有餘。
Nemotron-Nano-9B-V2及其預訓練資料集現已於Hugging Face平台及Nvidia自有模型目錄開放取得。
融合Transformer與Mamba架構的創新設計
該模型基於 Nemotron-H 架構開發,此系列混合型 Mamba-Transformer 模型構成了 Nvidia 最新 AI 產品線的技術基石。
主流大型語言模型通常僅依賴Transformer架構及其注意力機制,但隨著輸入序列長度增加,此類機制在記憶體與運算成本方面可能變得難以承受。
Nemotron-H 模型及其他採用 Mamba 架構的模型(由卡內基梅隆大學與普林斯頓大學研究人員開創)整合了選擇性狀態空間模型(SSMs)。這些 SSMs 透過維持內部狀態,能有效管理極長序列。
此類層級能隨序列長度線性擴展,使其得以處理遠超標準自關注機制的長上下文,且無需承擔同等運算開銷。
混合式Mamba-Transformer架構透過以線性時間狀態空間層取代多數注意力層,有效降低運算成本。此設計在處理長上下文任務時,可提升2至3倍吞吐量,同時維持相近的準確度。
採用此方法的不僅是Nvidia;其他AI研究實驗室,例如AI2,也發布了基於Mamba架構的模型。
透過簡易指令啟用或停用推理功能
Nemotron-Nano-9B-v2 作為統一的純文本模型,兼具對話互動與複雜推理能力,且完全從零開始訓練。
系統預設會在生成最終答案前產出詳細推理軌跡,使用者可透過 /think 或 /no_think 等簡易指令控制此行為。
該模型同時導入運行時「思考預算」管理機制,允許開發者設定模型進行內部推理時可使用的最大標記數上限,超過此限即必須輸出回應。
此機制旨在平衡準確性與回應延遲,對於客戶支援聊天機器人或自主代理程式等應用至關重要。
基準測試展現強勁表現
評估結果顯示,本模型在準確度方面與其他頂尖小型開放模型不相上下。啟用推理功能並使用NeMo-Skills測試套件時,Nemotron-Nano-9B-v2在AIME25、MATH500、GPQA及LiveCodeBench基準測試中分別取得72.1%、97.8%、64.0%與71.1%的成績。
在指令遵循與長上下文基準測試中同樣表現優異:IFEval達90.3%、RULER 128K測試達78.9%,並在BFCL v3與HLE基準測試中取得可量化的額外提升。
在多項評估中,Nano-9B-v2 的準確度始終高於常見對照模型 Qwen3-8B。
Nvidia透過精準度對預算曲線呈現這些結果,圖表清晰展示隨著推理代幣配額增加,效能如何逐步提升。該公司強調,精細的預算管控使開發者能在生產環境中同時優化品質與速度。
基於合成資料集訓練
Nano模型與更廣泛的Nemotron-H家族皆採用精心彙編的網路資料、專有來源及合成訓練資料混合訓練而成。
訓練語料庫涵蓋通用文本、程式碼、數學、科學文獻、法律與金融文件,以及專注於對齊問題的問答資料集。
Nvidia 確認採用其他大型模型生成的合成推理軌跡,以提升複雜基準任務的執行效能。
授權與商業用途
Nano-9B-v2模型依據Nvidia開放模型授權協議發佈,該協議最後更新於2025年6月。
此授權條款設計為寬鬆且企業友善。Nvidia明確聲明模型可直接商用,開發者可自由創建及分發衍生作品。
關鍵在於,Nvidia 不主張對模型產出內容擁有任何所有權,所有權利與責任均歸屬於使用該模型的開發者或組織。
對企業開發者而言,這意味著模型可立即投入生產環境,無需另行協商商業授權或支付基於使用量、營收或用戶數的費用。與其他供應商的分級開放授權不同,本協議不存在企業規模達標後觸發付費授權的條款。
然而協議仍包含企業必須遵守的幾項重要條款:
- 防護機制:使用者不得繞過或停用內建安全機制(稱為「防護欄」),除非針對其特定部署環境實施合適的等效替代方案。
- 再分發規範:任何模型或衍生作品的再分發行為,必須完整包含NVIDIA開放模型授權條款全文,並標註正確來源歸屬(「經NVIDIA公司依據NVIDIA開放模型授權條款授權」)。
- 合規要求:使用者須遵守所有適用貿易法規與限制,例如美國出口管制法律。
- 可信賴人工智慧條款:使用行為須符合Nvidia可信賴人工智慧指南,該指南涵蓋負責任部署原則與倫理考量。
- 訴訟條款:若使用者針對模型相關侵權行為,對其他方提起著作權或專利訴訟,本授權將自動終止。
這些條款著重確保法律合規與負責任使用,而非限制商業規模。企業無需為產品開發、服務變現或用戶擴展向英偉達申請額外許可或支付版稅,但必須確保部署實踐符合安全規範、提供正確署名並滿足所有合規義務。
市場定位
NVIDIA 推出 Nemotron-Nano-9B-v2,鎖定需在小型規模上平衡推理能力與部署效率的開發者。
其運算預算控制與推理切換功能,旨在賦予系統建構者更大彈性,以管理精準度與回應速度之間的權衡取捨。
該模型現已於Hugging Face及Nvidia模型目錄上架,彰顯其廣泛普及的意圖,旨在鼓勵實驗與整合應用。
Nvidia 推出 Nemotron-Nano-9B-v2,彰顯該公司持續聚焦於語言模型的效能與可控推理能力。
透過融合混合架構與先進壓縮及訓練技術,Nvidia 旨在為開發者提供兼具高精準度、降低運算成本與延遲的解決方案。








 OneRail 運用 NVIDIA 人工智慧來優化即時「最後一哩」配送
OneRail 推出了一套採用 Nvidia 技術的人工智慧驅動配送平台,旨在協助零售商、批發商及經銷商為每筆訂單確定最有效的配送方式。據 OneRail 表示,這套名為 OmniSTAR 的系統會評估各種配送管道——包括自有車隊、快遞員、包裹服務及其他物流模式——以找出既符合服務水準協議,又最具成本效益的解決方案。該平台整合了 NVIDIA 的 cuOpt 決策優化引擎與 cuDF 資料處理軟體
 蘋果新任硬體主管約翰·特努斯主導未來產品願景
正在載入播放器…蘋果公司的特納斯時代已正式開啟。蒂姆·庫克本週卸任執行長職務,將領導權移交給前硬體負責人約翰·特納斯。特納斯在首份備忘錄中承諾“下週將有一場重磅釋出會”,這意味著下一場iPhone活動將在他尚未完全安頓下來之前就擺在他面前。然而,庫克並未完全隱退:他仍擔任執行主席,專注於政策關係,這些關係最近將一些小問題(如地圖示籤)變成了公眾平衡的難題。這一過渡引發了一個關鍵問題:特納斯時代意味著什麼,股東將給予他多大的空間來應對這一挑戰?在本期TechCrunch的Equity播客
 Groq 籌集 3.5 億美元,以推動其從 AI 晶片向“新雲”(neocloud)的戰略轉型
AI基礎設施公司Groq已獲得3.5億美元的新融資,標誌著其從專業晶片開發商向提供強大GPU和AI基礎設施服務的“新雲”提供商的持續轉型。由Disruptive Technologies領投,Nvidia預計也將參與,本輪融資將Groq的估值定為35億美元。這一數字較去年9月Nvidia透過許可協議收購該公司創始人兼執行長Jonathan Ross及核心團隊成員時記錄的69億美元估值大幅下跌。公司發言人向TechCrunch澄清,估值降低並不構成“降價融資”(down round)。相反

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai

이 작은 언어 모델 경쟁이 정말 흥미롭네요! Nvidia가 추론 기능을 끄고 켤 수 있는 옵션을 넣은 건 실용적이면서도 재미있는 접근법인 것 같아요. 개인적으로는 이런 경량화 모델들이 스마트워치나 스마트폰 같은 엣지 디바이스에서 어떻게 활용될지 궁금해요. 🤔 AI가 점점 더 일상 속으로 스며들고 있는 느낌이에요.












