


 首页
Mistral 发布开源语音生成模型
法国人工智能公司Mistral于周四发布了一款新的开源文本转语音模型,该模型专为语音AI助手及客户支持等企业应用而设计。该模型使企业能够构建用于销售和客户互动的语音代理,从而使Mistral成为ElevenLabs、Deepgram和OpenAI的直接竞争对手。
该模型名为Voxtral TTS,支持九种语言,包括英语、法语、德语、西班牙语、荷兰语、葡萄牙语、意大利语、印地语和阿拉伯语。
“我们的客户一直都在寻求语音模型。因此,我们开发了一个小型语音模型,可以适配智能手表、智能手机、笔记本电脑或其他边缘设备。其成本仅为市场上其他产品的零头,却能提供最先进的性能,”Mistral AI科学运营副总裁皮埃尔·斯托克(Pierre Stock)在接受TechCrunch电话采访时表示。
图片来源:Mistral
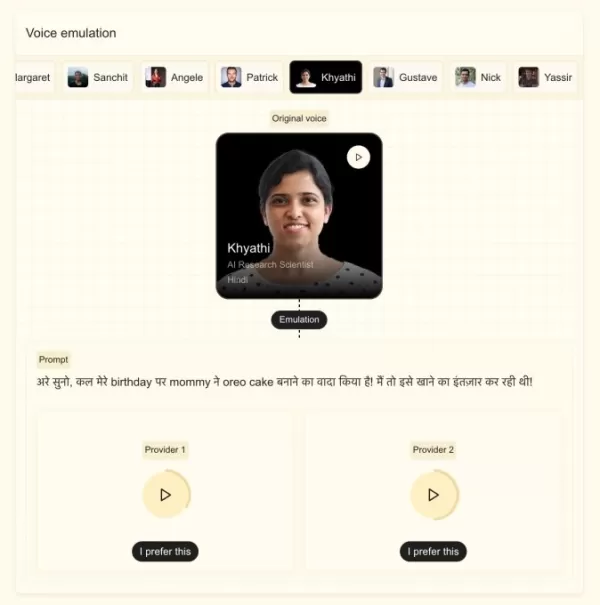
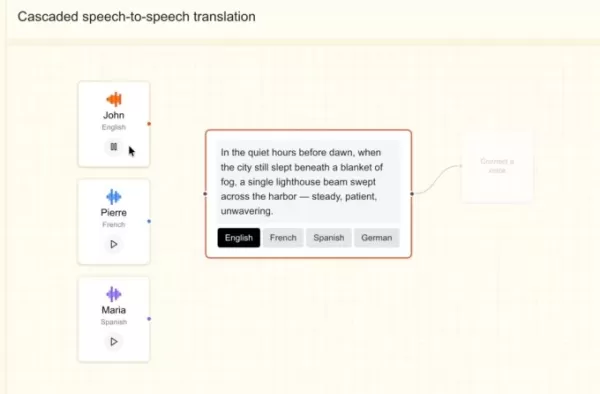
Mistral表示,该新模型仅需不到5秒的语音样本即可适应特定声音,能捕捉细微的口音、语调变化、语调以及语音流中的不规则之处。基于Ministral 3B构建的该模型,可在保持声音特征的同时流畅切换语言,非常适合配音或实时翻译。斯托克指出,公司的目标是让模型听起来像真人,而非机械音。
据该公司介绍,该模型专为实时性能而设计。其“首次发声时间”(TTFA)——即从接收输入到开始“说话”所需的时间——对于一段10秒、500字符的样本而言仅为90毫秒。 该模型还实现了6倍的实时因子(RTF),这意味着它能在约1.6秒内生成一段10秒的音频片段。
图片来源:Mistral AI
今年早些时候,Mistral 推出了两款转录模型——一款用于大规模批量处理,另一款用于低延迟的实时应用场景。随着这款新语音模型的推出,该公司似乎正在为企业构建一套全面的语音产品套件。
Stock补充道:“我们计划打造一个端到端的平台,能够处理多模态输入流——包括音频、文本和图像——以及输出。其关键优势在于,支持音频输入和输出的端到端代理系统能提供更为丰富的信息。”
Mistral将其开源特性和定制能力作为核心差异化优势,允许企业根据具体需求对模型进行调整,从而使其在竞争中更具优势。
相关文章
 ElevenLabs 推出可在歌曲进行中切换音乐风格的 AI 技术
语音人工智能公司ElevenLabs推出了其音乐生成模型的最新版本Music v2,该版本具备在歌曲进行到中途时切换音乐风格的功能。这款模型专为处理复杂的人声与曲目结构而设计。距离这家初创公司首次推出音乐生成模型至今已近十个月,此次新版本终于问世。据ElevenLabs称,该模型能够实现从歌剧到重金属等多种风格的快速转换,并且在保持连贯性的同时输出快速的说唱内容,还能将非音乐类的音效融入歌曲中。艺术家们还可以选择歌曲中的某一段落,通过提示词重新生成该部分内容,而无需改动歌曲的其余部分。此外,
谷歌在 Docs 和 Keep 中推出了语音提示功能
在谷歌I/O开发者大会上,该公司宣布将在Docs、Keep和Gmail等Workspace应用中引入语音提示功能。这些功能使用户能够通过语音创建草稿、记录笔记以及搜索邮件。在 Docs 中,用户可以完全通过语音起草文档。在 TechCrunch 展示的演示中,一位用户从 Drive 中提取了简历信息,从一封电子邮件中添加了活动安排,甚至还加入了几则幽默轶事。图片来源:谷歌此前,用户必须手动输入所有
高盛前员工与Meta创始人联手开发面向被忽视市场的语音AI
客户支持与服务是当今语音人工智能领域最热门的领域之一。但在某些市场,开发出声音逼真且响应延迟极低的产品要比其他市场困难得多——而大多数主要玩家在设计产品时并未将非洲和中东地区纳入考量。AethexAI是一家成立于去年、旨在弥合这一差距的初创公司,已获得由4DX Ventures领投、Enza Capital、Dorm Room Fund、Mojo Ventures和斯坦福大学商学院26号基金跟投的
相关专题推荐
音乐创作
 最佳用于歌曲草稿的 AI 旋律创作工具
2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
 8 个工具
 xix.ai
聊天机器人
最佳AI对话训练工具,助你备战面试
2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai
设计与艺术
最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai

 评论 (1)
0/500
![WilliamRamirez]()
I just tried out Mistral’s new open-source TTS model yesterday, and its pronunciation is way more natural than most free options I’ve used before. It’s super useful for companies that want to build their own voice assistants without spending tons on licensed services. Do you think this will change the game in the enterprise voice AI market?
法国人工智能公司Mistral于周四发布了一款新的开源文本转语音模型,该模型专为语音AI助手及客户支持等企业应用而设计。该模型使企业能够构建用于销售和客户互动的语音代理,从而使Mistral成为ElevenLabs、Deepgram和OpenAI的直接竞争对手。
该模型名为Voxtral TTS,支持九种语言,包括英语、法语、德语、西班牙语、荷兰语、葡萄牙语、意大利语、印地语和阿拉伯语。
“我们的客户一直都在寻求语音模型。因此,我们开发了一个小型语音模型,可以适配智能手表、智能手机、笔记本电脑或其他边缘设备。其成本仅为市场上其他产品的零头,却能提供最先进的性能,”Mistral AI科学运营副总裁皮埃尔·斯托克(Pierre Stock)在接受TechCrunch电话采访时表示。
图片来源:Mistral
Mistral表示,该新模型仅需不到5秒的语音样本即可适应特定声音,能捕捉细微的口音、语调变化、语调以及语音流中的不规则之处。基于Ministral 3B构建的该模型,可在保持声音特征的同时流畅切换语言,非常适合配音或实时翻译。斯托克指出,公司的目标是让模型听起来像真人,而非机械音。
据该公司介绍,该模型专为实时性能而设计。其“首次发声时间”(TTFA)——即从接收输入到开始“说话”所需的时间——对于一段10秒、500字符的样本而言仅为90毫秒。 该模型还实现了6倍的实时因子(RTF),这意味着它能在约1.6秒内生成一段10秒的音频片段。
图片来源:Mistral AI
今年早些时候,Mistral 推出了两款转录模型——一款用于大规模批量处理,另一款用于低延迟的实时应用场景。随着这款新语音模型的推出,该公司似乎正在为企业构建一套全面的语音产品套件。
Stock补充道:“我们计划打造一个端到端的平台,能够处理多模态输入流——包括音频、文本和图像——以及输出。其关键优势在于,支持音频输入和输出的端到端代理系统能提供更为丰富的信息。”
Mistral将其开源特性和定制能力作为核心差异化优势,允许企业根据具体需求对模型进行调整,从而使其在竞争中更具优势。








 ElevenLabs 推出可在歌曲进行中切换音乐风格的 AI 技术
语音人工智能公司ElevenLabs推出了其音乐生成模型的最新版本Music v2,该版本具备在歌曲进行到中途时切换音乐风格的功能。这款模型专为处理复杂的人声与曲目结构而设计。距离这家初创公司首次推出音乐生成模型至今已近十个月,此次新版本终于问世。据ElevenLabs称,该模型能够实现从歌剧到重金属等多种风格的快速转换,并且在保持连贯性的同时输出快速的说唱内容,还能将非音乐类的音效融入歌曲中。艺术家们还可以选择歌曲中的某一段落,通过提示词重新生成该部分内容,而无需改动歌曲的其余部分。此外,
 谷歌在 Docs 和 Keep 中推出了语音提示功能
在谷歌I/O开发者大会上,该公司宣布将在Docs、Keep和Gmail等Workspace应用中引入语音提示功能。这些功能使用户能够通过语音创建草稿、记录笔记以及搜索邮件。在 Docs 中,用户可以完全通过语音起草文档。在 TechCrunch 展示的演示中,一位用户从 Drive 中提取了简历信息,从一封电子邮件中添加了活动安排,甚至还加入了几则幽默轶事。图片来源:谷歌此前,用户必须手动输入所有
 高盛前员工与Meta创始人联手开发面向被忽视市场的语音AI
客户支持与服务是当今语音人工智能领域最热门的领域之一。但在某些市场,开发出声音逼真且响应延迟极低的产品要比其他市场困难得多——而大多数主要玩家在设计产品时并未将非洲和中东地区纳入考量。AethexAI是一家成立于去年、旨在弥合这一差距的初创公司,已获得由4DX Ventures领投、Enza Capital、Dorm Room Fund、Mojo Ventures和斯坦福大学商学院26号基金跟投的

2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai

I just tried out Mistral’s new open-source TTS model yesterday, and its pronunciation is way more natural than most free options I’ve used before. It’s super useful for companies that want to build their own voice assistants without spending tons on licensed services. Do you think this will change the game in the enterprise voice AI market?












