


 家
ミストラル、オープンソースの音声生成モデルを発表
フランスのAI企業Mistralは木曜日、音声AIアシスタントやカスタマーサポートなどの企業向けアプリケーション向けに設計された、新しいオープンソースのテキスト読み上げ(TTS)モデルを発表した。このモデルにより、企業は営業や顧客エンゲージメントのための音声エージェントを構築できるようになり、MistralはElevenLabs、Deepgram、OpenAIの直接的な競合相手としての地位を確立した。
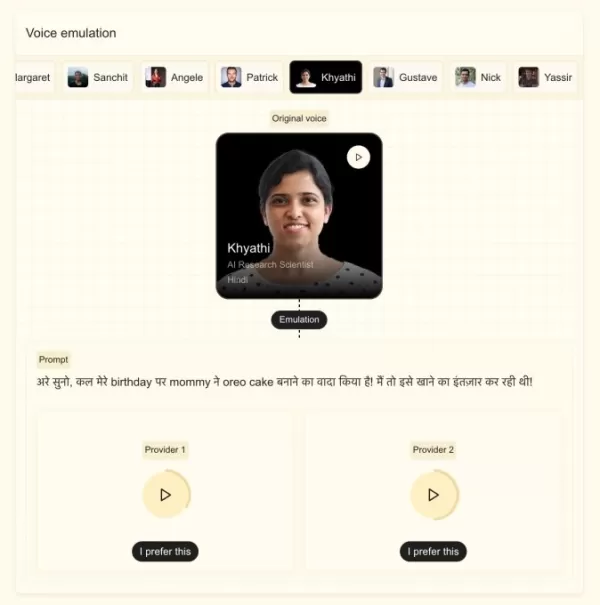
「Voxtral TTS」と名付けられたこのモデルは、英語、フランス語、ドイツ語、スペイン語、オランダ語、ポルトガル語、イタリア語、ヒンディー語、アラビア語の9言語に対応している。
「顧客から音声モデルの要望が寄せられていました。そこで、スマートウォッチ、スマートフォン、ノートPC、その他のエッジデバイスに搭載可能な小型の音声モデルを開発しました。コストは市場の他製品に比べてごくわずかですが、最先端の性能を発揮します」と、Mistral AIのサイエンスオペレーション担当副社長であるピエール・ストック氏は、TechCrunchとの電話インタビューで語った。
画像提供:Mistral
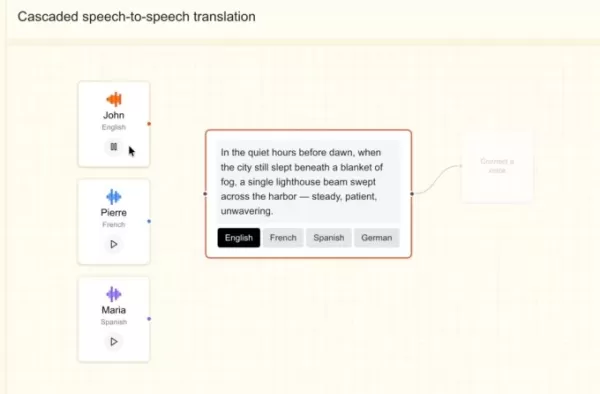
Mistral社によると、この新モデルは5秒未満の音声サンプルを用いて特定の声に順応でき、微妙なアクセント、抑揚、イントネーション、そして話し方の不規則性まで捉えることができるという。Ministral 3Bを基盤として構築されており、声の特性を維持したまま言語を切り替えることができるため、吹き替えやリアルタイム翻訳に最適だ。ストック氏は、同社がロボットのような音声ではなく、人間らしい音声を実現することを目指したと述べた。
同社によると、このモデルはリアルタイム性能を重視して設計されている。入力を受け取ってから「話し始める」までの時間である「Time-to-First-Audio(TTFA)」は、500文字の10秒間のサンプルに対して90ミリ秒である。 また、このモデルはリアルタイムファクター(RTF)6倍を達成しており、10秒間のクリップを約1.6秒で生成できることを意味する。
画像提供:Mistral AI
今年初め、Mistralは2つの文字起こしモデルをリリースしました。1つは大規模なバッチ処理用、もう1つは低遅延のリアルタイムユースケース向けです。この新しい音声モデルにより、同社は企業向けの包括的な音声製品スイートを構築しているようです。
ストック氏は次のように付け加えた。「音声、テキスト、画像といったマルチモーダルな入力ストリームと出力を処理できるエンドツーエンドのプラットフォームを構築する計画だ。最大の利点は、音声の入出力に対応したエンドツーエンドのエージェンティックシステムが、はるかに豊富な情報を提供できる点にある。」
Mistralは、そのオープンソースという性質とカスタマイズ機能を主要な差別化要因として位置付けており、企業が特定のニーズに合わせてモデルを調整できるため、競合他社のソリューションよりも優位性があるとしています。
関連記事
 ElevenLabs、ブラックロック、ジェイミー・フォックス、ロザリオ・ドーソンを新たな投資家として迎え入れる
ElevenLabsは音声AIのリーダーであり、2月に最初に発表された5億ドルのシリーズD資金調達ラウンドに新たな参加者を発表した。投資家リストには、BlackRock、Wellington、D.E. Shaw、Schrodersなどの主要機関に加え、NVIDIA、Salesforce、Santander、KPN、Deutsche Telekomなどの戦略的な企業支援者が加わっている。このラウンドに加わった著名な個人投資家には、俳優のジェイミー・フォックスとエヴァ・ロンゴリア、そして『ソウル・ゲ
PolyAI、対話システム向けコーディングエージェント「Wren」を発表
PolyAIは、エージェント型音声AIをこれまで以上に人間らしくすることを目指しています。写真提供:GettyPolyAIの研究担当副社長であるマット・ヘンダーソン氏は、自律型コーディングエージェント「Wren」が、より良い顧客サービスを実現するために企業の対話型エージェントを最適化する仕組みについて解説する長年にわたり、企業のコンタクトセンターは従来の音声自動応答(IVR)システムに依存してきま
Rime、エンタープライズ顧客サポートの強化のため2,400万ドルのシリーズA資金調達に成功
Voice AI startups have primarily unlocked value by managing enterprise calls across sales, marketing, and customer support. Large organizations are delegating call handling to voice model developers such as ElevenLabs and Deepgram, infrastructure pro
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (1)
0/500
![WilliamRamirez]()
I just tried out Mistral’s new open-source TTS model yesterday, and its pronunciation is way more natural than most free options I’ve used before. It’s super useful for companies that want to build their own voice assistants without spending tons on licensed services. Do you think this will change the game in the enterprise voice AI market?
フランスのAI企業Mistralは木曜日、音声AIアシスタントやカスタマーサポートなどの企業向けアプリケーション向けに設計された、新しいオープンソースのテキスト読み上げ(TTS)モデルを発表した。このモデルにより、企業は営業や顧客エンゲージメントのための音声エージェントを構築できるようになり、MistralはElevenLabs、Deepgram、OpenAIの直接的な競合相手としての地位を確立した。
「Voxtral TTS」と名付けられたこのモデルは、英語、フランス語、ドイツ語、スペイン語、オランダ語、ポルトガル語、イタリア語、ヒンディー語、アラビア語の9言語に対応している。
「顧客から音声モデルの要望が寄せられていました。そこで、スマートウォッチ、スマートフォン、ノートPC、その他のエッジデバイスに搭載可能な小型の音声モデルを開発しました。コストは市場の他製品に比べてごくわずかですが、最先端の性能を発揮します」と、Mistral AIのサイエンスオペレーション担当副社長であるピエール・ストック氏は、TechCrunchとの電話インタビューで語った。
画像提供:Mistral
Mistral社によると、この新モデルは5秒未満の音声サンプルを用いて特定の声に順応でき、微妙なアクセント、抑揚、イントネーション、そして話し方の不規則性まで捉えることができるという。Ministral 3Bを基盤として構築されており、声の特性を維持したまま言語を切り替えることができるため、吹き替えやリアルタイム翻訳に最適だ。ストック氏は、同社がロボットのような音声ではなく、人間らしい音声を実現することを目指したと述べた。
同社によると、このモデルはリアルタイム性能を重視して設計されている。入力を受け取ってから「話し始める」までの時間である「Time-to-First-Audio(TTFA)」は、500文字の10秒間のサンプルに対して90ミリ秒である。 また、このモデルはリアルタイムファクター(RTF)6倍を達成しており、10秒間のクリップを約1.6秒で生成できることを意味する。
画像提供:Mistral AI
今年初め、Mistralは2つの文字起こしモデルをリリースしました。1つは大規模なバッチ処理用、もう1つは低遅延のリアルタイムユースケース向けです。この新しい音声モデルにより、同社は企業向けの包括的な音声製品スイートを構築しているようです。
ストック氏は次のように付け加えた。「音声、テキスト、画像といったマルチモーダルな入力ストリームと出力を処理できるエンドツーエンドのプラットフォームを構築する計画だ。最大の利点は、音声の入出力に対応したエンドツーエンドのエージェンティックシステムが、はるかに豊富な情報を提供できる点にある。」
Mistralは、そのオープンソースという性質とカスタマイズ機能を主要な差別化要因として位置付けており、企業が特定のニーズに合わせてモデルを調整できるため、競合他社のソリューションよりも優位性があるとしています。








 ElevenLabs、ブラックロック、ジェイミー・フォックス、ロザリオ・ドーソンを新たな投資家として迎え入れる
ElevenLabsは音声AIのリーダーであり、2月に最初に発表された5億ドルのシリーズD資金調達ラウンドに新たな参加者を発表した。投資家リストには、BlackRock、Wellington、D.E. Shaw、Schrodersなどの主要機関に加え、NVIDIA、Salesforce、Santander、KPN、Deutsche Telekomなどの戦略的な企業支援者が加わっている。このラウンドに加わった著名な個人投資家には、俳優のジェイミー・フォックスとエヴァ・ロンゴリア、そして『ソウル・ゲ
 PolyAI、対話システム向けコーディングエージェント「Wren」を発表
PolyAIは、エージェント型音声AIをこれまで以上に人間らしくすることを目指しています。写真提供:GettyPolyAIの研究担当副社長であるマット・ヘンダーソン氏は、自律型コーディングエージェント「Wren」が、より良い顧客サービスを実現するために企業の対話型エージェントを最適化する仕組みについて解説する長年にわたり、企業のコンタクトセンターは従来の音声自動応答(IVR)システムに依存してきま
 Rime、エンタープライズ顧客サポートの強化のため2,400万ドルのシリーズA資金調達に成功
Voice AI startups have primarily unlocked value by managing enterprise calls across sales, marketing, and customer support. Large organizations are delegating call handling to voice model developers such as ElevenLabs and Deepgram, infrastructure pro

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

I just tried out Mistral’s new open-source TTS model yesterday, and its pronunciation is way more natural than most free options I’ve used before. It’s super useful for companies that want to build their own voice assistants without spending tons on licensed services. Do you think this will change the game in the enterprise voice AI market?












