


 Heim
Mistral stellt ein Open-Source-Modell zur Sprachgenerierung vor
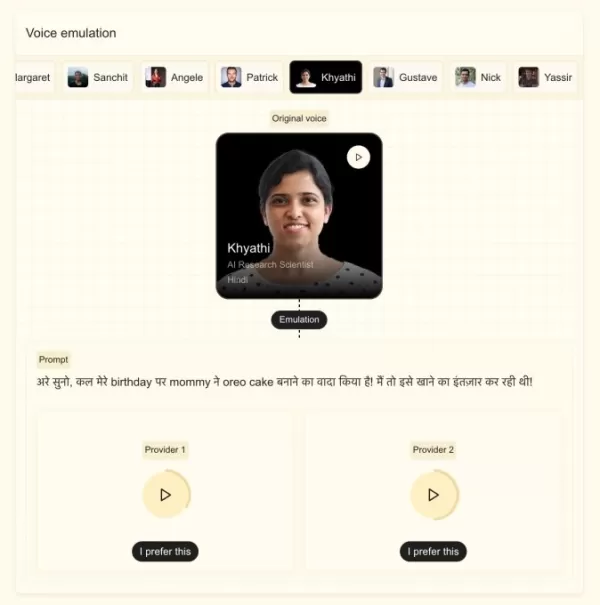
Das französische KI-Unternehmen Mistral hat am Donnerstag ein neues Open-Source-Text-to-Speech-Modell vorgestellt, das für Sprach-KI-Assistenten und Unternehmensanwendungen wie den Kundensupport konzipiert ist. Das Modell ermöglicht es Unternehmen, Sprachassistenten für den Vertrieb und die Kundenbindung zu entwickeln, wodurch sich Mistral als direkter Konkurrent von ElevenLabs, Deepgram und OpenAI positioniert.
Das Modell namens Voxtral TTS unterstützt neun Sprachen, darunter Englisch, Französisch, Deutsch, Spanisch, Niederländisch, Portugiesisch, Italienisch, Hindi und Arabisch.
„Unsere Kunden haben nach einem Sprachmodell gefragt. Deshalb haben wir ein kompaktes Sprachmodell entwickelt, das auf eine Smartwatch, ein Smartphone, einen Laptop oder andere Edge-Geräte passt. Die Kosten betragen nur einen Bruchteil dessen, was sonst auf dem Markt erhältlich ist, dennoch bietet es Leistung auf dem neuesten Stand der Technik“, sagte Pierre Stock, VP of Science Operations bei Mistral AI, in einem Telefoninterview mit TechCrunch.
Bildnachweis: Mistral
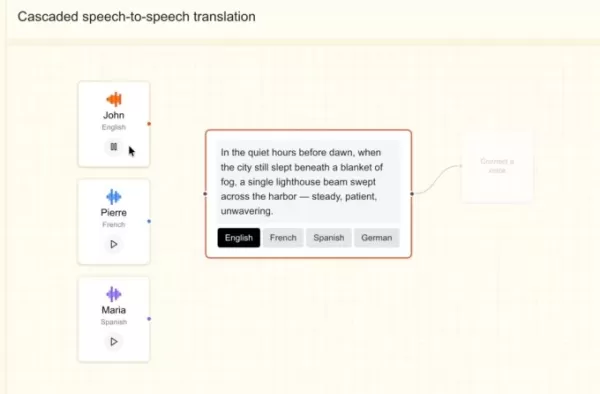
Mistral gibt an, dass sich das neue Modell anhand einer weniger als fünf Sekunden langen Sprachprobe an eine individuelle Stimme anpassen kann und dabei subtile Akzente, Betonungen, Intonationen und Unregelmäßigkeiten im Sprachfluss erfasst. Es basiert auf Mistral 3B und kann nahtlos zwischen Sprachen wechseln, während die Stimmcharakteristika erhalten bleiben, was es ideal für Synchronisation oder Echtzeitübersetzung macht. Stock merkte an, dass das Unternehmen darauf abzielte, das Modell menschlich klingen zu lassen, nicht roboterhaft.
Nach Angaben des Unternehmens ist das Modell für Echtzeitleistung ausgelegt. Seine „Time-to-First-Audio“ (TTFA) – die Zeit zwischen dem Empfang der Eingabe und dem Beginn des „Sprechens“ – beträgt 90 ms für ein 10-Sekunden-Beispiel mit 500 Zeichen. Das Modell erreicht zudem einen Echtzeitfaktor (RTF) von 6x, was bedeutet, dass es einen 10-Sekunden-Clip in etwa 1,6 Sekunden generieren kann.
Bildnachweis: Mistral AI
Anfang dieses Jahres brachte Mistral zwei Transkriptionsmodelle auf den Markt – eines für die groß angelegte Stapelverarbeitung, das andere für Echtzeit-Anwendungsfälle mit geringer Latenz. Mit dem neuen Sprachmodell scheint das Unternehmen eine umfassende Suite von Sprachprodukten für Unternehmen aufzubauen.
Stock fügte hinzu: „Wir planen die Entwicklung einer End-to-End-Plattform, die multimodale Eingabeströme – Audio, Text und Bild – sowie die Ausgabe verarbeiten kann. Der entscheidende Vorteil besteht darin, dass ein End-to-End-Agentensystem, das Audioeingabe und -ausgabe unterstützt, wesentlich reichhaltigere Informationen liefert.“
Mistral positioniert seinen Open-Source-Charakter und seine Anpassungsmöglichkeiten als wesentliche Alleinstellungsmerkmale, die es Unternehmen ermöglichen, das Modell an ihre spezifischen Bedürfnisse anzupassen, und hebt sich damit von Lösungen der Konkurrenz ab.
Verwandter Artikel
 ElevenLabs präsentiert eine Musik-KI, die mitten im Lied den Genrewechsel bewirkt
ElevenLabs, ein Unternehmen im Bereich KI für Stimmen, hat Music v2 veröffentlicht – die neueste Version seines Modells zur Erstellung von Musik, das es ermöglicht, mitten in einem Stück den Genrewechsel vorzunehmen. Das Modell ist darauf ausgelegt,
Google führt sprachgesteuerte Eingabeaufforderungen in Docs und Keep ein
Auf der Entwicklerkonferenz Google I/O kündigte das Unternehmen an, sprachgesteuerte Eingabefunktionen für Workspace-Anwendungen wie Docs, Keep und Gmail einzuführen. Mit diesen Funktionen können Nutz
Ehemalige Goldman-Mitarbeiter und Meta-Gründer entwickeln Sprach-KI für vernachlässigte Märkte
Kundensupport und -service gehören heute zu den gefragtesten Bereichen der Sprach-KI. Doch die Entwicklung eines Produkts, das menschlich klingt und mit minimaler Verzögerung reagiert, ist in manchen
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
 8 Tools
 xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

 Kommentare (1)
![WilliamRamirez]()
I just tried out Mistral’s new open-source TTS model yesterday, and its pronunciation is way more natural than most free options I’ve used before. It’s super useful for companies that want to build their own voice assistants without spending tons on licensed services. Do you think this will change the game in the enterprise voice AI market?
Das französische KI-Unternehmen Mistral hat am Donnerstag ein neues Open-Source-Text-to-Speech-Modell vorgestellt, das für Sprach-KI-Assistenten und Unternehmensanwendungen wie den Kundensupport konzipiert ist. Das Modell ermöglicht es Unternehmen, Sprachassistenten für den Vertrieb und die Kundenbindung zu entwickeln, wodurch sich Mistral als direkter Konkurrent von ElevenLabs, Deepgram und OpenAI positioniert.
Das Modell namens Voxtral TTS unterstützt neun Sprachen, darunter Englisch, Französisch, Deutsch, Spanisch, Niederländisch, Portugiesisch, Italienisch, Hindi und Arabisch.
„Unsere Kunden haben nach einem Sprachmodell gefragt. Deshalb haben wir ein kompaktes Sprachmodell entwickelt, das auf eine Smartwatch, ein Smartphone, einen Laptop oder andere Edge-Geräte passt. Die Kosten betragen nur einen Bruchteil dessen, was sonst auf dem Markt erhältlich ist, dennoch bietet es Leistung auf dem neuesten Stand der Technik“, sagte Pierre Stock, VP of Science Operations bei Mistral AI, in einem Telefoninterview mit TechCrunch.
Bildnachweis: Mistral
Mistral gibt an, dass sich das neue Modell anhand einer weniger als fünf Sekunden langen Sprachprobe an eine individuelle Stimme anpassen kann und dabei subtile Akzente, Betonungen, Intonationen und Unregelmäßigkeiten im Sprachfluss erfasst. Es basiert auf Mistral 3B und kann nahtlos zwischen Sprachen wechseln, während die Stimmcharakteristika erhalten bleiben, was es ideal für Synchronisation oder Echtzeitübersetzung macht. Stock merkte an, dass das Unternehmen darauf abzielte, das Modell menschlich klingen zu lassen, nicht roboterhaft.
Nach Angaben des Unternehmens ist das Modell für Echtzeitleistung ausgelegt. Seine „Time-to-First-Audio“ (TTFA) – die Zeit zwischen dem Empfang der Eingabe und dem Beginn des „Sprechens“ – beträgt 90 ms für ein 10-Sekunden-Beispiel mit 500 Zeichen. Das Modell erreicht zudem einen Echtzeitfaktor (RTF) von 6x, was bedeutet, dass es einen 10-Sekunden-Clip in etwa 1,6 Sekunden generieren kann.
Bildnachweis: Mistral AI
Anfang dieses Jahres brachte Mistral zwei Transkriptionsmodelle auf den Markt – eines für die groß angelegte Stapelverarbeitung, das andere für Echtzeit-Anwendungsfälle mit geringer Latenz. Mit dem neuen Sprachmodell scheint das Unternehmen eine umfassende Suite von Sprachprodukten für Unternehmen aufzubauen.
Stock fügte hinzu: „Wir planen die Entwicklung einer End-to-End-Plattform, die multimodale Eingabeströme – Audio, Text und Bild – sowie die Ausgabe verarbeiten kann. Der entscheidende Vorteil besteht darin, dass ein End-to-End-Agentensystem, das Audioeingabe und -ausgabe unterstützt, wesentlich reichhaltigere Informationen liefert.“
Mistral positioniert seinen Open-Source-Charakter und seine Anpassungsmöglichkeiten als wesentliche Alleinstellungsmerkmale, die es Unternehmen ermöglichen, das Modell an ihre spezifischen Bedürfnisse anzupassen, und hebt sich damit von Lösungen der Konkurrenz ab.








 ElevenLabs präsentiert eine Musik-KI, die mitten im Lied den Genrewechsel bewirkt
ElevenLabs, ein Unternehmen im Bereich KI für Stimmen, hat Music v2 veröffentlicht – die neueste Version seines Modells zur Erstellung von Musik, das es ermöglicht, mitten in einem Stück den Genrewechsel vorzunehmen. Das Modell ist darauf ausgelegt,
 Google führt sprachgesteuerte Eingabeaufforderungen in Docs und Keep ein
Auf der Entwicklerkonferenz Google I/O kündigte das Unternehmen an, sprachgesteuerte Eingabefunktionen für Workspace-Anwendungen wie Docs, Keep und Gmail einzuführen. Mit diesen Funktionen können Nutz
 Ehemalige Goldman-Mitarbeiter und Meta-Gründer entwickeln Sprach-KI für vernachlässigte Märkte
Kundensupport und -service gehören heute zu den gefragtesten Bereichen der Sprach-KI. Doch die Entwicklung eines Produkts, das menschlich klingt und mit minimaler Verzögerung reagiert, ist in manchen

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

I just tried out Mistral’s new open-source TTS model yesterday, and its pronunciation is way more natural than most free options I’ve used before. It’s super useful for companies that want to build their own voice assistants without spending tons on licensed services. Do you think this will change the game in the enterprise voice AI market?












