


 집
미스트랄, 오픈소스 음성 생성 모델 공개
프랑스의 AI 기업 미스트랄(Mistral)은 목요일, 음성 AI 비서 및 고객 지원과 같은 기업용 애플리케이션을 위해 설계된 새로운 오픈소스 텍스트-투-스피치(TTS) 모델을 공개했다. 이 모델을 통해 기업들은 영업 및 고객 소통을 위한 음성 에이전트를 구축할 수 있게 되었으며, 미스트랄은 이를 통해 일레븐랩스(ElevenLabs), 딥그램(Deepgram), 오픈AI(OpenAI)의 직접적인 경쟁자로 자리매김했다.
'복스트랄 TTS(Voxtral TTS)'로 명명된 이 모델은 영어, 프랑스어, 독일어, 스페인어, 네덜란드어, 포르투갈어, 이탈리아어, 힌디어, 아랍어 등 9개 언어를 지원한다.
미스트랄 AI의 과학 운영 부사장 피에르 스톡(Pierre Stock)은 테크크런치(TechCrunch)와의 전화 인터뷰에서 "고객들이 음성 모델을 요청해 왔습니다. 그래서 우리는 스마트워치, 스마트폰, 노트북 또는 기타 엣지 기기에 탑재할 수 있는 소형 음성 모델을 개발했습니다. 비용은 시중의 다른 제품들에 비해 극히 일부에 불과하지만, 최첨단 성능을 제공합니다"라고 말했다.
이미지 출처: 미스트랄
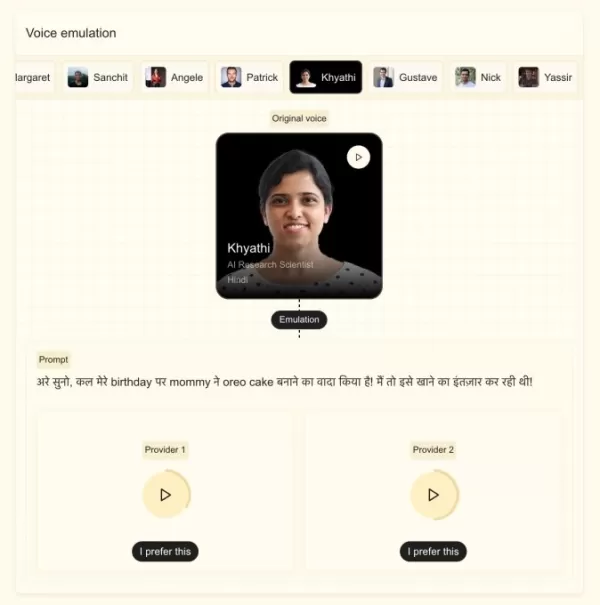
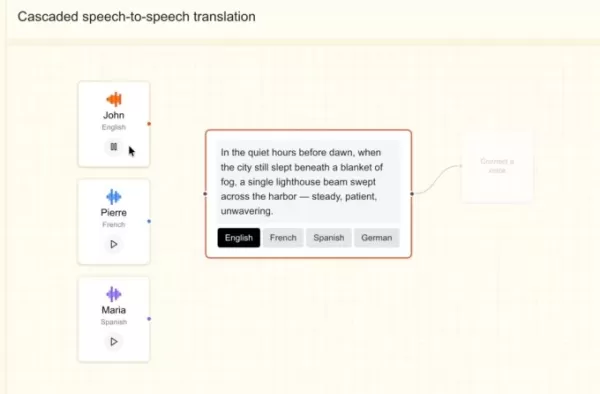
미스트랄은 이 새로운 모델이 5초 미만의 샘플만으로도 사용자 맞춤형 음성에 적응할 수 있으며, 미묘한 억양, 어조, 강세, 그리고 말의 흐름에서 나타나는 불규칙성까지 포착할 수 있다고 설명합니다. 미스트랄 3B를 기반으로 구축된 이 모델은 음성 특성을 유지한 채 언어를 매끄럽게 전환할 수 있어 더빙이나 실시간 번역에 이상적입니다. 스톡 부사장은 회사가 로봇 같은 소리가 아닌, 인간과 같은 목소리를 내는 모델을 만드는 것을 목표로 했다고 언급했습니다.
회사에 따르면, 이 모델은 실시간 성능을 위해 설계되었다. 입력 수신부터 '말하기' 시작까지의 시간인 '첫 음성 출력까지 소요 시간(TTFA)'은 500자 분량의 10초 샘플 기준 90ms이다. 또한 이 모델은 6배의 실시간 처리율(RTF)을 달성하여, 약 1.6초 만에 10초 분량의 클립을 생성할 수 있습니다.
이미지 출처: 미스트랄 AI
올해 초, 미스트랄은 대규모 일괄 처리를 위한 모델과 저지연 실시간 사용 사례를 위한 모델 등 두 가지 트랜스크립션 모델을 출시했습니다. 새로운 음성 모델을 통해 이 회사는 기업을 위한 포괄적인 음성 제품군을 구축하고 있는 것으로 보입니다.
스톡은 "우리는 오디오, 텍스트, 이미지 등 다중 모달 입력 스트림은 물론 출력까지 처리할 수 있는 엔드투엔드 플랫폼을 구축할 계획입니다. 핵심적인 장점은 오디오 입력 및 출력을 지원하는 엔드투엔드 에이전트 시스템이 훨씬 더 풍부한 정보를 제공한다는 점입니다"라고 덧붙였습니다.
미스트랄은 오픈소스 특성과 사용자 정의 기능을 핵심 차별화 요소로 내세우며, 기업들이 특정 요구 사항에 맞춰 모델을 조정할 수 있게 함으로써 경쟁사 솔루션보다 우위를 점하고 있습니다.
관련 기사
 ElevenLabs, 곡의 중간에 장르를 바꿔주는 음악 AI를 공개하다
음성 AI 기업인 ElevenLabs는 곡의 중간에 장르를 변경할 수 있는 최신 음악 생성 모델인 Music v2를 출시했습니다. 이 모델은 복잡한 보컬과 작곡을 처리하도록 설계되었으며, 해당 회사가 첫 번째 음악 생성 모델을 선보인 지 거의 10개월 만에 공개된 것입니다.ElevenLabs에 따르면 이 모델은 오페라에서 헤비메탈로, 또 다시 그 반대로 전환할 수 있으며, 일관성을 잃지 않으면서 빠른 템포의 랩을 제공하고 곡에 비음악적인 사운
구글, ‘도큐먼트’와 ‘킵’에 음성 기반 안내 기능 도입
구글은 ‘구글 I/O’ 개발자 컨퍼런스에서 ‘문서’, ‘킵’, ‘지메일’과 같은 워크스페이스 앱에 음성 기반 프롬프트 기능을 도입한다고 발표했습니다. 이 기능을 통해 사용자는 음성으로 문서 초안을 작성하고, 메모를 남기며, 이메일을 검색할 수 있습니다.Docs에서는 음성만으로 문서 초안을 작성할 수 있습니다. TechCrunch가 시연한 데모에서 한 사용자
골드만삭스 출신과 메타 공동 창업자들이 소외된 시장을 겨냥한 음성 AI를 개발 중
고객 지원 및 서비스는 오늘날 음성 AI 분야에서 가장 주목받는 분야 중 하나입니다. 하지만 사람처럼 자연스러운 음성을 내고 지연 시간을 최소화하며 응답하는 제품을 개발하는 일은 일부 시장에서 다른 시장보다 훨씬 더 어려운 과제이며, 대부분의 주요 기업들은 아프리카와 중동 시장을 염두에 두고 제품을 설계하지 않았습니다.이러한 격차를 해소하기 위해 작년에 설
관련 특별 주제 추천
음악 작곡
 노래 초안을 위한 최고의 AI 멜로디 작곡 도구
2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
 8 도구
 xix.ai
챗봇
면접 연습을 위한 최고의 AI 대화 트레이너 도구
2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai
디자인과 예술
창의적인 실험을 위한 최고의 AI 스타일 변환 도구
2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai
만화 창작
시각적 스토리텔링을 위한 최고의 AI 대화 풍선 도구
2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai
회의 도우미
최고의 AI 회의 요약 도구: 의사 결정 사항과 후속 조치를 명확하게 추적하세요
2026년 최신 최고 평점을 받은 최고의 AI 회의 요약 도구로, 명확한 의사 결정 추적과 손쉬운 후속 조치를 실현하세요. 이 엄선된 목록은 회의록 자동화, 핵심 실행 과제 파악, 모든 프로젝트에 걸친 팀 협업 효율화를 통해 생산성을 획기적으로 높여주는 강력하고 혁신적인 솔루션을 소개합니다. 무료 버전과 유료 버전의 비교 정보, 실제 사용 후기, 매주 업데이트되는 순위 정보를 통해 여러분에게 딱 맞는 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
9 도구
xix.ai
데이터 분석
최고의 AI 데이터 정제 도구: 누락된 값과 중복 데이터를 신속하게 수정하기
2026년 최신의 우수하고 높은 평가를 받는 AI 데이터 정제 도구들로, 누락된 값과 중복 데이터를 신속하게 수정할 수 있습니다. 이 선별된 목록에는 생산성을 획기적으로 향상시켜 주는 강력한 솔루션이 포함되어 있습니다. 각 도구는 신뢰성을 보장하기 위해 엄격한 실제 환경 테스트를 거쳤습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 귀하의 요구사항에 가장 적합한 도구를 발견해 보세요. 지금 바로 XIX.AI에서 자세히 알아보시고 AI 분야에서의 경쟁 우위를 확보하세요.
11 도구
xix.ai

 의견 (1)
0/500
![WilliamRamirez]()
I just tried out Mistral’s new open-source TTS model yesterday, and its pronunciation is way more natural than most free options I’ve used before. It’s super useful for companies that want to build their own voice assistants without spending tons on licensed services. Do you think this will change the game in the enterprise voice AI market?
프랑스의 AI 기업 미스트랄(Mistral)은 목요일, 음성 AI 비서 및 고객 지원과 같은 기업용 애플리케이션을 위해 설계된 새로운 오픈소스 텍스트-투-스피치(TTS) 모델을 공개했다. 이 모델을 통해 기업들은 영업 및 고객 소통을 위한 음성 에이전트를 구축할 수 있게 되었으며, 미스트랄은 이를 통해 일레븐랩스(ElevenLabs), 딥그램(Deepgram), 오픈AI(OpenAI)의 직접적인 경쟁자로 자리매김했다.
'복스트랄 TTS(Voxtral TTS)'로 명명된 이 모델은 영어, 프랑스어, 독일어, 스페인어, 네덜란드어, 포르투갈어, 이탈리아어, 힌디어, 아랍어 등 9개 언어를 지원한다.
미스트랄 AI의 과학 운영 부사장 피에르 스톡(Pierre Stock)은 테크크런치(TechCrunch)와의 전화 인터뷰에서 "고객들이 음성 모델을 요청해 왔습니다. 그래서 우리는 스마트워치, 스마트폰, 노트북 또는 기타 엣지 기기에 탑재할 수 있는 소형 음성 모델을 개발했습니다. 비용은 시중의 다른 제품들에 비해 극히 일부에 불과하지만, 최첨단 성능을 제공합니다"라고 말했다.
이미지 출처: 미스트랄
미스트랄은 이 새로운 모델이 5초 미만의 샘플만으로도 사용자 맞춤형 음성에 적응할 수 있으며, 미묘한 억양, 어조, 강세, 그리고 말의 흐름에서 나타나는 불규칙성까지 포착할 수 있다고 설명합니다. 미스트랄 3B를 기반으로 구축된 이 모델은 음성 특성을 유지한 채 언어를 매끄럽게 전환할 수 있어 더빙이나 실시간 번역에 이상적입니다. 스톡 부사장은 회사가 로봇 같은 소리가 아닌, 인간과 같은 목소리를 내는 모델을 만드는 것을 목표로 했다고 언급했습니다.
회사에 따르면, 이 모델은 실시간 성능을 위해 설계되었다. 입력 수신부터 '말하기' 시작까지의 시간인 '첫 음성 출력까지 소요 시간(TTFA)'은 500자 분량의 10초 샘플 기준 90ms이다. 또한 이 모델은 6배의 실시간 처리율(RTF)을 달성하여, 약 1.6초 만에 10초 분량의 클립을 생성할 수 있습니다.
이미지 출처: 미스트랄 AI
올해 초, 미스트랄은 대규모 일괄 처리를 위한 모델과 저지연 실시간 사용 사례를 위한 모델 등 두 가지 트랜스크립션 모델을 출시했습니다. 새로운 음성 모델을 통해 이 회사는 기업을 위한 포괄적인 음성 제품군을 구축하고 있는 것으로 보입니다.
스톡은 "우리는 오디오, 텍스트, 이미지 등 다중 모달 입력 스트림은 물론 출력까지 처리할 수 있는 엔드투엔드 플랫폼을 구축할 계획입니다. 핵심적인 장점은 오디오 입력 및 출력을 지원하는 엔드투엔드 에이전트 시스템이 훨씬 더 풍부한 정보를 제공한다는 점입니다"라고 덧붙였습니다.
미스트랄은 오픈소스 특성과 사용자 정의 기능을 핵심 차별화 요소로 내세우며, 기업들이 특정 요구 사항에 맞춰 모델을 조정할 수 있게 함으로써 경쟁사 솔루션보다 우위를 점하고 있습니다.








 ElevenLabs, 곡의 중간에 장르를 바꿔주는 음악 AI를 공개하다
음성 AI 기업인 ElevenLabs는 곡의 중간에 장르를 변경할 수 있는 최신 음악 생성 모델인 Music v2를 출시했습니다. 이 모델은 복잡한 보컬과 작곡을 처리하도록 설계되었으며, 해당 회사가 첫 번째 음악 생성 모델을 선보인 지 거의 10개월 만에 공개된 것입니다.ElevenLabs에 따르면 이 모델은 오페라에서 헤비메탈로, 또 다시 그 반대로 전환할 수 있으며, 일관성을 잃지 않으면서 빠른 템포의 랩을 제공하고 곡에 비음악적인 사운
 구글, ‘도큐먼트’와 ‘킵’에 음성 기반 안내 기능 도입
구글은 ‘구글 I/O’ 개발자 컨퍼런스에서 ‘문서’, ‘킵’, ‘지메일’과 같은 워크스페이스 앱에 음성 기반 프롬프트 기능을 도입한다고 발표했습니다. 이 기능을 통해 사용자는 음성으로 문서 초안을 작성하고, 메모를 남기며, 이메일을 검색할 수 있습니다.Docs에서는 음성만으로 문서 초안을 작성할 수 있습니다. TechCrunch가 시연한 데모에서 한 사용자
 골드만삭스 출신과 메타 공동 창업자들이 소외된 시장을 겨냥한 음성 AI를 개발 중
고객 지원 및 서비스는 오늘날 음성 AI 분야에서 가장 주목받는 분야 중 하나입니다. 하지만 사람처럼 자연스러운 음성을 내고 지연 시간을 최소화하며 응답하는 제품을 개발하는 일은 일부 시장에서 다른 시장보다 훨씬 더 어려운 과제이며, 대부분의 주요 기업들은 아프리카와 중동 시장을 염두에 두고 제품을 설계하지 않았습니다.이러한 격차를 해소하기 위해 작년에 설

2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai

2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai

2026년 최신 최고 평점을 받은 최고의 AI 회의 요약 도구로, 명확한 의사 결정 추적과 손쉬운 후속 조치를 실현하세요. 이 엄선된 목록은 회의록 자동화, 핵심 실행 과제 파악, 모든 프로젝트에 걸친 팀 협업 효율화를 통해 생산성을 획기적으로 높여주는 강력하고 혁신적인 솔루션을 소개합니다. 무료 버전과 유료 버전의 비교 정보, 실제 사용 후기, 매주 업데이트되는 순위 정보를 통해 여러분에게 딱 맞는 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
9 도구
xix.ai

2026년 최신의 우수하고 높은 평가를 받는 AI 데이터 정제 도구들로, 누락된 값과 중복 데이터를 신속하게 수정할 수 있습니다. 이 선별된 목록에는 생산성을 획기적으로 향상시켜 주는 강력한 솔루션이 포함되어 있습니다. 각 도구는 신뢰성을 보장하기 위해 엄격한 실제 환경 테스트를 거쳤습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 귀하의 요구사항에 가장 적합한 도구를 발견해 보세요. 지금 바로 XIX.AI에서 자세히 알아보시고 AI 분야에서의 경쟁 우위를 확보하세요.
11 도구
xix.ai

I just tried out Mistral’s new open-source TTS model yesterday, and its pronunciation is way more natural than most free options I’ve used before. It’s super useful for companies that want to build their own voice assistants without spending tons on licensed services. Do you think this will change the game in the enterprise voice AI market?












