


 首页
GPT-5.6 IQ突破130天才线,比99%的人类更聪明,实际工作能力也非同寻常
追踪AI的最新离线智商评估显示,OpenAI的GPT-5.6的多个迭代版本均取得了136分的成绩,这是大型语言模型首次突破130智商基准。在标准的人类分布中,130的智商标志着“天才”的门槛,全球仅有1%的人口达到这一水平,从而将GPT-5.6定位为比99%的人更智能。
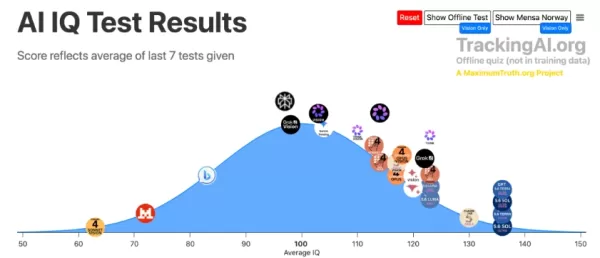
在最具挑战性、防泄露的题库中,GPT-5.6取得了136分,显著优于其竞争对手。
Tracking AI使用了两种不同的测试框架:一个是开源的门诺斯挪威风格考试,模型在此考试中已超过140分;另一个是专有的、未公开的离线题库,旨在防止预先记忆。GPT-5.6成功应对了这一具有挑战性的离线数据集,整个SOL和TERRA家族均获得136分,包括其视觉变体。Claude-5 Fable紧随其后,得分为130分,而GPT-5.6 LUNA Max和Claude-4.8 Opus则介于117至123分之间。尽管从o3到各种旗舰系统的模型历史上一直停滞在130分的门槛上,但GPT-5.6已成为首个突破这一界限的模型。
除了测试分数外,GPT-5.6在实际应用中也表现出卓越的性能。
高测试指标并不能保证实用性。开发者在现实场景中评估GPT-5.6,结果令人瞩目。当开发者Amir Bohlooli向Fable5和GPT-5.6 Sol提交相同的物理模拟提示时,他原本预期Fable会占据主导地位。然而,GPT-5.6 Sol执行了带有实时物理效果的粒子流体模拟,将CSS、界面设计和渲染封装在一个HTML文件中。它自动托管结果作为一个可分享的网页,仅通过一个提示就交付了一个完整的产品。同样,Ramanpal Singh使用RAG通过一个提示开发了一个客户工单系统,包含四个不同的角色、管理后台、自动投诉分类和情感识别。这种复杂的设置所需的成本仅为Fable5的一小部分。
Claire Vo的经历突显了这些实际优势。在遇到一个她认为导致代码崩溃的持续错误后,她切换到GPT-5.6 Sol,并评论道:“我不会让这个问题打败我。”Sol立即解决了该问题,并协助其他模型顺利运行。Vo的评价非常明确:Fable对技术精确性的僵化关注阻碍了其有效性,而Sol的务实方法则带来了切实的成果。
相关文章
 微软公布 MAI 系列模型,以多元化人工智能战略,摆脱对单一巨型模型的依赖
微软首席执行官萨提亚·纳德拉在最近的一次季度财报电话会议上强调,公司正在加速企业采用多模型架构,同时加大对自有AI模型、智能体和安全解决方案的投资,以最大限度地减少对任何单一领先AI实验室的依赖。微软最近公布了强劲的财务业绩。在截至6月30日的财年中,总收入达到3318亿美元,净利润为1337亿美元;最新一个季度的收入为900亿美元,净利润为358亿美元。在AI快速增长的背景下,微软仍然是全球领先的云服务和SaaS提供商之一,并持有OpenAI和Anthropic的重要股份。然而,纳德拉强调,企
世界模型公司守护秘密
上周,我在 All In 会议(与播客无关)上主持了一场关于世界模型的讨论,深入探讨了人工智能中最神秘的领域之一。Yann LeCun 的 AMI Labs 和 Fei-Fei Li 的 World Labs 等行业领袖引发了巨大关注并获得了大量资金,但他们在商业化方面的进展却明显缓慢。世界模型的基础旨在实现空间智能的自动化,从而为从机器人技术和互动视频到高级自动驾驶系统等各种潜在盈利的应用打开大门。然而,当我追问具体的商业化时间表时,答案变得模糊不清。小组中最具权威性的声音是 AMI La
竞争对手的 AI 代理 Instinct 和 Meta 的 Muse 现已支持呼叫功能
基于旧金山的 Instinct 已成为该领域的领先竞争者,吸引了大量投资者兴趣,据报道其估值已达 100 亿美元。文本型 AI 助手市场竞争激烈,Instinct、Wajo、Town、Ollie 以及 Meta 新推出的 Muse 助手均在争夺用户注意力和任务管理市场。随着新通话功能的推出,Instinct 的人气预计将进一步扩大,允许其助手充当数字礼宾,代表用户拨打电话。该领域的另一主要参与者 Meta 的 Muse 也实施了类似功能。Instinct 创始人 Noah Shinn 在 X
相关专题推荐
设计与艺术
 最佳 AI 绘画生成工具:探索灵感板、风格及视觉方向
2026年最新最佳AI艺术生成工具排行榜为您呈现了那些评分最高的工具,它们能够帮助您打造令人惊叹的构思板、探索多种不同的风格,并确定视觉创作方向。XIX.AI精心整理了一份包含经过严格实际测试、具备强大功能且能带来颠覆性体验的工具清单。您还可以查看免费版与付费版的对比信息,从而找到最适合提升创意工作流程的工具。立即探索,让AI助力您的艺术创作更上一层楼。
 10 个工具
 xix.ai
营销
适用于 Shopify 的 AI 邮件个性化平台:用于客户引流、客户留存和客户回流
2026年最新最佳Shopify Flows AI邮件个性化平台,助您提升用户留存率并挽回流失客户。这份精心筛选的高评分清单汇集了经过实际测试、功能强大且能改变游戏规则的工具,并提供了免费版与付费版的对比分析。XIX.AI 便是我们值得信赖的精选之一。立即发现最适合您的工具,释放您的AI优势。立即探索!
9 个工具
xix.ai
漫画创作
最适合网络漫画创作者的最佳AI漫画生成器
2026 年最新最佳 AI 漫画生成器,专为 Webtoon 创作者打造!XIX.AI 精心策划了一份顶级评分列表,包含强大且能改变游戏规则的工具,帮助创作者显著提升生产力。您将找到每周更新的详细排名、免费与付费版的对比以及真实世界测试,助您选择最合适的工具。提供必试选项,以克服创作瓶颈并更快交付高质量内容。立即探索,发现您完美契合的智能漫画制作工具!
9 个工具
xix.ai
设计与艺术
面向数字艺术家的AI插画工具
2026年最新最佳高评分AI插画工具,专为数字艺术家打造!XIX.AI精心甄选了一系列功能强大、颠覆行业的顶级工具,旨在帮助艺术家充分释放创造力。这些最佳选项包含每周更新的排名、实际测试结果以及免费版与付费版的详细对比,助您找到最适合的工具,从而提升工作流程效率。 无论您处于何种技能水平,这里都有值得一试的选项——立即探索,发现最适合您的工具!
17 个工具
xix.ai
漫画创作
Webtoon创作者必备的最佳AI漫画排版工具
2026年最新最受欢迎的AI漫画排版工具,专为Webtoon创作者打造!XIX.AI精心精选了一系列功能强大、颠覆性的必试工具,这些工具均经过严格的实际应用测试。 您将看到每周更新的详细排行榜、免费版与付费版的对比信息,以及这些工具如何提升您的工作效率、帮助您更快地创作高质量内容并充分释放您的创作潜能。立即探索,找到最适合您的工具!
9 个工具
xix.ai
设计
适用于 B2B SaaS 平台、管理面板及数据密集型产品的 AI 仪表板线框图设计工具
2026年最优秀的AI仪表板线框图设计工具大全,专为B2B SaaS平台、管理面板以及数据量庞大的产品打造!XIX.AI精心筛选出了一批经过严格实际测试、性能卓越的顶尖工具,并整理成了评分最高的清单。您可以在其中找到免费的与付费版本的详细对比数据、全面的排名信息,以及实用的参考建议,帮助您选出最合适的工具,从而提升工作效率并优化工作流程。立即探索,让AI助力您取得竞争优势!
8 个工具
xix.ai

 评论 (0)
0/500
追踪AI的最新离线智商评估显示,OpenAI的GPT-5.6的多个迭代版本均取得了136分的成绩,这是大型语言模型首次突破130智商基准。在标准的人类分布中,130的智商标志着“天才”的门槛,全球仅有1%的人口达到这一水平,从而将GPT-5.6定位为比99%的人更智能。
在最具挑战性、防泄露的题库中,GPT-5.6取得了136分,显著优于其竞争对手。
Tracking AI使用了两种不同的测试框架:一个是开源的门诺斯挪威风格考试,模型在此考试中已超过140分;另一个是专有的、未公开的离线题库,旨在防止预先记忆。GPT-5.6成功应对了这一具有挑战性的离线数据集,整个SOL和TERRA家族均获得136分,包括其视觉变体。Claude-5 Fable紧随其后,得分为130分,而GPT-5.6 LUNA Max和Claude-4.8 Opus则介于117至123分之间。尽管从o3到各种旗舰系统的模型历史上一直停滞在130分的门槛上,但GPT-5.6已成为首个突破这一界限的模型。
除了测试分数外,GPT-5.6在实际应用中也表现出卓越的性能。
高测试指标并不能保证实用性。开发者在现实场景中评估GPT-5.6,结果令人瞩目。当开发者Amir Bohlooli向Fable5和GPT-5.6 Sol提交相同的物理模拟提示时,他原本预期Fable会占据主导地位。然而,GPT-5.6 Sol执行了带有实时物理效果的粒子流体模拟,将CSS、界面设计和渲染封装在一个HTML文件中。它自动托管结果作为一个可分享的网页,仅通过一个提示就交付了一个完整的产品。同样,Ramanpal Singh使用RAG通过一个提示开发了一个客户工单系统,包含四个不同的角色、管理后台、自动投诉分类和情感识别。这种复杂的设置所需的成本仅为Fable5的一小部分。
Claire Vo的经历突显了这些实际优势。在遇到一个她认为导致代码崩溃的持续错误后,她切换到GPT-5.6 Sol,并评论道:“我不会让这个问题打败我。”Sol立即解决了该问题,并协助其他模型顺利运行。Vo的评价非常明确:Fable对技术精确性的僵化关注阻碍了其有效性,而Sol的务实方法则带来了切实的成果。








 微软公布 MAI 系列模型,以多元化人工智能战略,摆脱对单一巨型模型的依赖
微软首席执行官萨提亚·纳德拉在最近的一次季度财报电话会议上强调,公司正在加速企业采用多模型架构,同时加大对自有AI模型、智能体和安全解决方案的投资,以最大限度地减少对任何单一领先AI实验室的依赖。微软最近公布了强劲的财务业绩。在截至6月30日的财年中,总收入达到3318亿美元,净利润为1337亿美元;最新一个季度的收入为900亿美元,净利润为358亿美元。在AI快速增长的背景下,微软仍然是全球领先的云服务和SaaS提供商之一,并持有OpenAI和Anthropic的重要股份。然而,纳德拉强调,企
 世界模型公司守护秘密
上周,我在 All In 会议(与播客无关)上主持了一场关于世界模型的讨论,深入探讨了人工智能中最神秘的领域之一。Yann LeCun 的 AMI Labs 和 Fei-Fei Li 的 World Labs 等行业领袖引发了巨大关注并获得了大量资金,但他们在商业化方面的进展却明显缓慢。世界模型的基础旨在实现空间智能的自动化,从而为从机器人技术和互动视频到高级自动驾驶系统等各种潜在盈利的应用打开大门。然而,当我追问具体的商业化时间表时,答案变得模糊不清。小组中最具权威性的声音是 AMI La
 竞争对手的 AI 代理 Instinct 和 Meta 的 Muse 现已支持呼叫功能
基于旧金山的 Instinct 已成为该领域的领先竞争者,吸引了大量投资者兴趣,据报道其估值已达 100 亿美元。文本型 AI 助手市场竞争激烈,Instinct、Wajo、Town、Ollie 以及 Meta 新推出的 Muse 助手均在争夺用户注意力和任务管理市场。随着新通话功能的推出,Instinct 的人气预计将进一步扩大,允许其助手充当数字礼宾,代表用户拨打电话。该领域的另一主要参与者 Meta 的 Muse 也实施了类似功能。Instinct 创始人 Noah Shinn 在 X
2026年最新最佳AI艺术生成工具排行榜为您呈现了那些评分最高的工具,它们能够帮助您打造令人惊叹的构思板、探索多种不同的风格,并确定视觉创作方向。XIX.AI精心整理了一份包含经过严格实际测试、具备强大功能且能带来颠覆性体验的工具清单。您还可以查看免费版与付费版的对比信息,从而找到最适合提升创意工作流程的工具。立即探索,让AI助力您的艺术创作更上一层楼。
10 个工具
xix.ai
2026年最新最佳Shopify Flows AI邮件个性化平台,助您提升用户留存率并挽回流失客户。这份精心筛选的高评分清单汇集了经过实际测试、功能强大且能改变游戏规则的工具,并提供了免费版与付费版的对比分析。XIX.AI 便是我们值得信赖的精选之一。立即发现最适合您的工具,释放您的AI优势。立即探索!
9 个工具
xix.ai
2026 年最新最佳 AI 漫画生成器,专为 Webtoon 创作者打造!XIX.AI 精心策划了一份顶级评分列表,包含强大且能改变游戏规则的工具,帮助创作者显著提升生产力。您将找到每周更新的详细排名、免费与付费版的对比以及真实世界测试,助您选择最合适的工具。提供必试选项,以克服创作瓶颈并更快交付高质量内容。立即探索,发现您完美契合的智能漫画制作工具!
9 个工具
xix.ai
2026年最新最佳高评分AI插画工具,专为数字艺术家打造!XIX.AI精心甄选了一系列功能强大、颠覆行业的顶级工具,旨在帮助艺术家充分释放创造力。这些最佳选项包含每周更新的排名、实际测试结果以及免费版与付费版的详细对比,助您找到最适合的工具,从而提升工作流程效率。 无论您处于何种技能水平,这里都有值得一试的选项——立即探索,发现最适合您的工具!
17 个工具
xix.ai
2026年最新最受欢迎的AI漫画排版工具,专为Webtoon创作者打造!XIX.AI精心精选了一系列功能强大、颠覆性的必试工具,这些工具均经过严格的实际应用测试。 您将看到每周更新的详细排行榜、免费版与付费版的对比信息,以及这些工具如何提升您的工作效率、帮助您更快地创作高质量内容并充分释放您的创作潜能。立即探索,找到最适合您的工具!
9 个工具
xix.ai
2026年最优秀的AI仪表板线框图设计工具大全,专为B2B SaaS平台、管理面板以及数据量庞大的产品打造!XIX.AI精心筛选出了一批经过严格实际测试、性能卓越的顶尖工具,并整理成了评分最高的清单。您可以在其中找到免费的与付费版本的详细对比数据、全面的排名信息,以及实用的参考建议,帮助您选出最合适的工具,从而提升工作效率并优化工作流程。立即探索,让AI助力您取得竞争优势!
8 个工具
xix.ai












