


 Heim
GPT-5.6 IQ übertrifft die 130-Grenze für Genie, intelligenter als 99 % der Menschen, praktische Arbeitsfähigkeit ebenfalls außergewöhnlich
Die Verfolgung der neuesten Offline-IQ-Bewertung von KI zeigt, dass mehrere Iterationen von OpenAIs GPT-5.6 einen Wert von 136 erreichten, was den ersten Fall markiert, in dem ein großes Sprachmodell die IQ-Grenze von 130 überschreitet. In der normalen menschlichen Verteilung bedeutet ein IQ von 130 die Schwelle für „Genie“, ein Niveau, das nur 1 % der Weltbevölkerung erreicht, was GPT-5.6 effektiv intelligenter macht als 99 % der Menschen.
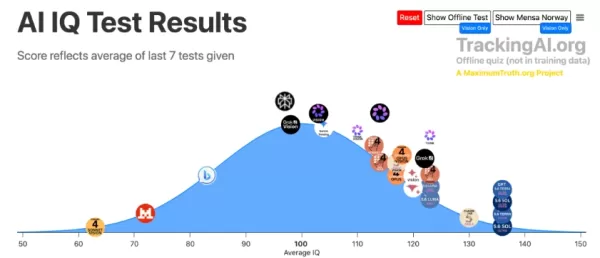
Mit einem Wert von 136 im strengsten, gegen Lecks geschützten Fragebank-System übertraf GPT-5.6 seine Konkurrenten deutlich.
Tracking AI nutzte zwei verschiedene Testrahmen: einen Open-Source-Mensa-Norwegen-ähnlichen Test, bei dem Modelle bereits Werte über 140 erreichten, und eine proprietäre, nicht offengelegte Offline-Fragebank, die darauf ausgelegt ist, vorzeitiges Auswendiglernen zu verhindern. GPT-5.6 bewältigte diese anspruchsvolle Offline-Datensammlung erfolgreich, wobei die gesamte SOL- und TERRA-Familie einen Wert von 136 erreichte, einschließlich seiner visuellen Variante. Claude-5 Fable folgte mit 130 Punkten, während GPT-5.6 LUNA Max und Claude-4.8 Opus zwischen 117 und 123 Punkten zurückblieben. Während Modelle von o3 bis hin zu verschiedenen Flaggschiff-Systemen historisch gesehen bei der 130-Grenze stagnierten, war GPT-5.6 das erste, das diesen Durchbruch schaffte.
Über die Testergebnisse hinaus zeigt GPT-5.6 außergewöhnliche Leistung in praktischen Anwendungen.
Hohe Testwerte allein garantieren keine Nützlichkeit. Entwickler bewerteten GPT-5.6 in realen Szenarien mit beeindruckenden Ergebnissen. Als der Entwickler Amir Bohlooli ein identisches physikalisches Simulationsprompt sowohl an Fable5 als auch an GPT-5.6 Sol sandte, erwartete er die Dominanz von Fable. Stattdessen führte GPT-5.6 Sol eine Partikelflüssigkeitssimulation mit Echtzeitphysik durch, die CSS, Interface-Design und Rendering in einer einzigen HTML-Datei zusammenfasste. Es hostete das Ergebnis automatisch als teilbare Webseite und lieferte ein vollständiges Produkt aus einem einzigen Prompt. Ebenso entwickelte Ramanpal Singh ein Kundensupport-Ticketsystem unter Verwendung von RAG mit einem einzigen Prompt, das vier verschiedene Rollen, ein Management-Backend, automatische Beschwerdeklassifizierung und Emotionserkennung integrierte. Diese komplexe Einrichtung kostete nur einen Bruchteil der mit Fable5 verbundenen Kosten.
Claire Vos Erfahrung unterstrich diese praktischen Vorteile. Nach dem Auftreten eines hartnäckigen Fehlers, den sie für einen Absturz ihres Codes hielt, wechselte sie zu GPT-5.6 Sol und bemerkte: „Ich werde mich davon nicht besiegen lassen.“ Sol behob das Problem sofort und half anderen Modellen, reibungslos zu laufen. Vos Bewertung war klar: Fables starrer Fokus auf technische Präzision behinderte seine Effektivität, während Sols pragmatischer Ansatz greifbare Ergebnisse lieferte.
Verwandter Artikel
 Microsoft stellt die MAI-Serie vor, um die KI-Strategie über ein einzelnes Großmodell hinaus zu diversifizieren
Satya Nadella, CEO von Microsoft, hob während des jüngsten Quartals-Gesprächs zur Ergebnisveröffentlichung hervor, dass das Unternehmen die Einführung von Multi-Model-Architekturen in Unternehmen beschleunigt und gleichzeitig die Investitionen in pro
Weltmodellfirmen hüten Geheimnisse
Letzte Woche moderierte ich eine Diskussion über Weltmodelle auf der All-In-Konferenz (unabhängig vom Podcast) und bot einen tiefgehenden Einblick in einen der rätselhaftesten Bereiche der KI. Branchenführer wie Yann LeCuns AMI Labs und Fei-Fei Lis W
Die Rival-KI-Agenten Instinct und Meta’s Muse unterstützen nun Anruf-Funktionen
Der Markt für textbasierte KI-Assistenten ist äußerst wettbewerbsintensiv, wobei Instinct, Wajo, Town, Ollie und der neu eingeführte Muse-Agent von Meta alle um die Aufmerksamkeit der Nutzer und das Aufgabenmanagement konkurrieren. Instinct mit Sitz
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Kunstgeneratoren: Entdecken Sie Moodboards, Stile und visuelle Richtungen
Die neueste Rangliste der besten KI-Kunstgeneratoren von 2026 präsentiert die am höchsten bewerteten Tools zur Erstellung beeindruckender Moodboards, zum Erkunden vielfältiger Stile sowie zur Festlegung visueller Richtungen. XIX.AI bietet eine sorgfältig ausgewählte Liste leistungsstarker, bahnbrechender Optionen, die strenge Prüfungen in der Praxis bestanden haben. Erhalten Sie einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Nutzung, um das optimale Tool für Ihre kreative Arbeitsweise zu finden. Entdecken Sie jetzt, wie Sie Ihren Vorteil in der KI-gestützten Kunstschaffung nutzen können.
 10 Tools
 xix.ai
Marketing
KI-basierte E-Mail-Personalisierungsplattformen für Shopify: Kundenbindung, Kundenbindung und Rückgewinnung
Die besten KI-Plattformen zur E-Mail-Personalisierung für Shopify im Jahr 2026: Workflows, die die Kundenbindung stärken und Kunden zurückgewinnen. Diese sorgfältig zusammengestellte Liste der bestbewerteten Tools enthält leistungsstarke, bahnbrechende Lösungen, die in der Praxis getestet wurden, sowie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. XIX.AI gehört zu unserer bewährten Auswahl. Entdecken Sie noch heute das perfekte Tool, um Ihren KI-Vorteil zu nutzen. Jetzt entdecken!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Comic-Generatoren für Webtoon-Ersteller
2026 Neueste und beste KI-Comic-Generatoren für Webtoon-Ersteller! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die Entwicklern helfen, ihre Produktivität erheblich zu steigern. Sie finden detaillierte, wöchentlich aktualisierte Rankings, Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen sowie praxisnahe Tests, um Ihnen bei der Auswahl des idealen Tools zu helfen. Empfohlene Optionen stehen zur Verfügung, um Erstellungshürden zu überwinden und qualitativ hochwertige Inhalte schneller bereitzustellen. Entdecken Sie jetzt Ihr perfektes Tool für smarteres Comic-Machen!
9 Tools
xix.ai
Design & Kunst
KI-Illustrationstools für digitale Künstler
Die besten und am besten bewerteten KI-Illustrationstools für Digitalkünstler im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung der besten Tools zusammengestellt, die Künstlern dabei helfen sollen, ihr volles kreatives Potenzial auszuschöpfen. Diese Top-Empfehlungen umfassen wöchentlich aktualisierte Rankings, Praxistests sowie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie das perfekte Tool finden, um die Effizienz Ihres Arbeitsablaufs zu steigern. Hier finden Sie empfehlenswerte Optionen für alle Erfahrungsstufen – stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool!
17 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Manga-Layouts für Webtoon-Autoren
Die besten und am besten bewerteten KI-Tools für Manga-Layouts für Webtoon-Autoren im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung von Tools zusammengestellt, die Sie unbedingt ausprobieren sollten und die strengen Tests in der Praxis durchlaufen haben. Hier finden Sie detaillierte, wöchentlich aktualisierte Rankings, Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Einblicke, wie diese Tools Ihren Arbeitsablauf optimieren, Ihnen helfen können, hochwertige Inhalte schneller zu erstellen, und Ihr volles kreatives Potenzial freisetzen. Stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool!
9 Tools
xix.ai
Design
Wireframing-Tools für AI-Dashboards in B2B-SaaS-Lösungen, Admin-Panels sowie datenintensiven Produkten
2026 – Die neuesten und besten Tools für das Wireframing von AI-Dashboards für B2B-SaaS-Lösungen, Admin-Panels sowie datenintensive Produkte! XIX.AI hat eine Liste der am besten bewerteten, leistungsstarken Tools zusammengestellt, die strenge Prüfungen im echten Einsatz durchlaufen haben, um hervorragende Ergebnisse zu liefern. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Versionen, umfassende Ranglisten sowie wertvolle Erkenntnisse, die Ihnen dabei helfen, die ideale Lösung zu wählen, um Ihre Produktivität zu steigern und Ihren Arbeitsablauf zu optimieren. Entdecken Sie sie jetzt, um Ihren Wettbewerbsvorteil durch KI zu erlangen!
8 Tools
xix.ai

 Kommentare (0)
Die Verfolgung der neuesten Offline-IQ-Bewertung von KI zeigt, dass mehrere Iterationen von OpenAIs GPT-5.6 einen Wert von 136 erreichten, was den ersten Fall markiert, in dem ein großes Sprachmodell die IQ-Grenze von 130 überschreitet. In der normalen menschlichen Verteilung bedeutet ein IQ von 130 die Schwelle für „Genie“, ein Niveau, das nur 1 % der Weltbevölkerung erreicht, was GPT-5.6 effektiv intelligenter macht als 99 % der Menschen.
Mit einem Wert von 136 im strengsten, gegen Lecks geschützten Fragebank-System übertraf GPT-5.6 seine Konkurrenten deutlich.
Tracking AI nutzte zwei verschiedene Testrahmen: einen Open-Source-Mensa-Norwegen-ähnlichen Test, bei dem Modelle bereits Werte über 140 erreichten, und eine proprietäre, nicht offengelegte Offline-Fragebank, die darauf ausgelegt ist, vorzeitiges Auswendiglernen zu verhindern. GPT-5.6 bewältigte diese anspruchsvolle Offline-Datensammlung erfolgreich, wobei die gesamte SOL- und TERRA-Familie einen Wert von 136 erreichte, einschließlich seiner visuellen Variante. Claude-5 Fable folgte mit 130 Punkten, während GPT-5.6 LUNA Max und Claude-4.8 Opus zwischen 117 und 123 Punkten zurückblieben. Während Modelle von o3 bis hin zu verschiedenen Flaggschiff-Systemen historisch gesehen bei der 130-Grenze stagnierten, war GPT-5.6 das erste, das diesen Durchbruch schaffte.
Über die Testergebnisse hinaus zeigt GPT-5.6 außergewöhnliche Leistung in praktischen Anwendungen.
Hohe Testwerte allein garantieren keine Nützlichkeit. Entwickler bewerteten GPT-5.6 in realen Szenarien mit beeindruckenden Ergebnissen. Als der Entwickler Amir Bohlooli ein identisches physikalisches Simulationsprompt sowohl an Fable5 als auch an GPT-5.6 Sol sandte, erwartete er die Dominanz von Fable. Stattdessen führte GPT-5.6 Sol eine Partikelflüssigkeitssimulation mit Echtzeitphysik durch, die CSS, Interface-Design und Rendering in einer einzigen HTML-Datei zusammenfasste. Es hostete das Ergebnis automatisch als teilbare Webseite und lieferte ein vollständiges Produkt aus einem einzigen Prompt. Ebenso entwickelte Ramanpal Singh ein Kundensupport-Ticketsystem unter Verwendung von RAG mit einem einzigen Prompt, das vier verschiedene Rollen, ein Management-Backend, automatische Beschwerdeklassifizierung und Emotionserkennung integrierte. Diese komplexe Einrichtung kostete nur einen Bruchteil der mit Fable5 verbundenen Kosten.
Claire Vos Erfahrung unterstrich diese praktischen Vorteile. Nach dem Auftreten eines hartnäckigen Fehlers, den sie für einen Absturz ihres Codes hielt, wechselte sie zu GPT-5.6 Sol und bemerkte: „Ich werde mich davon nicht besiegen lassen.“ Sol behob das Problem sofort und half anderen Modellen, reibungslos zu laufen. Vos Bewertung war klar: Fables starrer Fokus auf technische Präzision behinderte seine Effektivität, während Sols pragmatischer Ansatz greifbare Ergebnisse lieferte.








 Microsoft stellt die MAI-Serie vor, um die KI-Strategie über ein einzelnes Großmodell hinaus zu diversifizieren
Satya Nadella, CEO von Microsoft, hob während des jüngsten Quartals-Gesprächs zur Ergebnisveröffentlichung hervor, dass das Unternehmen die Einführung von Multi-Model-Architekturen in Unternehmen beschleunigt und gleichzeitig die Investitionen in pro
 Weltmodellfirmen hüten Geheimnisse
Letzte Woche moderierte ich eine Diskussion über Weltmodelle auf der All-In-Konferenz (unabhängig vom Podcast) und bot einen tiefgehenden Einblick in einen der rätselhaftesten Bereiche der KI. Branchenführer wie Yann LeCuns AMI Labs und Fei-Fei Lis W
 Die Rival-KI-Agenten Instinct und Meta’s Muse unterstützen nun Anruf-Funktionen
Der Markt für textbasierte KI-Assistenten ist äußerst wettbewerbsintensiv, wobei Instinct, Wajo, Town, Ollie und der neu eingeführte Muse-Agent von Meta alle um die Aufmerksamkeit der Nutzer und das Aufgabenmanagement konkurrieren. Instinct mit Sitz

Die neueste Rangliste der besten KI-Kunstgeneratoren von 2026 präsentiert die am höchsten bewerteten Tools zur Erstellung beeindruckender Moodboards, zum Erkunden vielfältiger Stile sowie zur Festlegung visueller Richtungen. XIX.AI bietet eine sorgfältig ausgewählte Liste leistungsstarker, bahnbrechender Optionen, die strenge Prüfungen in der Praxis bestanden haben. Erhalten Sie einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Nutzung, um das optimale Tool für Ihre kreative Arbeitsweise zu finden. Entdecken Sie jetzt, wie Sie Ihren Vorteil in der KI-gestützten Kunstschaffung nutzen können.
10 Tools
xix.ai
Die besten KI-Plattformen zur E-Mail-Personalisierung für Shopify im Jahr 2026: Workflows, die die Kundenbindung stärken und Kunden zurückgewinnen. Diese sorgfältig zusammengestellte Liste der bestbewerteten Tools enthält leistungsstarke, bahnbrechende Lösungen, die in der Praxis getestet wurden, sowie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. XIX.AI gehört zu unserer bewährten Auswahl. Entdecken Sie noch heute das perfekte Tool, um Ihren KI-Vorteil zu nutzen. Jetzt entdecken!
9 Tools
xix.ai
2026 Neueste und beste KI-Comic-Generatoren für Webtoon-Ersteller! XIX.AI hat eine hochbewertete Liste leistungsstarker, bahnbrechender Tools zusammengestellt, die Entwicklern helfen, ihre Produktivität erheblich zu steigern. Sie finden detaillierte, wöchentlich aktualisierte Rankings, Vergleiche zwischen kostenlosen und kostenpflichtigen Versionen sowie praxisnahe Tests, um Ihnen bei der Auswahl des idealen Tools zu helfen. Empfohlene Optionen stehen zur Verfügung, um Erstellungshürden zu überwinden und qualitativ hochwertige Inhalte schneller bereitzustellen. Entdecken Sie jetzt Ihr perfektes Tool für smarteres Comic-Machen!
9 Tools
xix.ai
Die besten und am besten bewerteten KI-Illustrationstools für Digitalkünstler im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung der besten Tools zusammengestellt, die Künstlern dabei helfen sollen, ihr volles kreatives Potenzial auszuschöpfen. Diese Top-Empfehlungen umfassen wöchentlich aktualisierte Rankings, Praxistests sowie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie das perfekte Tool finden, um die Effizienz Ihres Arbeitsablaufs zu steigern. Hier finden Sie empfehlenswerte Optionen für alle Erfahrungsstufen – stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool!
17 Tools
xix.ai
Die besten und am besten bewerteten KI-Tools für Manga-Layouts für Webtoon-Autoren im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung von Tools zusammengestellt, die Sie unbedingt ausprobieren sollten und die strengen Tests in der Praxis durchlaufen haben. Hier finden Sie detaillierte, wöchentlich aktualisierte Rankings, Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Einblicke, wie diese Tools Ihren Arbeitsablauf optimieren, Ihnen helfen können, hochwertige Inhalte schneller zu erstellen, und Ihr volles kreatives Potenzial freisetzen. Stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool!
9 Tools
xix.ai
2026 – Die neuesten und besten Tools für das Wireframing von AI-Dashboards für B2B-SaaS-Lösungen, Admin-Panels sowie datenintensive Produkte! XIX.AI hat eine Liste der am besten bewerteten, leistungsstarken Tools zusammengestellt, die strenge Prüfungen im echten Einsatz durchlaufen haben, um hervorragende Ergebnisse zu liefern. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Versionen, umfassende Ranglisten sowie wertvolle Erkenntnisse, die Ihnen dabei helfen, die ideale Lösung zu wählen, um Ihre Produktivität zu steigern und Ihren Arbeitsablauf zu optimieren. Entdecken Sie sie jetzt, um Ihren Wettbewerbsvorteil durch KI zu erlangen!
8 Tools
xix.ai












