


 首頁
GPT-5.6 IQ突破130天才線,比99%的人類更聰明,實際工作能力也非同尋常
追蹤AI的最新離線智商評估顯示,OpenAI的GPT-5.6的多個迭代版本均取得了136分的成績,這是大型語言模型首次突破130智商基準。在標準的人類分佈中,130的智商標誌著“天才”的門檻,全球僅有1%的人口達到這一水平,從而將GPT-5.6定位為比99%的人更智慧。
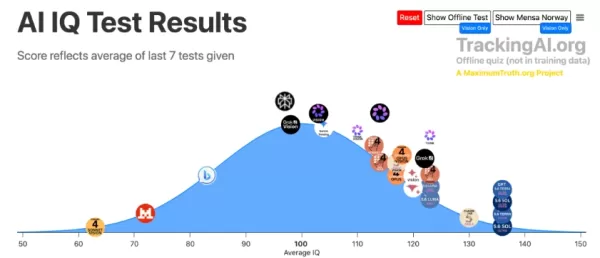
在最具挑戰性、防洩露的題庫中,GPT-5.6取得了136分,顯著優於其競爭對手。
Tracking AI使用了兩種不同的測試框架:一個是開源的門諾斯挪威風格考試,模型在此考試中已超過140分;另一個是專有的、未公開的離線題庫,旨在防止預先記憶。GPT-5.6成功應對了這一具有挑戰性的離線資料集,整個SOL和TERRA家族均獲得136分,包括其視覺變體。Claude-5 Fable緊隨其後,得分為130分,而GPT-5.6 LUNA Max和Claude-4.8 Opus則介於117至123分之間。儘管從o3到各種旗艦系統的模型歷史上一直停滯在130分的門檻上,但GPT-5.6已成為首個突破這一界限的模型。
除了測試分數外,GPT-5.6在實際應用中也表現出卓越的效能。
高測試指標並不能保證實用性。開發者在現實場景中評估GPT-5.6,結果令人矚目。當開發者Amir Bohlooli向Fable5和GPT-5.6 Sol提交相同的物理模擬提示時,他原本預期Fable會佔據主導地位。然而,GPT-5.6 Sol執行了帶有實時物理效果的粒子流體模擬,將CSS、介面設計和渲染封裝在一個HTML檔案中。它自動託管結果作為一個可分享的網頁,僅透過一個提示就交付了一個完整的產品。同樣,Ramanpal Singh使用RAG透過一個提示開發了一個客戶工單系統,包含四個不同的角色、管理後臺、自動投訴分類和情感識別。這種複雜的設定所需的成本僅為Fable5的一小部分。
Claire Vo的經歷突顯了這些實際優勢。在遇到一個她認為導致程式碼崩潰的持續錯誤後,她切換到GPT-5.6 Sol,並評論道:“我不會讓這個問題打敗我。”Sol立即解決了該問題,並協助其他模型順利執行。Vo的評價非常明確:Fable對技術精確性的僵化關注阻礙了其有效性,而Sol的務實方法則帶來了切實的成果。
相關文章
 如何免費查看 Google 排名?
無法追蹤的 QR 碼,純屬猜測。您將它印出來,抱持著期望,卻永遠無法得知它是否奏效。追蹤功能能將這種猜測轉化為數據:有多少人掃描、他們身在何處、使用何種裝置,以及何時進行掃描。 本指南將說明您可以衡量哪些指標、如何設定具備追蹤功能的 QR 碼、如何解讀數據,以及如何將這些數據與您其他資料所儲存的工具進行整合。文中以 Uniqode 作為實作範例,但這些原則同樣適用於任何具備追蹤功能的工具。每個 Q
微軟公佈 MAI 系列模型,以多元化人工智慧戰略,擺脫對單一巨型模型的依賴
微軟執行長薩提亞·納德拉在最近的一次季度財報電話會議上強調,公司正在加速企業採用多模型架構,同時加大對自有AI模型、智慧體和安全解決方案的投資,以最大限度地減少對任何單一領先AI實驗室的依賴。微軟最近公佈了強勁的財務業績。在截至6月30日的財年中,總收入達到3318億美元,淨利潤為1337億美元;最新一個季度的收入為900億美元,淨利潤為358億美元。在AI快速增長的背景下,微軟仍然是全球領先的雲服務和SaaS提供商之一,並持有OpenAI和Anthropic的重要股份。然而,納德拉強調,企
世界模型公司守護秘密
上週,我在 All In 會議(與播客無關)上主持了一場關於世界模型的討論,深入探討了人工智慧中最神秘的領域之一。Yann LeCun 的 AMI Labs 和 Fei-Fei Li 的 World Labs 等行業領袖引發了巨大關注並獲得了大量資金,但他們在商業化方面的進展卻明顯緩慢。世界模型的基礎旨在實現空間智慧的自動化,從而為從機器人技術和互動影片到高階自動駕駛系統等各種潛在盈利的應用開啟大門。然而,當我追問具體的商業化時間表時,答案變得模糊不清。小組中最具權威性的聲音是 AMI La
相關專題推薦
設計與藝術
 最佳 AI 繪畫生成工具:探索靈感板、風格及視覺方向
2026年最新最佳AI藝術生成工具排行榜為您呈現了那些評分最高的工具,它們能夠幫助您打造令人驚歎的構思板、探索多種不同的風格,並確定視覺創作方向。XIX.AI精心整理了一份包含經過嚴格實際測試、具備強大功能且能帶來顛覆性體驗的工具清單。您還可以檢視免費版與付費版的對比資訊,從而找到最適合提升創意工作流程的工具。立即探索,讓AI助力您的藝術創作更上一層樓。
 10 個工具
 xix.ai
行銷
適用於 Shopify 的 AI 電子郵件個人化平台:流量、客戶留存與回流策略
2026 年最新最佳 AI 電子郵件個人化平台,專為 Shopify Flows 設計,能有效提升客戶留存率並促進回流。這份經過嚴格篩選且廣受好評的清單,收錄了經過實際環境測試、功能強大且能徹底改變遊戲規則的工具,並提供免費與付費版本的比較分析。XIX.AI 便是我們精選的值得信賴的工具之一。立即探索,找到最適合您的工具,釋放您的 AI 競爭優勢。現在就來探索吧!
9 個工具
xix.ai
漫畫創作
最適合網路漫畫創作者的最佳AI漫畫生成器
2026 年最新最佳 AI 漫畫生成器,專為 Webtoon 創作者打造!XIX.AI 精心策劃了一份頂級評分列表,包含強大且能改變遊戲規則的工具,幫助創作者顯著提升生產力。您將找到每週更新的詳細排名、免費與付費版的對比以及真實世界測試,助您選擇最合適的工具。提供必試選項,以克服創作瓶頸並更快交付高質量內容。立即探索,發現您完美契合的智慧漫畫製作工具!
9 個工具
xix.ai
設計與藝術
適用於數位藝術家的 AI 插畫工具
2026 年數位藝術家必備的最新、最佳、最高評分 AI 插畫工具!XIX.AI 精心精選了一系列功能強大且具革命性的頂尖工具,旨在協助藝術家充分釋放其創作潛能。這些最佳選項包含每週更新的排行榜、實際測試結果,以及免費與付費版本的詳細比較,助您找到最適合的工具,從而提升工作流程效率。 無論您具備何種技術水平,這裡都有值得一試的選擇——立即探索,發現最適合您的工具!
17 個工具
xix.ai
漫畫創作
最適合 Webtoon 創作者的 AI 漫畫排版工具
2026 年最新、最受好評的 AI 漫畫排版工具,專為 Webtoon 創作者打造!XIX.AI 精心精選了一系列功能強大、顛覆業界的必試工具,這些工具均經過嚴格的實際測試。 您將找到每週更新的詳細排行榜、免費與付費版本的比較資訊,以及這些工具如何提升您的工作流程、協助您更快創作高品質內容,並充分釋放您的創作潛能的深入解析。立即探索,找出最適合您的工具!
9 個工具
xix.ai
設計
適用於 B2B SaaS 平臺、管理面板及資料密集型產品的 AI 儀表板線框圖設計工具
2026年最優秀的AI儀表板線框圖設計工具大全,專為B2B SaaS平臺、管理面板以及資料量龐大的產品打造!XIX.AI精心篩選出了一批經過嚴格實際測試、效能卓越的頂尖工具,並整理成了評分最高的清單。您可以在其中找到免費的與付費版本的詳細對比資料、全面的排名資訊,以及實用的參考建議,幫助您選出最合適的工具,從而提升工作效率並最佳化工作流程。立即探索,讓AI助力您取得競爭優勢!
8 個工具
xix.ai

 評論 (0)
0/500
追蹤AI的最新離線智商評估顯示,OpenAI的GPT-5.6的多個迭代版本均取得了136分的成績,這是大型語言模型首次突破130智商基準。在標準的人類分佈中,130的智商標誌著“天才”的門檻,全球僅有1%的人口達到這一水平,從而將GPT-5.6定位為比99%的人更智慧。
在最具挑戰性、防洩露的題庫中,GPT-5.6取得了136分,顯著優於其競爭對手。
Tracking AI使用了兩種不同的測試框架:一個是開源的門諾斯挪威風格考試,模型在此考試中已超過140分;另一個是專有的、未公開的離線題庫,旨在防止預先記憶。GPT-5.6成功應對了這一具有挑戰性的離線資料集,整個SOL和TERRA家族均獲得136分,包括其視覺變體。Claude-5 Fable緊隨其後,得分為130分,而GPT-5.6 LUNA Max和Claude-4.8 Opus則介於117至123分之間。儘管從o3到各種旗艦系統的模型歷史上一直停滯在130分的門檻上,但GPT-5.6已成為首個突破這一界限的模型。
除了測試分數外,GPT-5.6在實際應用中也表現出卓越的效能。
高測試指標並不能保證實用性。開發者在現實場景中評估GPT-5.6,結果令人矚目。當開發者Amir Bohlooli向Fable5和GPT-5.6 Sol提交相同的物理模擬提示時,他原本預期Fable會佔據主導地位。然而,GPT-5.6 Sol執行了帶有實時物理效果的粒子流體模擬,將CSS、介面設計和渲染封裝在一個HTML檔案中。它自動託管結果作為一個可分享的網頁,僅透過一個提示就交付了一個完整的產品。同樣,Ramanpal Singh使用RAG透過一個提示開發了一個客戶工單系統,包含四個不同的角色、管理後臺、自動投訴分類和情感識別。這種複雜的設定所需的成本僅為Fable5的一小部分。
Claire Vo的經歷突顯了這些實際優勢。在遇到一個她認為導致程式碼崩潰的持續錯誤後,她切換到GPT-5.6 Sol,並評論道:“我不會讓這個問題打敗我。”Sol立即解決了該問題,並協助其他模型順利執行。Vo的評價非常明確:Fable對技術精確性的僵化關注阻礙了其有效性,而Sol的務實方法則帶來了切實的成果。








 如何免費查看 Google 排名?
無法追蹤的 QR 碼,純屬猜測。您將它印出來,抱持著期望,卻永遠無法得知它是否奏效。追蹤功能能將這種猜測轉化為數據:有多少人掃描、他們身在何處、使用何種裝置,以及何時進行掃描。 本指南將說明您可以衡量哪些指標、如何設定具備追蹤功能的 QR 碼、如何解讀數據,以及如何將這些數據與您其他資料所儲存的工具進行整合。文中以 Uniqode 作為實作範例,但這些原則同樣適用於任何具備追蹤功能的工具。每個 Q
 微軟公佈 MAI 系列模型,以多元化人工智慧戰略,擺脫對單一巨型模型的依賴
微軟執行長薩提亞·納德拉在最近的一次季度財報電話會議上強調,公司正在加速企業採用多模型架構,同時加大對自有AI模型、智慧體和安全解決方案的投資,以最大限度地減少對任何單一領先AI實驗室的依賴。微軟最近公佈了強勁的財務業績。在截至6月30日的財年中,總收入達到3318億美元,淨利潤為1337億美元;最新一個季度的收入為900億美元,淨利潤為358億美元。在AI快速增長的背景下,微軟仍然是全球領先的雲服務和SaaS提供商之一,並持有OpenAI和Anthropic的重要股份。然而,納德拉強調,企
 世界模型公司守護秘密
上週,我在 All In 會議(與播客無關)上主持了一場關於世界模型的討論,深入探討了人工智慧中最神秘的領域之一。Yann LeCun 的 AMI Labs 和 Fei-Fei Li 的 World Labs 等行業領袖引發了巨大關注並獲得了大量資金,但他們在商業化方面的進展卻明顯緩慢。世界模型的基礎旨在實現空間智慧的自動化,從而為從機器人技術和互動影片到高階自動駕駛系統等各種潛在盈利的應用開啟大門。然而,當我追問具體的商業化時間表時,答案變得模糊不清。小組中最具權威性的聲音是 AMI La

2026年最新最佳AI藝術生成工具排行榜為您呈現了那些評分最高的工具,它們能夠幫助您打造令人驚歎的構思板、探索多種不同的風格,並確定視覺創作方向。XIX.AI精心整理了一份包含經過嚴格實際測試、具備強大功能且能帶來顛覆性體驗的工具清單。您還可以檢視免費版與付費版的對比資訊,從而找到最適合提升創意工作流程的工具。立即探索,讓AI助力您的藝術創作更上一層樓。
10 個工具
xix.ai
2026 年最新最佳 AI 電子郵件個人化平台,專為 Shopify Flows 設計,能有效提升客戶留存率並促進回流。這份經過嚴格篩選且廣受好評的清單,收錄了經過實際環境測試、功能強大且能徹底改變遊戲規則的工具,並提供免費與付費版本的比較分析。XIX.AI 便是我們精選的值得信賴的工具之一。立即探索,找到最適合您的工具,釋放您的 AI 競爭優勢。現在就來探索吧!
9 個工具
xix.ai
2026 年最新最佳 AI 漫畫生成器,專為 Webtoon 創作者打造!XIX.AI 精心策劃了一份頂級評分列表,包含強大且能改變遊戲規則的工具,幫助創作者顯著提升生產力。您將找到每週更新的詳細排名、免費與付費版的對比以及真實世界測試,助您選擇最合適的工具。提供必試選項,以克服創作瓶頸並更快交付高質量內容。立即探索,發現您完美契合的智慧漫畫製作工具!
9 個工具
xix.ai
2026 年數位藝術家必備的最新、最佳、最高評分 AI 插畫工具!XIX.AI 精心精選了一系列功能強大且具革命性的頂尖工具,旨在協助藝術家充分釋放其創作潛能。這些最佳選項包含每週更新的排行榜、實際測試結果,以及免費與付費版本的詳細比較,助您找到最適合的工具,從而提升工作流程效率。 無論您具備何種技術水平,這裡都有值得一試的選擇——立即探索,發現最適合您的工具!
17 個工具
xix.ai
2026 年最新、最受好評的 AI 漫畫排版工具,專為 Webtoon 創作者打造!XIX.AI 精心精選了一系列功能強大、顛覆業界的必試工具,這些工具均經過嚴格的實際測試。 您將找到每週更新的詳細排行榜、免費與付費版本的比較資訊,以及這些工具如何提升您的工作流程、協助您更快創作高品質內容,並充分釋放您的創作潛能的深入解析。立即探索,找出最適合您的工具!
9 個工具
xix.ai
2026年最優秀的AI儀表板線框圖設計工具大全,專為B2B SaaS平臺、管理面板以及資料量龐大的產品打造!XIX.AI精心篩選出了一批經過嚴格實際測試、效能卓越的頂尖工具,並整理成了評分最高的清單。您可以在其中找到免費的與付費版本的詳細對比資料、全面的排名資訊,以及實用的參考建議,幫助您選出最合適的工具,從而提升工作效率並最佳化工作流程。立即探索,讓AI助力您取得競爭優勢!
8 個工具
xix.ai












