


 Дом
GPT-5.6 IQ превышает отметку 130, что соответствует уровню гения, и превосходит по интеллекту 99% людей, при этом его практические рабочие способности также остаются на исключительном уровне.
Отслеживание последних офлайн-оценок интеллекта ИИ показывает, что несколько итераций GPT-5.6 от OpenAI достигли результата 136, что стало первым случаем, когда большая языковая модель превысила порог в 130 единиц IQ. В стандартном распределении человеческих показателей IQ значение 130 означает порог «гениальности», уровень, достигаемый лишь 1% мирового населения, что фактически позиционирует GPT-5.6 как более интеллектуальную систему, чем 99% людей.
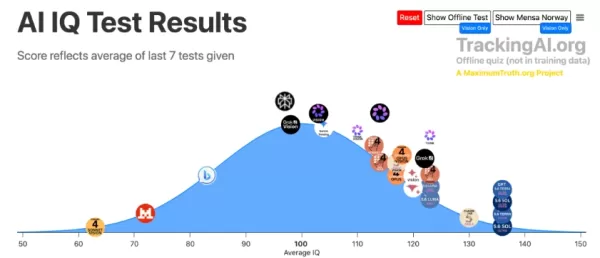
Показав результат 136 на самом строгом банке вопросов с защитой от утечек, GPT-5.6 значительно превзошла своих конкурентов.
Компания Tracking AI использовала две различные системы тестирования: открытый экзамен по типу Mensa Норвегии, где модели уже превышали отметку в 140 баллов, и проприетарный закрытый офлайн-банк вопросов, разработанный для предотвращения предварительного заучивания. GPT-5.6 успешно справилась с этим сложным офлайн-набором данных, при этом вся семья SOL и TERRA набрала 136 баллов, включая ее визуальный вариант. Claude-5 Fable показала результат 130 баллов, тогда как GPT-5.6 LUNA Max и Claude-4.8 Opus отстали, показав результаты в диапазоне от 117 до 123 баллов. Хотя модели от o3 до различных флагманских систем исторически достигали плато на отметке 130, GPT-5.6 стала первой, преодолевшей этот барьер.
Помимо высоких результатов тестов, GPT-5.6 демонстрирует исключительную производительность в практических приложениях.
Высокие показатели тестов сами по себе не гарантируют полезности. Разработчики оценили GPT-5.6 в реальных сценариях, получив впечатляющие результаты. Когда разработчик Амир Бхолули отправил одинаковый промпт для физической симуляции как в Fable5, так и в GPT-5.6 Sol, он ожидал доминирования Fable. Вместо этого GPT-5.6 Sol выполнила симуляцию частиц жидкости с физикой в реальном времени, объединив CSS, дизайн интерфейса и рендеринг в одном HTML-файле. Она автоматически разместила результат в виде доступной для обмена веб-страницы, предоставив готовый продукт по одному промпту. Аналогичным образом Раманпал Сингх создал систему обработки клиентских заявок с использованием RAG по одному промпту, включив четыре различные роли, панель управления бэкэнда, автоматическую классификацию жалоб и распознавание эмоций. Эта сложная настройка потребовала лишь доли затрат, связанных с Fable5.
Опыт Клер Во подчеркнул эти практические преимущества. Столкнувшись с устойчивой ошибкой, которую она считала причиной сбоя своего кода, она переключилась на GPT-5.6 Sol, remarkнув: «Я не позволю этому победить меня». Sol немедленно решила проблему и помогла другим моделям работать гладко. Оценка Во была четкой: жесткий фокус Fable на технической точности препятствовал ее эффективности, тогда как прагматичный подход Sol обеспечил ощутимые результаты.
Связанная статья
 Microsoft представила модели серии MAI для диверсификации стратегии в области искусственного интеллекта, выходящей за рамки одного гигантского решения.
Сатья Наделла, генеральный директор Microsoft, подчеркнул во время недавнего квартального звонка по результатам деятельности, что компания ускоряет внедрение многорежимных архитектур в корпоративном секторе, одновременно увеличивая инвестиции в собст
Компании, разрабатывающие модели мира, охраняют свои секреты
На прошлой неделе я модерировал обсуждение мировых моделей на конференции All In (не связанной с подкастом), предоставив глубокий анализ одного из самых загадочных секторов искусственного интеллекта. Ведущие отраслевые лидеры, такие как лаборатории A
Агенты Rival AI Instinct и Meta Muse теперь поддерживают функции вызовов
Рынок текстовых ИИ-ассистентов отличается высокой конкуренцией: Instinct, Wajo, Town, Ollie и недавно запущенный агент Meta Muse борются за внимание пользователей и управление задачами. Штаб-квартира Instinct находится в Сан-Франциско; компания стала
Рекомендации по связанным специальным темам
Дизайн и искусство
 Лучшие генераторы искусства на основе ИИ: ознакомьтесь с мудбордами, стилями и визуальными направлениями
2026 год: Топ-рейтинг лучших генераторов искусства на основе ИИ показывает самые популярные инструменты для создания впечатляющих мудбордов, исследования разнообразных стилей и формирования визуального направления. XIX.AI предлагает тщательно отобранный список мощных решений, прошедших строгие тестирования в реальных условиях. Получите бесплатное сравнение версий с платными, чтобы выбрать оптимальный вариант для улучшения вашей творческой работы. Ознакомьтесь сейчас, чтобы раскрыть потенциал ИИ в создании произведений искусства.
 10 инструментов
 xix.ai
Маркетинг
Платформы искусственного интеллекта для персонализации электронной почты в Shopify: оптимизация потоков, удержание клиентов и возвращение утраченных клиентов
2026: лучшие современные платформы для персонализации электронной почты с помощью ИИ для Shopify Flows, которые повышают удержание клиентов и способствуют их возвращению. В этом тщательно отобранном списке лучших решений представлены мощные, революционные инструменты, прошедшие проверку на практике, а также сравнительная информация о бесплатных и платных версиях. XIX.AI входит в наш список проверенных решений. Найдите свой идеальный инструмент, чтобы уже сегодня воспользоваться преимуществами ИИ. Узнайте больше прямо сейчас!
9 инструментов
xix.ai
Создание комиксов
Лучшие генераторы комиксов на базе ИИ для авторов веб-комиксов
2026: Лучшие генераторы комиксов на базе ИИ для авторов веб-комиксов! XIX.AI подготовила список самых высокооцененных мощных инструментов, которые кардинально меняют правила игры и помогают авторам значительно повысить продуктивность. Здесь вы найдёте подробные рейтинги, обновляемые еженедельно, сравнение бесплатных и платных версий, а также результаты реальных тестов, которые помогут вам выбрать идеальный вариант. Доступны варианты, которые обязательно стоит попробовать, чтобы преодолеть творческие препятствия и быстрее создавать высококачественный контент. Изучите их прямо сейчас, чтобы найти свой идеальный инструмент для более эффективного создания комиксов!
9 инструментов
xix.ai
Дизайн и искусство
Инструменты искусственного интеллекта для создания иллюстраций, предназначенные для цифровых художников
2026: Новейшие и лучшие инструменты для создания иллюстраций с помощью ИИ для цифровых художников! XIX.AI подготовил подборку мощных, революционных инструментов, призванных помочь художникам раскрыть весь свой творческий потенциал. Эти лучшие варианты сопровождаются еженедельно обновляемыми рейтингами, результатами реальных тестов и подробным сравнением бесплатных и платных версий, что поможет вам найти идеальный вариант для повышения эффективности вашего рабочего процесса. Здесь представлены варианты, которые обязательно стоит попробовать независимо от уровня мастерства — ознакомьтесь с ними прямо сейчас, чтобы найти свой идеальный инструмент!
17 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для верстки манги с использованием ИИ для авторов веб-комиксов
2026: лучшие и самые популярные инструменты для верстки манги на базе ИИ для авторов веб-тунов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать и которые прошли тщательные тесты в реальных условиях. Здесь вы найдете подробные рейтинги, обновляемые еженедельно, сравнение бесплатных и платных версий, а также рекомендации о том, как эти инструменты могут ускорить ваш рабочий процесс, помочь быстрее создавать высококачественный контент и раскрыть весь ваш творческий потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
дизайн
Инструменты для создания прототипов панелей управления AI для B2B-решений типа SaaS, административных панелей и продуктов с большим объемом данных
2026 год: лучшие инструменты для создания прототипов дашбордов на основе ИИ, доступные в настоящее время для B2B-решений типа SaaS, панелей управления и продуктов с большим объемом данных! XIX.AI подготовил список самых высоко оцененных инструментов, способных кардинально изменить работу с такими системами, пройдших строгие тестирования в реальных условиях для обеспечения выдающихся результатов. Здесь вы найдете подробные сравнения бесплатных и платных версий, полные рейтинги, а также полезные рекомендации, которые помогут выбрать идеальное решение для повышения производительности и оптимизации рабочего процесса. Ознакомьтесь с предложениями прямо сейчас, чтобы получить преимущество от использования технологий ИИ!
8 инструментов
xix.ai

 Комментарии (0)
Отслеживание последних офлайн-оценок интеллекта ИИ показывает, что несколько итераций GPT-5.6 от OpenAI достигли результата 136, что стало первым случаем, когда большая языковая модель превысила порог в 130 единиц IQ. В стандартном распределении человеческих показателей IQ значение 130 означает порог «гениальности», уровень, достигаемый лишь 1% мирового населения, что фактически позиционирует GPT-5.6 как более интеллектуальную систему, чем 99% людей.
Показав результат 136 на самом строгом банке вопросов с защитой от утечек, GPT-5.6 значительно превзошла своих конкурентов.
Компания Tracking AI использовала две различные системы тестирования: открытый экзамен по типу Mensa Норвегии, где модели уже превышали отметку в 140 баллов, и проприетарный закрытый офлайн-банк вопросов, разработанный для предотвращения предварительного заучивания. GPT-5.6 успешно справилась с этим сложным офлайн-набором данных, при этом вся семья SOL и TERRA набрала 136 баллов, включая ее визуальный вариант. Claude-5 Fable показала результат 130 баллов, тогда как GPT-5.6 LUNA Max и Claude-4.8 Opus отстали, показав результаты в диапазоне от 117 до 123 баллов. Хотя модели от o3 до различных флагманских систем исторически достигали плато на отметке 130, GPT-5.6 стала первой, преодолевшей этот барьер.
Помимо высоких результатов тестов, GPT-5.6 демонстрирует исключительную производительность в практических приложениях.
Высокие показатели тестов сами по себе не гарантируют полезности. Разработчики оценили GPT-5.6 в реальных сценариях, получив впечатляющие результаты. Когда разработчик Амир Бхолули отправил одинаковый промпт для физической симуляции как в Fable5, так и в GPT-5.6 Sol, он ожидал доминирования Fable. Вместо этого GPT-5.6 Sol выполнила симуляцию частиц жидкости с физикой в реальном времени, объединив CSS, дизайн интерфейса и рендеринг в одном HTML-файле. Она автоматически разместила результат в виде доступной для обмена веб-страницы, предоставив готовый продукт по одному промпту. Аналогичным образом Раманпал Сингх создал систему обработки клиентских заявок с использованием RAG по одному промпту, включив четыре различные роли, панель управления бэкэнда, автоматическую классификацию жалоб и распознавание эмоций. Эта сложная настройка потребовала лишь доли затрат, связанных с Fable5.
Опыт Клер Во подчеркнул эти практические преимущества. Столкнувшись с устойчивой ошибкой, которую она считала причиной сбоя своего кода, она переключилась на GPT-5.6 Sol, remarkнув: «Я не позволю этому победить меня». Sol немедленно решила проблему и помогла другим моделям работать гладко. Оценка Во была четкой: жесткий фокус Fable на технической точности препятствовал ее эффективности, тогда как прагматичный подход Sol обеспечил ощутимые результаты.








 Microsoft представила модели серии MAI для диверсификации стратегии в области искусственного интеллекта, выходящей за рамки одного гигантского решения.
Сатья Наделла, генеральный директор Microsoft, подчеркнул во время недавнего квартального звонка по результатам деятельности, что компания ускоряет внедрение многорежимных архитектур в корпоративном секторе, одновременно увеличивая инвестиции в собст
 Компании, разрабатывающие модели мира, охраняют свои секреты
На прошлой неделе я модерировал обсуждение мировых моделей на конференции All In (не связанной с подкастом), предоставив глубокий анализ одного из самых загадочных секторов искусственного интеллекта. Ведущие отраслевые лидеры, такие как лаборатории A
 Агенты Rival AI Instinct и Meta Muse теперь поддерживают функции вызовов
Рынок текстовых ИИ-ассистентов отличается высокой конкуренцией: Instinct, Wajo, Town, Ollie и недавно запущенный агент Meta Muse борются за внимание пользователей и управление задачами. Штаб-квартира Instinct находится в Сан-Франциско; компания стала

2026 год: Топ-рейтинг лучших генераторов искусства на основе ИИ показывает самые популярные инструменты для создания впечатляющих мудбордов, исследования разнообразных стилей и формирования визуального направления. XIX.AI предлагает тщательно отобранный список мощных решений, прошедших строгие тестирования в реальных условиях. Получите бесплатное сравнение версий с платными, чтобы выбрать оптимальный вариант для улучшения вашей творческой работы. Ознакомьтесь сейчас, чтобы раскрыть потенциал ИИ в создании произведений искусства.
10 инструментов
xix.ai
2026: лучшие современные платформы для персонализации электронной почты с помощью ИИ для Shopify Flows, которые повышают удержание клиентов и способствуют их возвращению. В этом тщательно отобранном списке лучших решений представлены мощные, революционные инструменты, прошедшие проверку на практике, а также сравнительная информация о бесплатных и платных версиях. XIX.AI входит в наш список проверенных решений. Найдите свой идеальный инструмент, чтобы уже сегодня воспользоваться преимуществами ИИ. Узнайте больше прямо сейчас!
9 инструментов
xix.ai
2026: Лучшие генераторы комиксов на базе ИИ для авторов веб-комиксов! XIX.AI подготовила список самых высокооцененных мощных инструментов, которые кардинально меняют правила игры и помогают авторам значительно повысить продуктивность. Здесь вы найдёте подробные рейтинги, обновляемые еженедельно, сравнение бесплатных и платных версий, а также результаты реальных тестов, которые помогут вам выбрать идеальный вариант. Доступны варианты, которые обязательно стоит попробовать, чтобы преодолеть творческие препятствия и быстрее создавать высококачественный контент. Изучите их прямо сейчас, чтобы найти свой идеальный инструмент для более эффективного создания комиксов!
9 инструментов
xix.ai
2026: Новейшие и лучшие инструменты для создания иллюстраций с помощью ИИ для цифровых художников! XIX.AI подготовил подборку мощных, революционных инструментов, призванных помочь художникам раскрыть весь свой творческий потенциал. Эти лучшие варианты сопровождаются еженедельно обновляемыми рейтингами, результатами реальных тестов и подробным сравнением бесплатных и платных версий, что поможет вам найти идеальный вариант для повышения эффективности вашего рабочего процесса. Здесь представлены варианты, которые обязательно стоит попробовать независимо от уровня мастерства — ознакомьтесь с ними прямо сейчас, чтобы найти свой идеальный инструмент!
17 инструментов
xix.ai
2026: лучшие и самые популярные инструменты для верстки манги на базе ИИ для авторов веб-тунов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать и которые прошли тщательные тесты в реальных условиях. Здесь вы найдете подробные рейтинги, обновляемые еженедельно, сравнение бесплатных и платных версий, а также рекомендации о том, как эти инструменты могут ускорить ваш рабочий процесс, помочь быстрее создавать высококачественный контент и раскрыть весь ваш творческий потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для себя!
9 инструментов
xix.ai
2026 год: лучшие инструменты для создания прототипов дашбордов на основе ИИ, доступные в настоящее время для B2B-решений типа SaaS, панелей управления и продуктов с большим объемом данных! XIX.AI подготовил список самых высоко оцененных инструментов, способных кардинально изменить работу с такими системами, пройдших строгие тестирования в реальных условиях для обеспечения выдающихся результатов. Здесь вы найдете подробные сравнения бесплатных и платных версий, полные рейтинги, а также полезные рекомендации, которые помогут выбрать идеальное решение для повышения производительности и оптимизации рабочего процесса. Ознакомьтесь с предложениями прямо сейчас, чтобы получить преимущество от использования технологий ИИ!
8 инструментов
xix.ai












