


 Maison
GPT-5.6 IQ dépasse la ligne de génie de 130, plus intelligent que 99 % des humains, et ses capacités pratiques de travail sont également extraordinaires
Le suivi des dernières évaluations d’IQ hors ligne de l’IA révèle que plusieurs itérations de GPT-5.6 d’OpenAI ont obtenu un score de 136, marquant la première fois qu’un modèle de langage large (LLM) dépassait le seuil de référence de 130 d’IQ. Dans la distribution humaine standard, un IQ de 130 représente le seuil du « génie », un niveau atteint par seulement 1 % de la population mondiale, positionnant ainsi GPT-5.6 comme étant plus intelligent que 99 % des personnes.
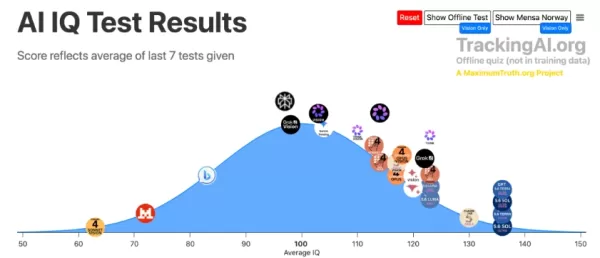
Avec un score de 136 sur la banque de questions la plus rigoureuse et anti-fuites, GPT-5.6 a largement surpassé ses concurrents.
Tracking AI a utilisé deux cadres de test distincts : un examen open source de style Mensa Norvège, où les modèles ont déjà dépassé 140 points, et une banque de questions hors ligne propriétaire et non divulguée conçue pour empêcher la mémorisation préalable. GPT-5.6 a réussi à naviguer dans cet ensemble de données hors ligne difficile, l’ensemble de la famille SOL et TERRA obtenant 136, y compris sa variante visuelle. Claude-5 Fable a suivi avec 130 points, tandis que GPT-5.6 LUNA Max et Claude-4.8 Opus se situaient entre 117 et 123 points. Bien que les modèles allant de o3 à divers systèmes phares aient historiquement plafonné au seuil de 130, GPT-5.6 est devenu le premier à le franchir.
Au-delà des scores aux tests, GPT-5.6 démontre des performances exceptionnelles dans les applications pratiques.
Des métriques de test élevées ne garantissent pas à elles seules l’utilité. Les développeurs ont évalué GPT-5.6 dans des scénarios réels avec des résultats frappants. Lorsque le développeur Amir Bohlooli a soumis un prompt de simulation physique identique à la fois à Fable5 et à GPT-5.6 Sol, il anticipait la domination de Fable. Au lieu de cela, GPT-5.6 Sol a exécuté une simulation de fluide de particules avec physique en temps réel, encapsulant CSS, conception d’interface et rendu dans un seul fichier HTML. Il a automatiquement hébergé le résultat sous forme de page web partageable, fournissant un produit complet à partir d’un seul prompt. De même, Ramanpal Singh a développé un système de tickets clients en utilisant RAG avec un seul prompt, intégrant quatre rôles distincts, un backend de gestion, une classification automatisée des plaintes et la reconnaissance des émotions. Cette configuration complexe n’a nécessité qu’une fraction du coût associé à Fable5.
L’expérience de Claire Vo a mis en lumière ces avantages pratiques. Après avoir rencontré un bug persistant qu’elle croyait avoir fait planter son code, elle est passée à GPT-5.6 Sol, déclarant : « Je ne vais pas me laisser battre par cela. » Sol a résolu le problème immédiatement et a aidé d’autres modèles à fonctionner sans encombre. L’évaluation de Vo était claire : la rigidité de Fable, axée sur la précision technique, a entravé son efficacité, tandis que l’approche pragmatique de Sol a livré des résultats tangibles.
Article connexe
 Microsoft dévoile les modèles de la série MAI pour diversifier sa stratégie d’intelligence artificielle au-delà d’un seul modèle géant
Satya Nadella, PDG de Microsoft, a souligné lors du récent appel sur les résultats trimestriels que l’entreprise accélère l’adoption par les entreprises des architectures multi-modèles tout en augmentant ses investissements dans des modèles d’IA prop
Les entreprises de modèles mondiaux gardent des secrets
La semaine dernière, j’ai animé une discussion sur les modèles du monde lors de la conférence All In (sans lien avec le podcast), offrant un examen approfondi de l’un des secteurs les plus énigmatiques de l’IA. Des leaders de l’industrie tels que les
Les agents IA rivaux Instinct et Muse de Meta prennent désormais en charge les fonctionnalités d’appel
Le marché des assistants IA textuels est hautement concurrentiel, avec Instinct, Wajo, Town, Ollie et le nouvel agent Muse de Meta qui se disputent tous l'attention des utilisateurs et la gestion des tâches. Basée à San Francisco, Instinct s'est impo
Recommandations de sujets spéciaux liés
Conception et art
 Meilleurs générateurs d’art par IA : Découvrez des moodboards, des styles et des orientations visuelles
Le classement des meilleurs générateurs d’art IA de 2026 met en lumière les outils les plus appréciés pour créer des moodboards époustouflants, explorer divers styles et définir des directions visuelles. XIX.AI propose une liste sélectionnée d’options puissantes et révolutionnaires ayant réussi des tests rigoureux dans des conditions réelles. Consultez une comparaison gratuite et payante pour trouver celle qui correspond le mieux à vos besoins et améliorer ainsi votre flux de travail créatif. Découvrez dès maintenant comment tirer parti des avantages offerts par l’IA dans la création artistique.
 10 outils
 xix.ai
Commercialisation
Plateformes de personnalisation des e-mails basées sur l'IA pour les flux Shopify, la fidélisation et la reconquête des clients
Les meilleures plateformes de personnalisation des e-mails par IA pour Shopify en 2026 : des solutions qui stimulent la fidélisation et la reconquête des clients. Cette sélection triée sur le volet et très bien notée présente des outils puissants et révolutionnaires, testés en conditions réelles, et propose une comparaison entre les versions gratuites et payantes. XIX.AI fait partie de notre sélection de confiance. Découvrez dès aujourd’hui l’outil idéal pour tirer pleinement parti de l’IA. Explorez-la dès maintenant !
9 outils
xix.ai
Création de bande dessinée
Meilleurs générateurs de bandes dessinées par IA pour les créateurs de Webtoon
2026 Derniers Meilleurs Générateurs de Bandes Dessinées par IA pour les Créateurs de Webtoons ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et révolutionnaires qui aident les créateurs à augmenter considérablement leur productivité. Vous y trouverez des classements mis à jour chaque semaine, des comparaisons entre versions gratuites et payantes, ainsi que des tests en conditions réelles pour vous aider à choisir l’option la plus adaptée. Des options incontournables sont disponibles pour surmonner les goulots d’étranglement de la création et produire du contenu de haute qualité plus rapidement. Explorez dès maintenant pour découvrir l’outil parfait pour une création de bandes dessinées plus intelligente !
9 outils
xix.ai
Conception et art
Outils d'illustration basés sur l'IA pour les artistes numériques
Les meilleurs outils d'illustration IA les mieux notés de 2026 pour les artistes numériques ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires, conçus pour aider les artistes à libérer tout leur potentiel créatif. Ces meilleures options s'accompagnent de classements mis à jour chaque semaine, de tests en conditions réelles et d'une comparaison détaillée entre les versions gratuites et payantes, afin de vous aider à trouver l'outil idéal pour optimiser l'efficacité de votre flux de travail. Vous trouverez ici des choix incontournables pour tous les niveaux de compétence. Explorez-les dès maintenant pour découvrir l'outil qui vous convient le mieux !
17 outils
xix.ai
Création de bande dessinée
Les meilleurs outils d'agencement de mangas basés sur l'IA pour les créateurs de webtoons
Les meilleurs outils de mise en page de mangas basés sur l’IA de 2026, les mieux notés par les créateurs de webtoons ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires, incontournables, qui ont été soumis à des tests rigoureux en conditions réelles. Vous y trouverez des classements détaillés mis à jour chaque semaine, des comparaisons entre versions gratuites et payantes, ainsi que des conseils sur la manière dont ces outils peuvent optimiser votre flux de travail, vous aider à créer plus rapidement du contenu de haute qualité et libérer tout votre potentiel créatif. Explorez-les dès maintenant pour découvrir l'outil qui vous convient le mieux !
9 outils
xix.ai
conception
Outils de maquettage de tableau de bord IA pour les solutions SaaS B2B, les panneaux d’administration et les produits à forte charge de données
2026 : Les meilleures outils de maquettage de tableau de bord IA disponibles, conçus pour les solutions SaaS B2B, les panneaux d’administration et les produits à forte charge de données ! XIX.AI a sélectionné une liste des outils les plus performants, ayant été soumis à des tests rigoureux dans des conditions réelles afin d’offrir des résultats exceptionnels. Vous y trouverez des données de comparaison détaillées entre les versions gratuites et payantes, des classements complets ainsi que des analyses utiles pour vous aider à choisir la solution idéale afin d’améliorer votre productivité et d’optimiser vos processus de travail. Découvrez-les dès maintenant pour tirer parti pleinement des avantages offerts par l’IA !
8 outils
xix.ai

 commentaires (0)
Le suivi des dernières évaluations d’IQ hors ligne de l’IA révèle que plusieurs itérations de GPT-5.6 d’OpenAI ont obtenu un score de 136, marquant la première fois qu’un modèle de langage large (LLM) dépassait le seuil de référence de 130 d’IQ. Dans la distribution humaine standard, un IQ de 130 représente le seuil du « génie », un niveau atteint par seulement 1 % de la population mondiale, positionnant ainsi GPT-5.6 comme étant plus intelligent que 99 % des personnes.
Avec un score de 136 sur la banque de questions la plus rigoureuse et anti-fuites, GPT-5.6 a largement surpassé ses concurrents.
Tracking AI a utilisé deux cadres de test distincts : un examen open source de style Mensa Norvège, où les modèles ont déjà dépassé 140 points, et une banque de questions hors ligne propriétaire et non divulguée conçue pour empêcher la mémorisation préalable. GPT-5.6 a réussi à naviguer dans cet ensemble de données hors ligne difficile, l’ensemble de la famille SOL et TERRA obtenant 136, y compris sa variante visuelle. Claude-5 Fable a suivi avec 130 points, tandis que GPT-5.6 LUNA Max et Claude-4.8 Opus se situaient entre 117 et 123 points. Bien que les modèles allant de o3 à divers systèmes phares aient historiquement plafonné au seuil de 130, GPT-5.6 est devenu le premier à le franchir.
Au-delà des scores aux tests, GPT-5.6 démontre des performances exceptionnelles dans les applications pratiques.
Des métriques de test élevées ne garantissent pas à elles seules l’utilité. Les développeurs ont évalué GPT-5.6 dans des scénarios réels avec des résultats frappants. Lorsque le développeur Amir Bohlooli a soumis un prompt de simulation physique identique à la fois à Fable5 et à GPT-5.6 Sol, il anticipait la domination de Fable. Au lieu de cela, GPT-5.6 Sol a exécuté une simulation de fluide de particules avec physique en temps réel, encapsulant CSS, conception d’interface et rendu dans un seul fichier HTML. Il a automatiquement hébergé le résultat sous forme de page web partageable, fournissant un produit complet à partir d’un seul prompt. De même, Ramanpal Singh a développé un système de tickets clients en utilisant RAG avec un seul prompt, intégrant quatre rôles distincts, un backend de gestion, une classification automatisée des plaintes et la reconnaissance des émotions. Cette configuration complexe n’a nécessité qu’une fraction du coût associé à Fable5.
L’expérience de Claire Vo a mis en lumière ces avantages pratiques. Après avoir rencontré un bug persistant qu’elle croyait avoir fait planter son code, elle est passée à GPT-5.6 Sol, déclarant : « Je ne vais pas me laisser battre par cela. » Sol a résolu le problème immédiatement et a aidé d’autres modèles à fonctionner sans encombre. L’évaluation de Vo était claire : la rigidité de Fable, axée sur la précision technique, a entravé son efficacité, tandis que l’approche pragmatique de Sol a livré des résultats tangibles.








 Microsoft dévoile les modèles de la série MAI pour diversifier sa stratégie d’intelligence artificielle au-delà d’un seul modèle géant
Satya Nadella, PDG de Microsoft, a souligné lors du récent appel sur les résultats trimestriels que l’entreprise accélère l’adoption par les entreprises des architectures multi-modèles tout en augmentant ses investissements dans des modèles d’IA prop
 Les entreprises de modèles mondiaux gardent des secrets
La semaine dernière, j’ai animé une discussion sur les modèles du monde lors de la conférence All In (sans lien avec le podcast), offrant un examen approfondi de l’un des secteurs les plus énigmatiques de l’IA. Des leaders de l’industrie tels que les
 Les agents IA rivaux Instinct et Muse de Meta prennent désormais en charge les fonctionnalités d’appel
Le marché des assistants IA textuels est hautement concurrentiel, avec Instinct, Wajo, Town, Ollie et le nouvel agent Muse de Meta qui se disputent tous l'attention des utilisateurs et la gestion des tâches. Basée à San Francisco, Instinct s'est impo

Le classement des meilleurs générateurs d’art IA de 2026 met en lumière les outils les plus appréciés pour créer des moodboards époustouflants, explorer divers styles et définir des directions visuelles. XIX.AI propose une liste sélectionnée d’options puissantes et révolutionnaires ayant réussi des tests rigoureux dans des conditions réelles. Consultez une comparaison gratuite et payante pour trouver celle qui correspond le mieux à vos besoins et améliorer ainsi votre flux de travail créatif. Découvrez dès maintenant comment tirer parti des avantages offerts par l’IA dans la création artistique.
10 outils
xix.ai
Les meilleures plateformes de personnalisation des e-mails par IA pour Shopify en 2026 : des solutions qui stimulent la fidélisation et la reconquête des clients. Cette sélection triée sur le volet et très bien notée présente des outils puissants et révolutionnaires, testés en conditions réelles, et propose une comparaison entre les versions gratuites et payantes. XIX.AI fait partie de notre sélection de confiance. Découvrez dès aujourd’hui l’outil idéal pour tirer pleinement parti de l’IA. Explorez-la dès maintenant !
9 outils
xix.ai
2026 Derniers Meilleurs Générateurs de Bandes Dessinées par IA pour les Créateurs de Webtoons ! XIX.AI a sélectionné une liste hautement notée d’outils puissants et révolutionnaires qui aident les créateurs à augmenter considérablement leur productivité. Vous y trouverez des classements mis à jour chaque semaine, des comparaisons entre versions gratuites et payantes, ainsi que des tests en conditions réelles pour vous aider à choisir l’option la plus adaptée. Des options incontournables sont disponibles pour surmonner les goulots d’étranglement de la création et produire du contenu de haute qualité plus rapidement. Explorez dès maintenant pour découvrir l’outil parfait pour une création de bandes dessinées plus intelligente !
9 outils
xix.ai
Les meilleurs outils d'illustration IA les mieux notés de 2026 pour les artistes numériques ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires, conçus pour aider les artistes à libérer tout leur potentiel créatif. Ces meilleures options s'accompagnent de classements mis à jour chaque semaine, de tests en conditions réelles et d'une comparaison détaillée entre les versions gratuites et payantes, afin de vous aider à trouver l'outil idéal pour optimiser l'efficacité de votre flux de travail. Vous trouverez ici des choix incontournables pour tous les niveaux de compétence. Explorez-les dès maintenant pour découvrir l'outil qui vous convient le mieux !
17 outils
xix.ai
Les meilleurs outils de mise en page de mangas basés sur l’IA de 2026, les mieux notés par les créateurs de webtoons ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires, incontournables, qui ont été soumis à des tests rigoureux en conditions réelles. Vous y trouverez des classements détaillés mis à jour chaque semaine, des comparaisons entre versions gratuites et payantes, ainsi que des conseils sur la manière dont ces outils peuvent optimiser votre flux de travail, vous aider à créer plus rapidement du contenu de haute qualité et libérer tout votre potentiel créatif. Explorez-les dès maintenant pour découvrir l'outil qui vous convient le mieux !
9 outils
xix.ai
2026 : Les meilleures outils de maquettage de tableau de bord IA disponibles, conçus pour les solutions SaaS B2B, les panneaux d’administration et les produits à forte charge de données ! XIX.AI a sélectionné une liste des outils les plus performants, ayant été soumis à des tests rigoureux dans des conditions réelles afin d’offrir des résultats exceptionnels. Vous y trouverez des données de comparaison détaillées entre les versions gratuites et payantes, des classements complets ainsi que des analyses utiles pour vous aider à choisir la solution idéale afin d’améliorer votre productivité et d’optimiser vos processus de travail. Découvrez-les dès maintenant pour tirer parti pleinement des avantages offerts par l’IA !
8 outils
xix.ai












