


 Hogar
GPT-5.6 IQ supera la línea de genio de 130, más inteligente que el 99 % de los seres humanos, y su capacidad práctica de trabajo también es extraordinaria
El seguimiento de la última evaluación de CI fuera de línea de la IA revela que múltiples iteraciones del GPT-5.6 de OpenAI lograron una puntuación de 136, marcando la primera instancia en la que un modelo de lenguaje grande superó el umbral de CI de 130. En la distribución humana estándar, un CI de 130 significa el umbral para ser considerado “genio”, un nivel alcanzado por apenas el 1% de la población mundial, posicionando efectivamente al GPT-5.6 como más inteligente que el 99% de las personas.
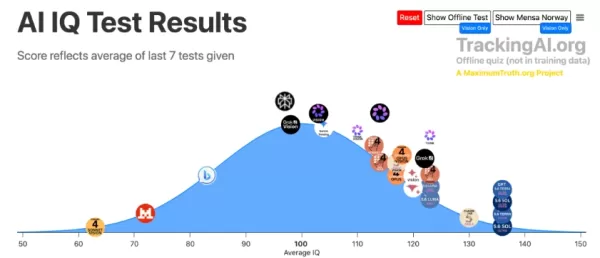
Al obtener 136 puntos en el banco de preguntas más riguroso y con mayor protección contra filtraciones, el GPT-5.6 superó significativamente a sus competidores.
Tracking AI utilizó dos marcos de prueba distintos: un examen de estilo Mensa Noruega de código abierto, donde los modelos ya superaban los 140 puntos, y un banco de preguntas offline propietario y no revelado diseñado para prevenir la memorización previa. El GPT-5.6 navegó con éxito este conjunto de datos offline desafiante, con toda la familia SOL y TERRA obteniendo 136 puntos, incluida su variante visual. Claude-5 Fable le siguió con 130 puntos, mientras que GPT-5.6 LUNA Max y Claude-4.8 Opus se quedaron entre 117 y 123 puntos. Aunque los modelos desde o3 hasta varios sistemas insignia han estancado históricamente en el umbral de 130, el GPT-5.6 se ha convertido en el primero en romperlo.
Más allá de las puntuaciones de prueba, el GPT-5.6 demuestra un rendimiento excepcional en aplicaciones prácticas.
Las altas métricas de prueba no garantizan por sí mismas utilidad. Los desarrolladores evaluaron el GPT-5.6 en escenarios del mundo real con resultados impactantes. Cuando el desarrollador Amir Bohlooli envió un prompt idéntico de simulación física tanto a Fable5 como a GPT-5.6 Sol, anticipaba la dominancia de Fable. En cambio, el GPT-5.6 Sol ejecutó una simulación de fluido de partículas con física en tiempo real, encapsulando CSS, diseño de interfaz y renderizado dentro de un único archivo HTML. Alojó automáticamente el resultado como una página web compartible, entregando un producto completo a partir de un solo prompt. De manera similar, Ramanpal Singh desarrolló un sistema de tickets de clientes utilizando RAG con un solo prompt, incorporando cuatro roles distintos, un panel de gestión backend, clasificación automatizada de quejas y reconocimiento de emociones. Esta configuración compleja requirió solo una fracción del costo asociado con Fable5.
La experiencia de Claire Vo destacó estas ventajas prácticas. Tras encontrarse con un error persistente que ella creía que había bloqueado su código, cambió al GPT-5.6 Sol, comentando: “No voy a dejar que esto me venza”. Sol resolvió el problema de inmediato y asistió a otros modelos para que funcionaran sin problemas. La evaluación de Vo fue clara: el enfoque rígido de Fable en la precisión técnica obstaculizó su eficacia, mientras que el enfoque pragmático de Sol entregó resultados tangibles.
Artículo relacionado
 ¿Cómo comprobar la posición en Google de forma gratuita?
Un código QR que no se puede rastrear es una mera suposición. Lo imprimes, cruzas los dedos y nunca llegas a saber si ha funcionado. El rastreo convierte esa suposición en datos: cuántas personas lo h
Microsoft presenta la serie de modelos MAI para diversificar su estrategia de IA más allá de un único gigante
Satya Nadella, director ejecutivo de Microsoft, destacó durante la reciente conferencia de ganancias trimestrales que la compañía está acelerando la adopción empresarial de arquitecturas multimodelo, al tiempo que aumenta las inversiones en modelos d
Las empresas de modelos mundiales guardan secretos
La semana pasada, facilité un debate sobre modelos del mundo en la conferencia All In (sin relación con el podcast), ofreciendo un análisis profundo de uno de los sectores más enigmáticos de la inteligencia artificial. Líderes del sector como AMI Lab
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Mejores generadores de arte con IA: Explore tableros de inspiración, estilos y direcciones visuales
El ranking de 2026 de los mejores generadores de arte con IA muestra las herramientas más valoradas para crear tableros de inspiración impresionantes, explorar estilos diversos y definir direcciones visuales. XIX.AI ofrece una lista cuidadosamente seleccionada de opciones potentes y revolucionarias que han superado pruebas rigurosas en entornos reales. Consulte una comparación gratuita con la versión de pago para ayudarse a encontrar la solución perfecta que potencie su flujo de trabajo creativo. Explórelo ahora y aproveche toda la ventaja que le brinda la IA en la creación artística.
 10 herramientas
 xix.ai
Marketing
Plataformas de personalización de correos electrónicos basadas en IA para los flujos de Shopify, la retención y la recuperación de clientes
Las mejores plataformas de personalización de correo electrónico con IA de 2026 para Shopify Flows que potencian la retención y la recuperación de clientes. Esta lista seleccionada y mejor valorada incluye potentes herramientas revolucionarias que han superado pruebas en el mundo real y ofrece información comparativa entre las opciones gratuitas y las de pago. XIX.AI forma parte de nuestra selección de confianza. Descubre hoy mismo la herramienta perfecta para sacar partido a tu ventaja competitiva con la IA. ¡Explora ahora!
9 herramientas
xix.ai
Creación de cómics
Los mejores generadores de cómics con IA para creadores de webtoons
¡Los mejores generadores de cómics con IA de 2026 para creadores de webtoons! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los creadores a aumentar su productividad de forma significativa. Encontrarás clasificaciones detalladas que se actualizan semanalmente, comparativas entre opciones gratuitas y de pago, y pruebas reales que te ayudarán a elegir la herramienta que mejor se adapte a tus necesidades. Hay opciones imprescindibles que te permitirán superar los cuellos de botella en la creación y ofrecer contenido de alta calidad más rápidamente. ¡Explora ahora mismo y descubre tu herramienta perfecta para crear cómics de forma más inteligente!
9 herramientas
xix.ai
Diseño y Arte
Herramientas de ilustración basadas en IA para artistas digitales
¡Las mejores herramientas de ilustración con IA mejor valoradas de 2026 para artistas digitales! XIX.AI ha seleccionado una potente colección de herramientas punteras, que suponen un punto de inflexión, diseñadas para ayudar a los artistas a liberar todo su potencial creativo. Estas mejores opciones incluyen clasificaciones actualizadas semanalmente, pruebas en condiciones reales y comparativas detalladas entre versiones gratuitas y de pago para ayudarte a encontrar la opción perfecta que potencie la eficiencia de tu flujo de trabajo. Aquí encontrarás opciones imprescindibles para todos los niveles de habilidad. ¡Explora ahora mismo y descubre tu herramienta perfecta!
17 herramientas
xix.ai
Creación de cómics
Las mejores herramientas de maquetación de manga basadas en IA para creadores de webtoons
¡Las mejores herramientas de maquetación de manga con IA mejor valoradas de 2026 para creadores de webtoons! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, y que han superado rigurosas pruebas en el mundo real. Encontrarás clasificaciones detalladas que se actualizan semanalmente, información comparativa entre versiones gratuitas y de pago, y consejos sobre cómo estas herramientas pueden optimizar tu flujo de trabajo, ayudarte a crear contenido de alta calidad más rápidamente y liberar todo tu potencial creativo. ¡Explora ahora mismo para descubrir tu herramienta perfecta!
9 herramientas
xix.ai
diseño
Herramientas de maqueta para paneles de control de IA destinadas a SaaS B2B, paneles de administración y productos con gran volumen de datos
¡Las mejores herramientas de wireframing para paneles de control de IA de 2026, ideales para SaaS B2B, paneles de administración y productos con grandes volúmenes de datos! XIX.AI ha elaborado una lista de las herramientas más destacadas y revolucionarias, seleccionadas tras rigurosas pruebas en entornos reales que garantizan resultados excepcionales. En ella encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas e información valiosa que te ayudarán a elegir la solución perfecta para aumentar tu productividad y optimizar tu flujo de trabajo. ¡Explórala ahora mismo para darle un impulso a tus capacidades con la IA!
8 herramientas
xix.ai

 comentario (0)
0/500
El seguimiento de la última evaluación de CI fuera de línea de la IA revela que múltiples iteraciones del GPT-5.6 de OpenAI lograron una puntuación de 136, marcando la primera instancia en la que un modelo de lenguaje grande superó el umbral de CI de 130. En la distribución humana estándar, un CI de 130 significa el umbral para ser considerado “genio”, un nivel alcanzado por apenas el 1% de la población mundial, posicionando efectivamente al GPT-5.6 como más inteligente que el 99% de las personas.
Al obtener 136 puntos en el banco de preguntas más riguroso y con mayor protección contra filtraciones, el GPT-5.6 superó significativamente a sus competidores.
Tracking AI utilizó dos marcos de prueba distintos: un examen de estilo Mensa Noruega de código abierto, donde los modelos ya superaban los 140 puntos, y un banco de preguntas offline propietario y no revelado diseñado para prevenir la memorización previa. El GPT-5.6 navegó con éxito este conjunto de datos offline desafiante, con toda la familia SOL y TERRA obteniendo 136 puntos, incluida su variante visual. Claude-5 Fable le siguió con 130 puntos, mientras que GPT-5.6 LUNA Max y Claude-4.8 Opus se quedaron entre 117 y 123 puntos. Aunque los modelos desde o3 hasta varios sistemas insignia han estancado históricamente en el umbral de 130, el GPT-5.6 se ha convertido en el primero en romperlo.
Más allá de las puntuaciones de prueba, el GPT-5.6 demuestra un rendimiento excepcional en aplicaciones prácticas.
Las altas métricas de prueba no garantizan por sí mismas utilidad. Los desarrolladores evaluaron el GPT-5.6 en escenarios del mundo real con resultados impactantes. Cuando el desarrollador Amir Bohlooli envió un prompt idéntico de simulación física tanto a Fable5 como a GPT-5.6 Sol, anticipaba la dominancia de Fable. En cambio, el GPT-5.6 Sol ejecutó una simulación de fluido de partículas con física en tiempo real, encapsulando CSS, diseño de interfaz y renderizado dentro de un único archivo HTML. Alojó automáticamente el resultado como una página web compartible, entregando un producto completo a partir de un solo prompt. De manera similar, Ramanpal Singh desarrolló un sistema de tickets de clientes utilizando RAG con un solo prompt, incorporando cuatro roles distintos, un panel de gestión backend, clasificación automatizada de quejas y reconocimiento de emociones. Esta configuración compleja requirió solo una fracción del costo asociado con Fable5.
La experiencia de Claire Vo destacó estas ventajas prácticas. Tras encontrarse con un error persistente que ella creía que había bloqueado su código, cambió al GPT-5.6 Sol, comentando: “No voy a dejar que esto me venza”. Sol resolvió el problema de inmediato y asistió a otros modelos para que funcionaran sin problemas. La evaluación de Vo fue clara: el enfoque rígido de Fable en la precisión técnica obstaculizó su eficacia, mientras que el enfoque pragmático de Sol entregó resultados tangibles.








 ¿Cómo comprobar la posición en Google de forma gratuita?
Un código QR que no se puede rastrear es una mera suposición. Lo imprimes, cruzas los dedos y nunca llegas a saber si ha funcionado. El rastreo convierte esa suposición en datos: cuántas personas lo h
 Microsoft presenta la serie de modelos MAI para diversificar su estrategia de IA más allá de un único gigante
Satya Nadella, director ejecutivo de Microsoft, destacó durante la reciente conferencia de ganancias trimestrales que la compañía está acelerando la adopción empresarial de arquitecturas multimodelo, al tiempo que aumenta las inversiones en modelos d
 Las empresas de modelos mundiales guardan secretos
La semana pasada, facilité un debate sobre modelos del mundo en la conferencia All In (sin relación con el podcast), ofreciendo un análisis profundo de uno de los sectores más enigmáticos de la inteligencia artificial. Líderes del sector como AMI Lab

El ranking de 2026 de los mejores generadores de arte con IA muestra las herramientas más valoradas para crear tableros de inspiración impresionantes, explorar estilos diversos y definir direcciones visuales. XIX.AI ofrece una lista cuidadosamente seleccionada de opciones potentes y revolucionarias que han superado pruebas rigurosas en entornos reales. Consulte una comparación gratuita con la versión de pago para ayudarse a encontrar la solución perfecta que potencie su flujo de trabajo creativo. Explórelo ahora y aproveche toda la ventaja que le brinda la IA en la creación artística.
10 herramientas
xix.ai
Las mejores plataformas de personalización de correo electrónico con IA de 2026 para Shopify Flows que potencian la retención y la recuperación de clientes. Esta lista seleccionada y mejor valorada incluye potentes herramientas revolucionarias que han superado pruebas en el mundo real y ofrece información comparativa entre las opciones gratuitas y las de pago. XIX.AI forma parte de nuestra selección de confianza. Descubre hoy mismo la herramienta perfecta para sacar partido a tu ventaja competitiva con la IA. ¡Explora ahora!
9 herramientas
xix.ai
¡Los mejores generadores de cómics con IA de 2026 para creadores de webtoons! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los creadores a aumentar su productividad de forma significativa. Encontrarás clasificaciones detalladas que se actualizan semanalmente, comparativas entre opciones gratuitas y de pago, y pruebas reales que te ayudarán a elegir la herramienta que mejor se adapte a tus necesidades. Hay opciones imprescindibles que te permitirán superar los cuellos de botella en la creación y ofrecer contenido de alta calidad más rápidamente. ¡Explora ahora mismo y descubre tu herramienta perfecta para crear cómics de forma más inteligente!
9 herramientas
xix.ai
¡Las mejores herramientas de ilustración con IA mejor valoradas de 2026 para artistas digitales! XIX.AI ha seleccionado una potente colección de herramientas punteras, que suponen un punto de inflexión, diseñadas para ayudar a los artistas a liberar todo su potencial creativo. Estas mejores opciones incluyen clasificaciones actualizadas semanalmente, pruebas en condiciones reales y comparativas detalladas entre versiones gratuitas y de pago para ayudarte a encontrar la opción perfecta que potencie la eficiencia de tu flujo de trabajo. Aquí encontrarás opciones imprescindibles para todos los niveles de habilidad. ¡Explora ahora mismo y descubre tu herramienta perfecta!
17 herramientas
xix.ai
¡Las mejores herramientas de maquetación de manga con IA mejor valoradas de 2026 para creadores de webtoons! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, y que han superado rigurosas pruebas en el mundo real. Encontrarás clasificaciones detalladas que se actualizan semanalmente, información comparativa entre versiones gratuitas y de pago, y consejos sobre cómo estas herramientas pueden optimizar tu flujo de trabajo, ayudarte a crear contenido de alta calidad más rápidamente y liberar todo tu potencial creativo. ¡Explora ahora mismo para descubrir tu herramienta perfecta!
9 herramientas
xix.ai
¡Las mejores herramientas de wireframing para paneles de control de IA de 2026, ideales para SaaS B2B, paneles de administración y productos con grandes volúmenes de datos! XIX.AI ha elaborado una lista de las herramientas más destacadas y revolucionarias, seleccionadas tras rigurosas pruebas en entornos reales que garantizan resultados excepcionales. En ella encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas e información valiosa que te ayudarán a elegir la solución perfecta para aumentar tu productividad y optimizar tu flujo de trabajo. ¡Explórala ahora mismo para darle un impulso a tus capacidades con la IA!
8 herramientas
xix.ai












