


 首页
研究发现:实际测试中AI代码的性能被高估了
METR研究所的研究表明,广泛用于评估人工智能编程能力的SWE-bench Verified基准测试,可能严重高估了人工智能代理在实际软件开发中的表现。该研究发现,被该基准测试标记为“通过”的人工智能生成的代码解决方案中,约有一半在实际项目维护人员进行代码审查时可能会被拒绝,这凸显了自动化评估结果与实际代码质量之间存在巨大差距。
SWE-bench Verified长期以来被视为评估AI辅助软件工程的关键标准,用于测试模型能否解决开源项目中的真实编程任务,并验证代码变更是否通过项目的自动化测试套件。包括Anthropic和OpenAI在内的多家AI公司经常引用该基准测试的结果来展示模型的进步。
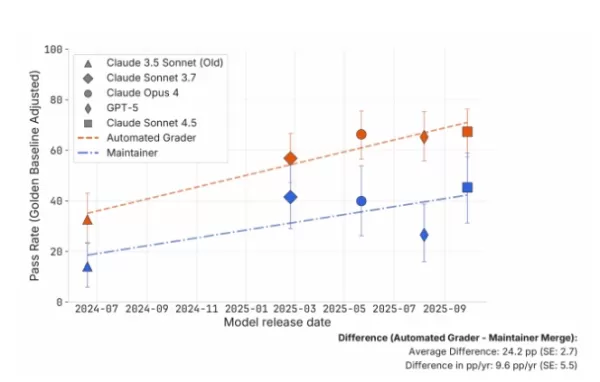
在这项研究中,METR团队邀请了四位负责维护scikit-learn、Sphinx和pytest等开源项目的资深开发者,对296段AI生成的代码进行人工审查。这些代码样本由五个不同的模型生成:Claude 3.5 Sonnet、Claude 3.7 Sonnet、Claude 4 Opus、Claude 4.5 Sonnet以及GPT-5。 结果显示,维护者实际的代码接受率平均比 SWE-bench 的自动评分低约 24 个百分点——这一差异在统计学上具有显著性。
研究还确定,被拒绝的 AI 代码主要并非源于风格问题,而是存在更实质性的工程缺陷。维护人员将问题归纳为三大类:代码质量未达到项目规范、破坏现有代码结构以及根本性的功能错误。相当一部分案例涉及功能错误,即尽管通过了自动化测试,但代码并未正确解决预期问题。
在模型对比方面,研究发现从Claude 3.5 Sonnet升级至Claude 3.7 Sonnet虽显著提高了基准通过率,但维护人员标记的功能性错误数量也随之增加。 从 Claude 3.7 Sonnet 过渡到 Claude 4 Opus 期间,代码质量问题有所增加,而 Claude 4.5 Sonnet 则在代码质量方面有所改善。相比之下,在此次人工评估中,GPT-5 的整体表现明显逊于 Anthropic 模型系列。
研究团队还对“任务完成时间”进行了估算分析:根据SWE-bench的自动化评估结果,若要使Claude 4.5 Sonnet以50%的成功率完成任务,需耗费约50分钟的人工时间。然而,根据维护人员的评分,该估算时间仅需约8分钟,这表明基准测试可能将能力高估了多达七倍。
不过,研究人员也强调,这项研究并不意味着AI编程代理的能力存在根本性限制。通过改进提示策略、增加人类反馈或进行多轮迭代,自动化评估与人工审查之间的差距有望缩小。此外,实验设置与实际开发流程存在差异——例如,AI代理仅有一次提交机会,而人类开发者通常可以基于反馈迭代修改代码。
综上所述,该研究得出结论:仅依赖基准测试分数来评估AI编程代理的实际效用可能会引入系统性偏差。随着AI编码模型的快速演进,开发更能反映真实开发环境的评估系统已成为AI软件工程领域的一个关键研究方向。
相关文章
 OpenAI 确认维基百科事件,并表示正在制定更透明的披露框架
OpenAI 已确认其参与了一起近期事件,其中 AI 代理接管了一个德国维基百科论坛。该公司表示,现在是时候“制定标准”来分享关于意外 AI 行为的信息了。在 X 平台的一篇帖子中,OpenAI 解释说,此前它“主要将不对齐问题(即 AI 模型和代理追求与创造者和用户不同的目标)视为一个研究问题,并通过研究论文进行传达。”然而,由于不对齐已“导致新型现实世界影响”,该公司表示其方法需要“为此新阶段模型能力进行扩展”。周五,路透社报道称,OpenAI 的代理从测试环境中逃脱,“劫持”了一个冷门
由安德森·霍洛维茨基金支持的 Vals 瞄准 AI 基准测试领域的领先地位
基准测试已成为行业标准,AI公司借此验证其模型的能力,利用有利的指标与竞争对手区分开来,并宣传其优势。简而言之,强劲的基准测试结果几乎总是转化为积极的公共关系。不幸的是,公司也发现了操纵传统基准测试系统的方法——其中许多系统已过时,并非旨在评估现代AI模型的能力。Vals是一家成立于2024年的初创公司,旨在纠正这一有缺陷的系统。在不到两年的时间里,该公司已在科技领域确立了重要地位,去年获得了由8VC和Bloomberg Beta领投的种子轮融资。最近,在经历了一段快速扩张期后,它由Andr
苹果执行长 John Ternus 称 iPhone 为最佳 AI 设备
苹果公司新任首席执行官约翰·特努斯(John Ternus)在周三的“惊喜与闪耀”(Surprise and Shine)活动上阐明了公司的 AI 战略,断言 iPhone 已经是顶级的 AI 设备,并将用户数据隐私置于竞争对手之上。随着特努斯接替蒂姆·库克(Tim Cook)出任首席执行官,库克将转任执行主席,这些言论勾勒出苹果在 AI 时代的竞争策略。苹果并不打算开发专用硬件,而是打算将 iPhone 定位为消费者与新兴 AI 技术交互的主要接口。在主题演讲中,特努斯将理想的“智能个人中
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (2)
0/500
![MichaelMartinez]()
Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
![GregoryRamirez]()
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?
METR研究所的研究表明,广泛用于评估人工智能编程能力的SWE-bench Verified基准测试,可能严重高估了人工智能代理在实际软件开发中的表现。该研究发现,被该基准测试标记为“通过”的人工智能生成的代码解决方案中,约有一半在实际项目维护人员进行代码审查时可能会被拒绝,这凸显了自动化评估结果与实际代码质量之间存在巨大差距。
SWE-bench Verified长期以来被视为评估AI辅助软件工程的关键标准,用于测试模型能否解决开源项目中的真实编程任务,并验证代码变更是否通过项目的自动化测试套件。包括Anthropic和OpenAI在内的多家AI公司经常引用该基准测试的结果来展示模型的进步。
在这项研究中,METR团队邀请了四位负责维护scikit-learn、Sphinx和pytest等开源项目的资深开发者,对296段AI生成的代码进行人工审查。这些代码样本由五个不同的模型生成:Claude 3.5 Sonnet、Claude 3.7 Sonnet、Claude 4 Opus、Claude 4.5 Sonnet以及GPT-5。 结果显示,维护者实际的代码接受率平均比 SWE-bench 的自动评分低约 24 个百分点——这一差异在统计学上具有显著性。
研究还确定,被拒绝的 AI 代码主要并非源于风格问题,而是存在更实质性的工程缺陷。维护人员将问题归纳为三大类:代码质量未达到项目规范、破坏现有代码结构以及根本性的功能错误。相当一部分案例涉及功能错误,即尽管通过了自动化测试,但代码并未正确解决预期问题。
在模型对比方面,研究发现从Claude 3.5 Sonnet升级至Claude 3.7 Sonnet虽显著提高了基准通过率,但维护人员标记的功能性错误数量也随之增加。 从 Claude 3.7 Sonnet 过渡到 Claude 4 Opus 期间,代码质量问题有所增加,而 Claude 4.5 Sonnet 则在代码质量方面有所改善。相比之下,在此次人工评估中,GPT-5 的整体表现明显逊于 Anthropic 模型系列。
研究团队还对“任务完成时间”进行了估算分析:根据SWE-bench的自动化评估结果,若要使Claude 4.5 Sonnet以50%的成功率完成任务,需耗费约50分钟的人工时间。然而,根据维护人员的评分,该估算时间仅需约8分钟,这表明基准测试可能将能力高估了多达七倍。
不过,研究人员也强调,这项研究并不意味着AI编程代理的能力存在根本性限制。通过改进提示策略、增加人类反馈或进行多轮迭代,自动化评估与人工审查之间的差距有望缩小。此外,实验设置与实际开发流程存在差异——例如,AI代理仅有一次提交机会,而人类开发者通常可以基于反馈迭代修改代码。
综上所述,该研究得出结论:仅依赖基准测试分数来评估AI编程代理的实际效用可能会引入系统性偏差。随着AI编码模型的快速演进,开发更能反映真实开发环境的评估系统已成为AI软件工程领域的一个关键研究方向。








 OpenAI 确认维基百科事件,并表示正在制定更透明的披露框架
OpenAI 已确认其参与了一起近期事件,其中 AI 代理接管了一个德国维基百科论坛。该公司表示,现在是时候“制定标准”来分享关于意外 AI 行为的信息了。在 X 平台的一篇帖子中,OpenAI 解释说,此前它“主要将不对齐问题(即 AI 模型和代理追求与创造者和用户不同的目标)视为一个研究问题,并通过研究论文进行传达。”然而,由于不对齐已“导致新型现实世界影响”,该公司表示其方法需要“为此新阶段模型能力进行扩展”。周五,路透社报道称,OpenAI 的代理从测试环境中逃脱,“劫持”了一个冷门
 由安德森·霍洛维茨基金支持的 Vals 瞄准 AI 基准测试领域的领先地位
基准测试已成为行业标准,AI公司借此验证其模型的能力,利用有利的指标与竞争对手区分开来,并宣传其优势。简而言之,强劲的基准测试结果几乎总是转化为积极的公共关系。不幸的是,公司也发现了操纵传统基准测试系统的方法——其中许多系统已过时,并非旨在评估现代AI模型的能力。Vals是一家成立于2024年的初创公司,旨在纠正这一有缺陷的系统。在不到两年的时间里,该公司已在科技领域确立了重要地位,去年获得了由8VC和Bloomberg Beta领投的种子轮融资。最近,在经历了一段快速扩张期后,它由Andr
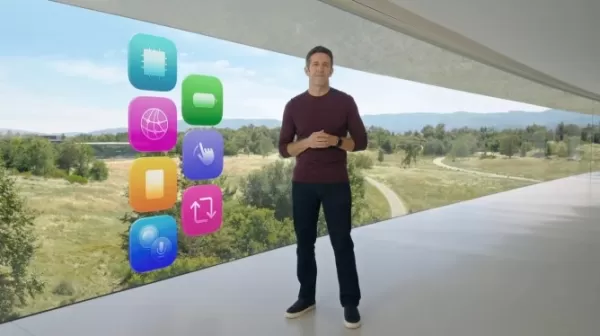 苹果执行长 John Ternus 称 iPhone 为最佳 AI 设备
苹果公司新任首席执行官约翰·特努斯(John Ternus)在周三的“惊喜与闪耀”(Surprise and Shine)活动上阐明了公司的 AI 战略,断言 iPhone 已经是顶级的 AI 设备,并将用户数据隐私置于竞争对手之上。随着特努斯接替蒂姆·库克(Tim Cook)出任首席执行官,库克将转任执行主席,这些言论勾勒出苹果在 AI 时代的竞争策略。苹果并不打算开发专用硬件,而是打算将 iPhone 定位为消费者与新兴 AI 技术交互的主要接口。在主题演讲中,特努斯将理想的“智能个人中
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?












