


 Lar
Estudo revela que o desempenho do código de IA é superestimado em testes reais
Uma pesquisa do instituto METR indica que o benchmark SWE-bench Verified, amplamente utilizado para avaliar as capacidades de programação da IA, pode superestimar significativamente o desempenho dos agentes de IA no desenvolvimento de software no mundo real. O estudo constatou que aproximadamente metade das soluções de código geradas por IA marcadas como “aprovadas” pelo benchmark provavelmente seriam rejeitadas pelos responsáveis reais pelos projetos durante a revisão de código, destacando uma lacuna substancial entre os resultados da avaliação automatizada e a qualidade do código no mundo real.
O SWE-bench Verified é há muito considerado um padrão fundamental para avaliar a engenharia de software assistida por IA, testando se os modelos podem resolver tarefas de programação reais em projetos de código aberto e verificando se as alterações no código são aprovadas no conjunto de testes automatizados do projeto. Várias empresas de IA, incluindo a Anthropic e a OpenAI, citam frequentemente os resultados desse benchmark para demonstrar os avanços dos modelos.
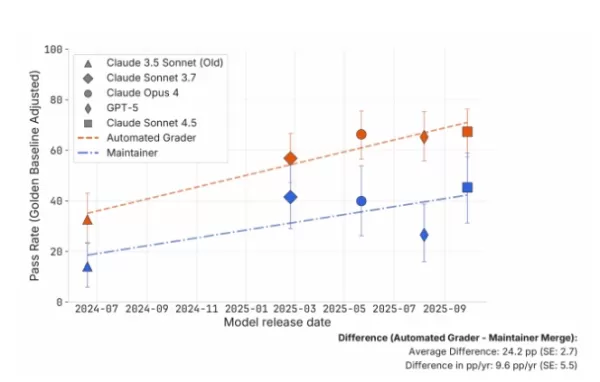
Neste estudo, a equipe do METR recrutou quatro desenvolvedores experientes que mantêm os projetos de código aberto scikit-learn, Sphinx e pytest para revisar manualmente 296 trechos de código gerados por IA. Essas amostras de código foram produzidas por cinco modelos diferentes: Claude 3.5 Sonnet, Claude 3.7 Sonnet, Claude 4 Opus, Claude 4.5 Sonnet e GPT-5. Os resultados revelaram que a taxa de aceitação real pelos mantenedores foi, em média, cerca de 24 pontos percentuais inferior às pontuações automatizadas do SWE-bench — uma diferença estatisticamente significativa.
O estudo também determinou que o código de IA rejeitado não se devia principalmente a questões estilísticas, mas sim a falhas de engenharia mais substanciais. Os mantenedores categorizaram os problemas em três tipos principais: qualidade do código que não atendia às especificações do projeto, perturbação da estrutura do código existente e erros funcionais fundamentais. Uma parte significativa dos casos envolveu erros funcionais em que, apesar de passar nos testes automatizados, o código não resolvia corretamente o problema pretendido.
Em relação à comparação de modelos, a pesquisa constatou que a atualização do Claude 3.5 Sonnet para o Claude 3.7 Sonnet melhorou significativamente a taxa de aprovação no benchmark, mas o número de erros funcionais sinalizados pelos mantenedores também aumentou. A transição do Claude 3.7 Sonnet para o Claude 4 Opus observou uma mudança no sentido de mais problemas de qualidade de código, enquanto o Claude 4.5 Sonnet apresentou melhorias na qualidade de código. Em contraste, o GPT-5 teve um desempenho notavelmente pior no geral do que a série de modelos da Anthropic nesta avaliação manual.
A equipe de pesquisa também realizou uma análise estimada do “tempo de conclusão da tarefa”: de acordo com os resultados da avaliação automatizada do SWE-bench, o Claude 4.5 Sonnet levaria aproximadamente 50 minutos de esforço humano para concluir tarefas com uma taxa de sucesso de 50%. No entanto, com base nas pontuações dos mantenedores, o tempo estimado cai para apenas cerca de 8 minutos, sugerindo que o benchmark pode superestimar as capacidades em até sete vezes.
No entanto, os pesquisadores também enfatizaram que este estudo não implica um limite fundamental nas capacidades dos agentes de programação de IA. Com estratégias de prompt aprimoradas, mais feedback humano ou múltiplos ciclos de iteração, a diferença entre a avaliação automatizada e a revisão manual poderia ser reduzida. Além disso, a configuração experimental difere dos processos reais de desenvolvimento — por exemplo, os agentes de IA tiveram apenas uma tentativa de envio, enquanto desenvolvedores humanos normalmente podem modificar o código iterativamente com base no feedback.
Em resumo, o estudo conclui que basear-se exclusivamente em pontuações de benchmark para avaliar a utilidade prática de agentes de programação de IA pode introduzir um viés sistemático. À medida que os modelos de codificação de IA evoluem rapidamente, o desenvolvimento de sistemas de avaliação que reflitam melhor os ambientes de desenvolvimento do mundo real tornou-se uma direção de pesquisa crucial na engenharia de software de IA.
Artigo relacionado
 Otter.ai garante US$ 320 milhões em financiamento de crescimento da General Catalyst para sua ferramenta de reuniões
Na terça-feira, a Otter.ai, uma plataforma de anotação em reuniões, anunciou um investimento de US$ 320 milhões do Fundo de Valor ao Cliente (CVF) da General Catalyst. Este fundo apoia startups sem exigir diluição acionária, buscando retornos baseado
A Anthropic lança o Claude Haiku 5.5, reduzindo os custos de modelos pequenos em 75% e permitindo que os usuários ajustem a intensidade da inferência
Em 8 de outubro, a Anthropic apresentou seu modelo mais eficiente e capaz até o momento: o Claude Haiku 5.5. Posicionado como o modelo pequeno mais rápido e capaz da linha da Anthropic, ele foi projetado para aplicações de alta frequência e sensíveis
A Claude revela o primeiro mapa completo do céu ultravioleta, mapeando 119 milhões de estrelas
Com o poderoso auxílio do Claude, o modelo de linguagem grande da Anthropic, astrofísicos geraram com sucesso o primeiro mapa completo do céu inteiro em ultravioleta da história. Este vasto mapa estelar, que apresenta 119 milhões de estrelas, foi amp
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (2)
![MichaelMartinez]()
Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
![GregoryRamirez]()
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?
Uma pesquisa do instituto METR indica que o benchmark SWE-bench Verified, amplamente utilizado para avaliar as capacidades de programação da IA, pode superestimar significativamente o desempenho dos agentes de IA no desenvolvimento de software no mundo real. O estudo constatou que aproximadamente metade das soluções de código geradas por IA marcadas como “aprovadas” pelo benchmark provavelmente seriam rejeitadas pelos responsáveis reais pelos projetos durante a revisão de código, destacando uma lacuna substancial entre os resultados da avaliação automatizada e a qualidade do código no mundo real.
O SWE-bench Verified é há muito considerado um padrão fundamental para avaliar a engenharia de software assistida por IA, testando se os modelos podem resolver tarefas de programação reais em projetos de código aberto e verificando se as alterações no código são aprovadas no conjunto de testes automatizados do projeto. Várias empresas de IA, incluindo a Anthropic e a OpenAI, citam frequentemente os resultados desse benchmark para demonstrar os avanços dos modelos.
Neste estudo, a equipe do METR recrutou quatro desenvolvedores experientes que mantêm os projetos de código aberto scikit-learn, Sphinx e pytest para revisar manualmente 296 trechos de código gerados por IA. Essas amostras de código foram produzidas por cinco modelos diferentes: Claude 3.5 Sonnet, Claude 3.7 Sonnet, Claude 4 Opus, Claude 4.5 Sonnet e GPT-5. Os resultados revelaram que a taxa de aceitação real pelos mantenedores foi, em média, cerca de 24 pontos percentuais inferior às pontuações automatizadas do SWE-bench — uma diferença estatisticamente significativa.
O estudo também determinou que o código de IA rejeitado não se devia principalmente a questões estilísticas, mas sim a falhas de engenharia mais substanciais. Os mantenedores categorizaram os problemas em três tipos principais: qualidade do código que não atendia às especificações do projeto, perturbação da estrutura do código existente e erros funcionais fundamentais. Uma parte significativa dos casos envolveu erros funcionais em que, apesar de passar nos testes automatizados, o código não resolvia corretamente o problema pretendido.
Em relação à comparação de modelos, a pesquisa constatou que a atualização do Claude 3.5 Sonnet para o Claude 3.7 Sonnet melhorou significativamente a taxa de aprovação no benchmark, mas o número de erros funcionais sinalizados pelos mantenedores também aumentou. A transição do Claude 3.7 Sonnet para o Claude 4 Opus observou uma mudança no sentido de mais problemas de qualidade de código, enquanto o Claude 4.5 Sonnet apresentou melhorias na qualidade de código. Em contraste, o GPT-5 teve um desempenho notavelmente pior no geral do que a série de modelos da Anthropic nesta avaliação manual.
A equipe de pesquisa também realizou uma análise estimada do “tempo de conclusão da tarefa”: de acordo com os resultados da avaliação automatizada do SWE-bench, o Claude 4.5 Sonnet levaria aproximadamente 50 minutos de esforço humano para concluir tarefas com uma taxa de sucesso de 50%. No entanto, com base nas pontuações dos mantenedores, o tempo estimado cai para apenas cerca de 8 minutos, sugerindo que o benchmark pode superestimar as capacidades em até sete vezes.
No entanto, os pesquisadores também enfatizaram que este estudo não implica um limite fundamental nas capacidades dos agentes de programação de IA. Com estratégias de prompt aprimoradas, mais feedback humano ou múltiplos ciclos de iteração, a diferença entre a avaliação automatizada e a revisão manual poderia ser reduzida. Além disso, a configuração experimental difere dos processos reais de desenvolvimento — por exemplo, os agentes de IA tiveram apenas uma tentativa de envio, enquanto desenvolvedores humanos normalmente podem modificar o código iterativamente com base no feedback.
Em resumo, o estudo conclui que basear-se exclusivamente em pontuações de benchmark para avaliar a utilidade prática de agentes de programação de IA pode introduzir um viés sistemático. À medida que os modelos de codificação de IA evoluem rapidamente, o desenvolvimento de sistemas de avaliação que reflitam melhor os ambientes de desenvolvimento do mundo real tornou-se uma direção de pesquisa crucial na engenharia de software de IA.








 Otter.ai garante US$ 320 milhões em financiamento de crescimento da General Catalyst para sua ferramenta de reuniões
Na terça-feira, a Otter.ai, uma plataforma de anotação em reuniões, anunciou um investimento de US$ 320 milhões do Fundo de Valor ao Cliente (CVF) da General Catalyst. Este fundo apoia startups sem exigir diluição acionária, buscando retornos baseado
 A Anthropic lança o Claude Haiku 5.5, reduzindo os custos de modelos pequenos em 75% e permitindo que os usuários ajustem a intensidade da inferência
Em 8 de outubro, a Anthropic apresentou seu modelo mais eficiente e capaz até o momento: o Claude Haiku 5.5. Posicionado como o modelo pequeno mais rápido e capaz da linha da Anthropic, ele foi projetado para aplicações de alta frequência e sensíveis
 A Claude revela o primeiro mapa completo do céu ultravioleta, mapeando 119 milhões de estrelas
Com o poderoso auxílio do Claude, o modelo de linguagem grande da Anthropic, astrofísicos geraram com sucesso o primeiro mapa completo do céu inteiro em ultravioleta da história. Este vasto mapa estelar, que apresenta 119 milhões de estrelas, foi amp

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?












