


 집
연구 결과, 실제 테스트에서 AI 코드의 성능이 과대평가된 것으로 드러났다
METR 연구소의 연구에 따르면, AI 프로그래밍 능력을 평가하는 데 널리 사용되는 ‘SWE-bench Verified’ 벤치마크가 실제 소프트웨어 개발 환경에서 AI 에이전트의 성능을 상당히 과대평가할 가능성이 있는 것으로 나타났다. 이 연구는 벤치마크에서 ‘합격’ 판정을 받은 AI 생성 코드 솔루션 중 약 절반이 실제 프로젝트 유지보수 담당자에 의한 코드 검토 과정에서 거부될 가능성이 높다는 사실을 밝혀냈으며, 이는 자동화된 평가 결과와 실제 코드 품질 사이에 상당한 격차가 존재함을 보여준다.
SWE-bench Verified는 오랫동안 AI 지원 소프트웨어 공학을 평가하는 핵심 표준으로 여겨져 왔으며, 모델이 오픈소스 프로젝트에서 실제 프로그래밍 과제를 해결할 수 있는지 테스트하고, 코드 변경 사항이 프로젝트의 자동화 테스트 스위트를 통과하는지 검증해 왔다. Anthropic과 OpenAI를 비롯한 여러 AI 기업들은 모델의 발전을 입증하기 위해 이 벤치마크의 결과를 자주 인용한다.
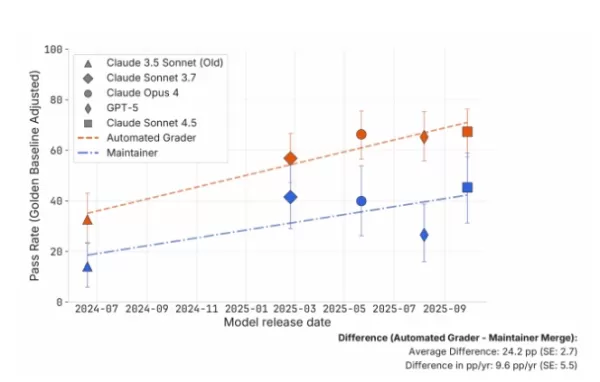
이번 연구에서 METR 팀은 오픈소스 프로젝트인 scikit-learn, Sphinx, pytest를 관리하는 숙련된 개발자 4명을 모집하여 AI가 생성한 코드 296개를 수동으로 검토하게 했습니다. 이 코드 샘플들은 Claude 3.5 Sonnet, Claude 3.7 Sonnet, Claude 4 Opus, Claude 4.5 Sonnet, GPT-5 등 5가지 서로 다른 모델에 의해 생성되었습니다. 결과에 따르면, 유지보수 담당자들의 실제 승인률은 SWE-bench의 자동 평가 점수보다 평균 약 24%포인트 낮았으며, 이는 통계적으로 유의미한 차이였습니다.
또한 이 연구는 거부된 AI 코드가 주로 스타일상의 문제가 아니라 보다 중대한 엔지니어링 결함 때문이라는 점을 확인했습니다. 유지보수 담당자들은 문제를 세 가지 주요 유형으로 분류했습니다: 프로젝트 사양을 충족하지 못하는 코드 품질, 기존 코드 구조의 파괴, 그리고 근본적인 기능적 오류입니다. 상당수의 사례는 자동화된 테스트를 통과했음에도 불구하고 코드가 의도된 문제를 올바르게 해결하지 못한 기능적 오류와 관련이 있었습니다.
모델 비교와 관련하여, 연구 결과 Claude 3.5 Sonnet에서 Claude 3.7 Sonnet으로 업그레이드했을 때 벤치마크 통과율은 크게 향상되었으나, 유지보수 담당자가 지적한 기능적 오류의 수도 증가한 것으로 나타났다. Claude 3.7 Sonnet에서 Claude 4 Opus로 전환할 때는 코드 품질 문제가 더 많이 발생했으나, Claude 4.5 Sonnet에서는 코드 품질이 개선된 것으로 나타났습니다. 반면, 이번 수동 평가에서 GPT-5는 전반적으로 Anthropic 모델 시리즈보다 현저히 낮은 성능을 보였습니다.
연구팀은 또한 "작업 완료 시간"에 대한 추정 분석을 수행했다. SWE-bench 자동 평가 결과에 따르면, Claude 4.5 Sonnet이 50%의 성공률로 작업을 완료하는 데는 약 50분의 인간 노동력이 소요될 것으로 나타났다. 그러나 유지보수 담당자들의 점수를 기준으로 할 때, 추정 시간은 약 8분으로 줄어들어 벤치마크가 능력을 최대 7배까지 과대평가했을 가능성을 시사한다.
하지만 연구진은 이번 연구가 AI 프로그래밍 에이전트의 능력에 근본적인 한계가 있음을 시사하는 것은 아니라고 강조했다. 프롬프트 전략을 개선하거나, 더 많은 인간 피드백을 반영하거나, 반복적인 수정 과정을 거친다면 자동 평가와 수동 검토 간의 격차는 줄어들 수 있다. 또한 실험 환경은 실제 개발 과정과 차이가 있다. 예를 들어, AI 에이전트는 단 한 번의 제출 기회만 주어진 반면, 인간 개발자는 일반적으로 피드백을 바탕으로 코드를 반복적으로 수정할 수 있다.
요약하자면, 이 연구는 AI 프로그래밍 에이전트의 실용적 유용성을 평가할 때 벤치마크 점수에만 의존하는 것은 체계적인 편향을 초래할 수 있다고 결론지었다. AI 코딩 모델이 급속히 진화함에 따라, 실제 개발 환경을 더 잘 반영하는 평가 시스템을 개발하는 것이 AI 소프트웨어 공학 분야의 중요한 연구 방향으로 부상했다.
관련 기사
 통이 랩, 직교 분리기 기술 적용된 ‘Qwen3.7-Max’ 공개… 국내 다수 벤치마크에서 1위 기록
Tongyi Lab은 차세대 AI 에이전트 파운데이션 모델인 ‘Qwen3.7-Max’를 공식 출시했습니다. 이 모델은 여러 권위 있는 벤치마크에서 1위를 차지했으며, 장기간의 생산 환경에서 지능형 에이전트가 보이는 취약성과 불안정성 등 업계의 주요 과제를 해결합니다.알려지지 않은 하드웨어 플랫폼인 ZW-M890L PPU에서 실시된 엄격한 스트레스 테스트에서
제네시스 AI, 단일 모델로 로봇 작업 마스터… ‘챗GPT’와 유사한 전환점 마련
전 세계적으로 로봇 공학에 대한 관심이 높아지는 가운데, 제네시스 AI는 자사의 첫 번째 로봇 파운데이션 모델인 ‘GENE-26.5’를 선보였습니다. 이번 출시는 범용 로봇 공학, 특히 복잡하고 구조화되지 않은 작업을 처리하는 분야에서 큰 도약을 의미합니다.최근 공개 시연에서는 이 로봇의 놀라운 민첩성과 자율성이 돋보였습니다. 한 손으로 달걀을 휘젓는 것과
마이크로소프트, 16개 언어에서 동시에 듣고 말할 수 있는 자체 개발한 최초의 전이중 AI 음성 모델 공개
기술 전문 매체 TestingCatalog에 따르면, 마이크로소프트는 현재 자사의 첫 번째 네이티브 실시간 음성 모델인 ‘MAI Realtime’을 테스트 중입니다. 16개 언어와 두 가지 독특한 음성 스타일을 지원하는 이 시스템은 듣기와 말하기를 동시에 처리할 수 있어, 자동 언어 감지 및 대화 도중 언어 전환이 가능합니다. 이러한 발전 덕분에 사용자는
관련 특별 주제 추천
만화 창작
 연속 연재용 최고의 AI 만화 배경 생성기
2026년 최신 최고 인기 AI 만화 배경 생성기 시리즈물! 이 엄선된 목록에는 창작자가 놀라운 시각적 콘텐츠를 빠르게 제작할 수 있도록 도와주는 강력한 게임 체인저 도구들이 포함되어 있어 생산성을 크게 향상시킵니다. 모든 옵션은 최고 품질을 보장하기 위해 실제 테스트를 거쳤습니다. 무료와 유료 비교 및 순위를 확인하여 자신에게 가장 적합한 도구를 찾아보세요. XIX.AI에서 지금 탐색하고 만화 제작에서 AI의 이점을 활용하세요.
 9 도구
 xix.ai
챗봇
최고의 AI 대화 상대: 장기 기억을 바탕으로 자연스러운 대화를 나누세요
‘2026년 최신 최고의 AI 채팅 동반자 순위’는 자연스러운 대화를 나누고 장기 기억을 유지하는 능력으로 정평이 난, 최고 평점을 받은 강력한 도구들을 소개합니다. 이 엄선된 목록에는 실제 테스트를 거치고 매주 업데이트되는 순위를 바탕으로, 무료 및 유료 서비스 전반에 걸쳐 꼭 사용해 봐야 할 옵션들이 포함되어 있습니다. XIX.AI는 이 엄선된 목록에서 신뢰할 수 있는 선택지로 두각을 나타내고 있습니다. 지금 바로 살펴보고 나에게 딱 맞는 AI 채팅 동반자를 찾아, 오늘부터 생산성을 한 단계 높여보세요.
11 도구
xix.ai
애니메이션 제작
최고의 AI 애니메이션 생성기: 아이디어를 빠르게 모션 클립으로 변환
2026년 최신 최고 인기 AI 애니메이션 생성기! XIX.AI는 창의적인 아이디어를 고품질 모션 클립으로 빠르게 변환할 수 있는 필수 도구들을 엄선한 혁신적인 컬렉션을 제공합니다. 각 옵션은 철저한 실제 테스트를 거쳤으며, 무료와 유료 버전의 상세 비교와 매주 업데이트되는 랭킹을 제공하여 애니메이션 생산성을 높일 수 있는 최적의 도구를 찾을 수 있도록 도와줍니다. 지금 바로 탐색하고 AI 경쟁력을 확보하세요!
11 도구
xix.ai
텍스트 음성 변환
최고의 다국어 AI 음성 생성기: 대규모 오디오 현지화
2026년 최신 최고 평점을 받은 대규모 오디오 현지화를 위한 최고의 다국어 AI 음성 생성기. 이 엄선된 목록에는 고품질의 현지화된 오디오를 신속하게 제공하는 강력하고 혁신적인 도구들이 포함되어 있습니다. 각 옵션은 신뢰성을 보장하기 위해 엄격한 실제 테스트를 거쳤습니다. 무료 버전과 유료 버전을 비교해 보고, 여러분의 프로젝트에 가장 적합한 도구를 찾아보세요. 지금 XIX.AI에서 탐색하여 AI를 활용한 경쟁 우위를 확보하세요.
18 도구
xix.ai
글쓰기
장문 SEO 기사, 개요 및 핵심 페이지를 위한 최고의 AI 개요 생성기
2026년 최신 최고 평점을 받은 AI 개요 생성기: 장문 SEO 기사, 브리프, 필러 페이지용. XIX.AI는 매주 업데이트되는 실제 테스트를 거쳐 엄선한, 판도를 바꿀 만한 강력한 도구 모음을 제공하며, 글쓰기 효율을 높이고 콘텐츠 제작 과정을 간소화하며 AI의 장점을 최대한 활용할 수 있도록 도와주는 꼭 사용해 봐야 할 도구들을 소개합니다. 지금 바로 탐색하여 최고의 SEO 성과를 거둘 수 있는 완벽한 도구를 찾아보세요.
11 도구
xix.ai
회의 도우미
AI 음성-문서 변환 어시스턴트: 팀 회의를 깔끔한 회의록으로 변환
2026년 최신 최고 평점을 받은 AI 음성-문서 변환 어시스턴트 가이드! XIX.AI는 모든 팀 대화를 즉시 완벽하고 체계적인 기록으로 변환해 주는, 매우 강력하고 혁신적인 도구 모음을 엄선했습니다. 매주 업데이트되는 저희 순위 목록에는 무료 및 유료 옵션이 모두 포함되어 있으며, 모든 업무 상황에서 생산성을 높이는 데 얼마나 효과적인지 보여주는 실제 테스트 결과도 함께 제공됩니다. AI의 장점을 최대한 활용하고자 하는 분이라면 꼭 시도해 보셔야 할 필수 가이드입니다. 지금 바로 확인해 보세요!
9 도구
xix.ai

 의견 (2)
0/500
![MichaelMartinez]()
Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
![GregoryRamirez]()
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?
METR 연구소의 연구에 따르면, AI 프로그래밍 능력을 평가하는 데 널리 사용되는 ‘SWE-bench Verified’ 벤치마크가 실제 소프트웨어 개발 환경에서 AI 에이전트의 성능을 상당히 과대평가할 가능성이 있는 것으로 나타났다. 이 연구는 벤치마크에서 ‘합격’ 판정을 받은 AI 생성 코드 솔루션 중 약 절반이 실제 프로젝트 유지보수 담당자에 의한 코드 검토 과정에서 거부될 가능성이 높다는 사실을 밝혀냈으며, 이는 자동화된 평가 결과와 실제 코드 품질 사이에 상당한 격차가 존재함을 보여준다.
SWE-bench Verified는 오랫동안 AI 지원 소프트웨어 공학을 평가하는 핵심 표준으로 여겨져 왔으며, 모델이 오픈소스 프로젝트에서 실제 프로그래밍 과제를 해결할 수 있는지 테스트하고, 코드 변경 사항이 프로젝트의 자동화 테스트 스위트를 통과하는지 검증해 왔다. Anthropic과 OpenAI를 비롯한 여러 AI 기업들은 모델의 발전을 입증하기 위해 이 벤치마크의 결과를 자주 인용한다.
이번 연구에서 METR 팀은 오픈소스 프로젝트인 scikit-learn, Sphinx, pytest를 관리하는 숙련된 개발자 4명을 모집하여 AI가 생성한 코드 296개를 수동으로 검토하게 했습니다. 이 코드 샘플들은 Claude 3.5 Sonnet, Claude 3.7 Sonnet, Claude 4 Opus, Claude 4.5 Sonnet, GPT-5 등 5가지 서로 다른 모델에 의해 생성되었습니다. 결과에 따르면, 유지보수 담당자들의 실제 승인률은 SWE-bench의 자동 평가 점수보다 평균 약 24%포인트 낮았으며, 이는 통계적으로 유의미한 차이였습니다.
또한 이 연구는 거부된 AI 코드가 주로 스타일상의 문제가 아니라 보다 중대한 엔지니어링 결함 때문이라는 점을 확인했습니다. 유지보수 담당자들은 문제를 세 가지 주요 유형으로 분류했습니다: 프로젝트 사양을 충족하지 못하는 코드 품질, 기존 코드 구조의 파괴, 그리고 근본적인 기능적 오류입니다. 상당수의 사례는 자동화된 테스트를 통과했음에도 불구하고 코드가 의도된 문제를 올바르게 해결하지 못한 기능적 오류와 관련이 있었습니다.
모델 비교와 관련하여, 연구 결과 Claude 3.5 Sonnet에서 Claude 3.7 Sonnet으로 업그레이드했을 때 벤치마크 통과율은 크게 향상되었으나, 유지보수 담당자가 지적한 기능적 오류의 수도 증가한 것으로 나타났다. Claude 3.7 Sonnet에서 Claude 4 Opus로 전환할 때는 코드 품질 문제가 더 많이 발생했으나, Claude 4.5 Sonnet에서는 코드 품질이 개선된 것으로 나타났습니다. 반면, 이번 수동 평가에서 GPT-5는 전반적으로 Anthropic 모델 시리즈보다 현저히 낮은 성능을 보였습니다.
연구팀은 또한 "작업 완료 시간"에 대한 추정 분석을 수행했다. SWE-bench 자동 평가 결과에 따르면, Claude 4.5 Sonnet이 50%의 성공률로 작업을 완료하는 데는 약 50분의 인간 노동력이 소요될 것으로 나타났다. 그러나 유지보수 담당자들의 점수를 기준으로 할 때, 추정 시간은 약 8분으로 줄어들어 벤치마크가 능력을 최대 7배까지 과대평가했을 가능성을 시사한다.
하지만 연구진은 이번 연구가 AI 프로그래밍 에이전트의 능력에 근본적인 한계가 있음을 시사하는 것은 아니라고 강조했다. 프롬프트 전략을 개선하거나, 더 많은 인간 피드백을 반영하거나, 반복적인 수정 과정을 거친다면 자동 평가와 수동 검토 간의 격차는 줄어들 수 있다. 또한 실험 환경은 실제 개발 과정과 차이가 있다. 예를 들어, AI 에이전트는 단 한 번의 제출 기회만 주어진 반면, 인간 개발자는 일반적으로 피드백을 바탕으로 코드를 반복적으로 수정할 수 있다.
요약하자면, 이 연구는 AI 프로그래밍 에이전트의 실용적 유용성을 평가할 때 벤치마크 점수에만 의존하는 것은 체계적인 편향을 초래할 수 있다고 결론지었다. AI 코딩 모델이 급속히 진화함에 따라, 실제 개발 환경을 더 잘 반영하는 평가 시스템을 개발하는 것이 AI 소프트웨어 공학 분야의 중요한 연구 방향으로 부상했다.








 통이 랩, 직교 분리기 기술 적용된 ‘Qwen3.7-Max’ 공개… 국내 다수 벤치마크에서 1위 기록
Tongyi Lab은 차세대 AI 에이전트 파운데이션 모델인 ‘Qwen3.7-Max’를 공식 출시했습니다. 이 모델은 여러 권위 있는 벤치마크에서 1위를 차지했으며, 장기간의 생산 환경에서 지능형 에이전트가 보이는 취약성과 불안정성 등 업계의 주요 과제를 해결합니다.알려지지 않은 하드웨어 플랫폼인 ZW-M890L PPU에서 실시된 엄격한 스트레스 테스트에서
 제네시스 AI, 단일 모델로 로봇 작업 마스터… ‘챗GPT’와 유사한 전환점 마련
전 세계적으로 로봇 공학에 대한 관심이 높아지는 가운데, 제네시스 AI는 자사의 첫 번째 로봇 파운데이션 모델인 ‘GENE-26.5’를 선보였습니다. 이번 출시는 범용 로봇 공학, 특히 복잡하고 구조화되지 않은 작업을 처리하는 분야에서 큰 도약을 의미합니다.최근 공개 시연에서는 이 로봇의 놀라운 민첩성과 자율성이 돋보였습니다. 한 손으로 달걀을 휘젓는 것과
 마이크로소프트, 16개 언어에서 동시에 듣고 말할 수 있는 자체 개발한 최초의 전이중 AI 음성 모델 공개
기술 전문 매체 TestingCatalog에 따르면, 마이크로소프트는 현재 자사의 첫 번째 네이티브 실시간 음성 모델인 ‘MAI Realtime’을 테스트 중입니다. 16개 언어와 두 가지 독특한 음성 스타일을 지원하는 이 시스템은 듣기와 말하기를 동시에 처리할 수 있어, 자동 언어 감지 및 대화 도중 언어 전환이 가능합니다. 이러한 발전 덕분에 사용자는

2026년 최신 최고 인기 AI 만화 배경 생성기 시리즈물! 이 엄선된 목록에는 창작자가 놀라운 시각적 콘텐츠를 빠르게 제작할 수 있도록 도와주는 강력한 게임 체인저 도구들이 포함되어 있어 생산성을 크게 향상시킵니다. 모든 옵션은 최고 품질을 보장하기 위해 실제 테스트를 거쳤습니다. 무료와 유료 비교 및 순위를 확인하여 자신에게 가장 적합한 도구를 찾아보세요. XIX.AI에서 지금 탐색하고 만화 제작에서 AI의 이점을 활용하세요.
9 도구
xix.ai

‘2026년 최신 최고의 AI 채팅 동반자 순위’는 자연스러운 대화를 나누고 장기 기억을 유지하는 능력으로 정평이 난, 최고 평점을 받은 강력한 도구들을 소개합니다. 이 엄선된 목록에는 실제 테스트를 거치고 매주 업데이트되는 순위를 바탕으로, 무료 및 유료 서비스 전반에 걸쳐 꼭 사용해 봐야 할 옵션들이 포함되어 있습니다. XIX.AI는 이 엄선된 목록에서 신뢰할 수 있는 선택지로 두각을 나타내고 있습니다. 지금 바로 살펴보고 나에게 딱 맞는 AI 채팅 동반자를 찾아, 오늘부터 생산성을 한 단계 높여보세요.
11 도구
xix.ai
2026년 최신 최고 인기 AI 애니메이션 생성기! XIX.AI는 창의적인 아이디어를 고품질 모션 클립으로 빠르게 변환할 수 있는 필수 도구들을 엄선한 혁신적인 컬렉션을 제공합니다. 각 옵션은 철저한 실제 테스트를 거쳤으며, 무료와 유료 버전의 상세 비교와 매주 업데이트되는 랭킹을 제공하여 애니메이션 생산성을 높일 수 있는 최적의 도구를 찾을 수 있도록 도와줍니다. 지금 바로 탐색하고 AI 경쟁력을 확보하세요!
11 도구
xix.ai
2026년 최신 최고 평점을 받은 대규모 오디오 현지화를 위한 최고의 다국어 AI 음성 생성기. 이 엄선된 목록에는 고품질의 현지화된 오디오를 신속하게 제공하는 강력하고 혁신적인 도구들이 포함되어 있습니다. 각 옵션은 신뢰성을 보장하기 위해 엄격한 실제 테스트를 거쳤습니다. 무료 버전과 유료 버전을 비교해 보고, 여러분의 프로젝트에 가장 적합한 도구를 찾아보세요. 지금 XIX.AI에서 탐색하여 AI를 활용한 경쟁 우위를 확보하세요.
18 도구
xix.ai
2026년 최신 최고 평점을 받은 AI 개요 생성기: 장문 SEO 기사, 브리프, 필러 페이지용. XIX.AI는 매주 업데이트되는 실제 테스트를 거쳐 엄선한, 판도를 바꿀 만한 강력한 도구 모음을 제공하며, 글쓰기 효율을 높이고 콘텐츠 제작 과정을 간소화하며 AI의 장점을 최대한 활용할 수 있도록 도와주는 꼭 사용해 봐야 할 도구들을 소개합니다. 지금 바로 탐색하여 최고의 SEO 성과를 거둘 수 있는 완벽한 도구를 찾아보세요.
11 도구
xix.ai
2026년 최신 최고 평점을 받은 AI 음성-문서 변환 어시스턴트 가이드! XIX.AI는 모든 팀 대화를 즉시 완벽하고 체계적인 기록으로 변환해 주는, 매우 강력하고 혁신적인 도구 모음을 엄선했습니다. 매주 업데이트되는 저희 순위 목록에는 무료 및 유료 옵션이 모두 포함되어 있으며, 모든 업무 상황에서 생산성을 높이는 데 얼마나 효과적인지 보여주는 실제 테스트 결과도 함께 제공됩니다. AI의 장점을 최대한 활용하고자 하는 분이라면 꼭 시도해 보셔야 할 필수 가이드입니다. 지금 바로 확인해 보세요!
9 도구
xix.ai

Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?












