


 Hogar
Un estudio revela que el rendimiento del código de IA se ha exagerado en las pruebas en condiciones reales
Una investigación del instituto METR indica que el popular banco de pruebas SWE-bench Verified, utilizado para evaluar las capacidades de programación de la IA, podría sobrevalorar significativamente el rendimiento de los agentes de IA en el desarrollo de software en el mundo real. El estudio reveló que aproximadamente la mitad de las soluciones de código generadas por IA que el banco de pruebas calificó como «aprobadas» probablemente serían rechazadas por los responsables de los proyectos reales durante la revisión del código, lo que pone de manifiesto una brecha considerable entre los resultados de la evaluación automatizada y la calidad del código en la práctica.
SWE-bench Verified se ha considerado durante mucho tiempo un estándar clave para evaluar la ingeniería de software asistida por IA, ya que comprueba si los modelos pueden resolver tareas de programación reales en proyectos de código abierto y verifica si los cambios en el código superan el conjunto de pruebas automatizadas del proyecto. Varias empresas de IA, entre ellas Anthropic y OpenAI, citan con frecuencia los resultados de este benchmark para demostrar los avances de sus modelos.
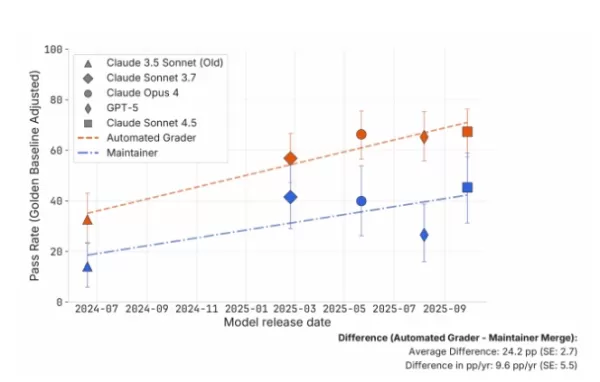
En este estudio, el equipo de METR contó con cuatro desarrolladores experimentados que mantienen los proyectos de código abierto scikit-learn, Sphinx y pytest para revisar manualmente 296 fragmentos de código generado por IA. Estas muestras de código fueron producidas por cinco modelos diferentes: Claude 3.5 Sonnet, Claude 3.7 Sonnet, Claude 4 Opus, Claude 4.5 Sonnet y GPT-5. Los resultados revelaron que la tasa de aceptación real por parte de los mantenedores fue, de media, unos 24 puntos porcentuales inferior a las puntuaciones automatizadas de SWE-bench, una diferencia estadísticamente significativa.
El estudio también determinó que el código de IA rechazado no se debía principalmente a cuestiones de estilo, sino más bien a fallos de ingeniería más sustanciales. Los mantenedores clasificaron los problemas en tres tipos principales: calidad del código que no cumplía con las especificaciones del proyecto, alteración de la estructura del código existente y errores funcionales fundamentales. Una parte significativa de los casos implicaba errores funcionales en los que, a pesar de superar las pruebas automatizadas, el código no resolvía correctamente el problema previsto.
En cuanto a la comparación de modelos, la investigación reveló que la actualización de Claude 3.5 Sonnet a Claude 3.7 Sonnet mejoró significativamente la tasa de superación de las pruebas de referencia, pero también aumentó el número de errores funcionales señalados por los mantenedores. La transición de Claude 3.7 Sonnet a Claude 4 Opus supuso un aumento de los problemas de calidad del código, mientras que Claude 4.5 Sonnet mostró mejoras en la calidad del código. Por el contrario, GPT-5 obtuvo unos resultados notablemente peores en general que la serie de modelos de Anthropic en esta evaluación manual.
El equipo de investigación también realizó un análisis estimado del «tiempo de finalización de tareas»: según los resultados de la evaluación automatizada de SWE-bench, Claude 4.5 Sonnet necesitaría aproximadamente 50 minutos de esfuerzo humano para completar tareas con una tasa de éxito del 50 %. Sin embargo, según las puntuaciones de los mantenedores, el tiempo estimado se reduce a solo unos 8 minutos, lo que sugiere que el benchmark podría sobreestimar las capacidades hasta siete veces.
No obstante, los investigadores también hicieron hincapié en que este estudio no implica un límite fundamental en las capacidades de los agentes de programación de IA. Con estrategias de prompting mejoradas, más retroalimentación humana o múltiples ciclos de iteración, la brecha entre la evaluación automatizada y la revisión manual podría reducirse. Además, la configuración experimental difiere de los procesos de desarrollo reales; por ejemplo, los agentes de IA solo tenían un intento de envío, mientras que los desarrolladores humanos suelen modificar el código de forma iterativa basándose en la retroalimentación.
En resumen, el estudio concluye que basarse únicamente en las puntuaciones de los benchmarks para evaluar la utilidad práctica de los agentes de programación de IA puede introducir un sesgo sistemático. A medida que los modelos de codificación de IA evolucionan rápidamente, el desarrollo de sistemas de evaluación que reflejen mejor los entornos de desarrollo del mundo real se ha convertido en una línea de investigación crucial en la ingeniería de software de IA.
Artículo relacionado
 Tencent presenta el agente creativo de IA Miora, que permite a los principiantes en diseño generar soluciones visuales completas con un solo clic
Tencent ha lanzado oficialmente Miora, su más reciente agente creativo de inteligencia artificial, haciendo que el diseño inteligente sea accesible para un público más amplio. Para fomentar su adopción, la plataforma otorga a cada nuevo registrante 1
La pareja de Lady Gaga respalda a una empresa biotecnológica que utiliza piel viva para entrenar a la inteligencia artificial en el ámbito de la investigación y el desarrollo en el sector de la belleza
Lejos del foco mediático de Silicon Valley, la startup biotecnológica Outer Biosciences está redefiniendo los fundamentos de la investigación médica y de la belleza. Cofundada por Michael Polansky, pa
Spotify a Etiquetas Perfiles de IA Persona, Excluir Música de las Recomendaciones
Spotify anunció el martes que comenzará a etiquetar a los artistas generados por inteligencia artificial con etiquetas de perfil “Persona de IA” y excluirá sus canciones de las recomendaciones editoriales y algorítmicas.A partir de mediados de septie
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (2)
0/500
![MichaelMartinez]()
Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
![GregoryRamirez]()
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?
Una investigación del instituto METR indica que el popular banco de pruebas SWE-bench Verified, utilizado para evaluar las capacidades de programación de la IA, podría sobrevalorar significativamente el rendimiento de los agentes de IA en el desarrollo de software en el mundo real. El estudio reveló que aproximadamente la mitad de las soluciones de código generadas por IA que el banco de pruebas calificó como «aprobadas» probablemente serían rechazadas por los responsables de los proyectos reales durante la revisión del código, lo que pone de manifiesto una brecha considerable entre los resultados de la evaluación automatizada y la calidad del código en la práctica.
SWE-bench Verified se ha considerado durante mucho tiempo un estándar clave para evaluar la ingeniería de software asistida por IA, ya que comprueba si los modelos pueden resolver tareas de programación reales en proyectos de código abierto y verifica si los cambios en el código superan el conjunto de pruebas automatizadas del proyecto. Varias empresas de IA, entre ellas Anthropic y OpenAI, citan con frecuencia los resultados de este benchmark para demostrar los avances de sus modelos.
En este estudio, el equipo de METR contó con cuatro desarrolladores experimentados que mantienen los proyectos de código abierto scikit-learn, Sphinx y pytest para revisar manualmente 296 fragmentos de código generado por IA. Estas muestras de código fueron producidas por cinco modelos diferentes: Claude 3.5 Sonnet, Claude 3.7 Sonnet, Claude 4 Opus, Claude 4.5 Sonnet y GPT-5. Los resultados revelaron que la tasa de aceptación real por parte de los mantenedores fue, de media, unos 24 puntos porcentuales inferior a las puntuaciones automatizadas de SWE-bench, una diferencia estadísticamente significativa.
El estudio también determinó que el código de IA rechazado no se debía principalmente a cuestiones de estilo, sino más bien a fallos de ingeniería más sustanciales. Los mantenedores clasificaron los problemas en tres tipos principales: calidad del código que no cumplía con las especificaciones del proyecto, alteración de la estructura del código existente y errores funcionales fundamentales. Una parte significativa de los casos implicaba errores funcionales en los que, a pesar de superar las pruebas automatizadas, el código no resolvía correctamente el problema previsto.
En cuanto a la comparación de modelos, la investigación reveló que la actualización de Claude 3.5 Sonnet a Claude 3.7 Sonnet mejoró significativamente la tasa de superación de las pruebas de referencia, pero también aumentó el número de errores funcionales señalados por los mantenedores. La transición de Claude 3.7 Sonnet a Claude 4 Opus supuso un aumento de los problemas de calidad del código, mientras que Claude 4.5 Sonnet mostró mejoras en la calidad del código. Por el contrario, GPT-5 obtuvo unos resultados notablemente peores en general que la serie de modelos de Anthropic en esta evaluación manual.
El equipo de investigación también realizó un análisis estimado del «tiempo de finalización de tareas»: según los resultados de la evaluación automatizada de SWE-bench, Claude 4.5 Sonnet necesitaría aproximadamente 50 minutos de esfuerzo humano para completar tareas con una tasa de éxito del 50 %. Sin embargo, según las puntuaciones de los mantenedores, el tiempo estimado se reduce a solo unos 8 minutos, lo que sugiere que el benchmark podría sobreestimar las capacidades hasta siete veces.
No obstante, los investigadores también hicieron hincapié en que este estudio no implica un límite fundamental en las capacidades de los agentes de programación de IA. Con estrategias de prompting mejoradas, más retroalimentación humana o múltiples ciclos de iteración, la brecha entre la evaluación automatizada y la revisión manual podría reducirse. Además, la configuración experimental difiere de los procesos de desarrollo reales; por ejemplo, los agentes de IA solo tenían un intento de envío, mientras que los desarrolladores humanos suelen modificar el código de forma iterativa basándose en la retroalimentación.
En resumen, el estudio concluye que basarse únicamente en las puntuaciones de los benchmarks para evaluar la utilidad práctica de los agentes de programación de IA puede introducir un sesgo sistemático. A medida que los modelos de codificación de IA evolucionan rápidamente, el desarrollo de sistemas de evaluación que reflejen mejor los entornos de desarrollo del mundo real se ha convertido en una línea de investigación crucial en la ingeniería de software de IA.








 Tencent presenta el agente creativo de IA Miora, que permite a los principiantes en diseño generar soluciones visuales completas con un solo clic
Tencent ha lanzado oficialmente Miora, su más reciente agente creativo de inteligencia artificial, haciendo que el diseño inteligente sea accesible para un público más amplio. Para fomentar su adopción, la plataforma otorga a cada nuevo registrante 1
 La pareja de Lady Gaga respalda a una empresa biotecnológica que utiliza piel viva para entrenar a la inteligencia artificial en el ámbito de la investigación y el desarrollo en el sector de la belleza
Lejos del foco mediático de Silicon Valley, la startup biotecnológica Outer Biosciences está redefiniendo los fundamentos de la investigación médica y de la belleza. Cofundada por Michael Polansky, pa
 Spotify a Etiquetas Perfiles de IA Persona, Excluir Música de las Recomendaciones
Spotify anunció el martes que comenzará a etiquetar a los artistas generados por inteligencia artificial con etiquetas de perfil “Persona de IA” y excluirá sus canciones de las recomendaciones editoriales y algorítmicas.A partir de mediados de septie

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?












