


 Heim
Studie zeigt: Die Leistungsfähigkeit von KI-Code wird in Praxistests überbewertet
Untersuchungen des METR-Instituts deuten darauf hin, dass der weit verbreitete Benchmark „SWE-bench Verified“ zur Bewertung der Programmierfähigkeiten von KI die Leistung von KI-Agenten in der realen Softwareentwicklung möglicherweise erheblich überbewertet. Die Studie ergab, dass etwa die Hälfte der von der KI generierten Code-Lösungen, die vom Benchmark als „bestanden“ eingestuft wurden, von den tatsächlichen Projektverantwortlichen bei der Code-Überprüfung wahrscheinlich abgelehnt würden, was eine erhebliche Diskrepanz zwischen automatisierten Bewertungsergebnissen und der tatsächlichen Code-Qualität verdeutlicht.
SWE-bench Verified gilt seit langem als wichtiger Standard zur Bewertung KI-gestützter Softwareentwicklung, um zu testen, ob Modelle echte Programmieraufgaben in Open-Source-Projekten lösen können, und um zu überprüfen, ob Codeänderungen die automatisierte Testsuite des Projekts bestehen. Mehrere KI-Unternehmen, darunter Anthropic und OpenAI, zitieren häufig Ergebnisse dieses Benchmarks, um Modellfortschritte zu demonstrieren.
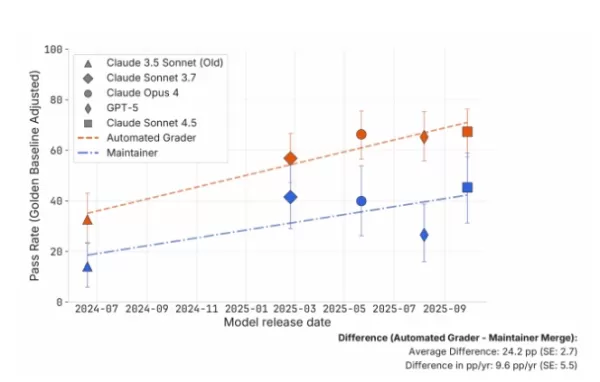
In dieser Studie beauftragte das METR-Team vier erfahrene Entwickler, die die Open-Source-Projekte scikit-learn, Sphinx und pytest betreuen, mit der manuellen Überprüfung von 296 AI-generierten Code-Beispielen. Diese Code-Beispiele wurden von fünf verschiedenen Modellen erzeugt: Claude 3.5 Sonnet, Claude 3.7 Sonnet, Claude 4 Opus, Claude 4.5 Sonnet und GPT-5. Die Ergebnisse zeigten, dass die tatsächliche Akzeptanzrate durch die Betreuer im Durchschnitt etwa 24 Prozentpunkte niedriger war als die automatisierten Bewertungen von SWE-bench – ein statistisch signifikanter Unterschied.
Die Studie stellte zudem fest, dass der abgelehnte KI-Code nicht in erster Linie auf stilistische Probleme zurückzuführen war, sondern vielmehr auf wesentlich schwerwiegendere technische Mängel. Die Betreuer kategorisierten die Probleme in drei Haupttypen: Codequalität, die nicht den Projektspezifikationen entsprach, Störung der bestehenden Codestruktur und grundlegende Funktionsfehler. Ein erheblicher Teil der Fälle betraf Funktionsfehler, bei denen der Code trotz bestandener automatisierter Tests das beabsichtigte Problem nicht korrekt löste.
Was den Modellvergleich betrifft, so ergab die Untersuchung, dass ein Upgrade von Claude 3.5 Sonnet auf Claude 3.7 Sonnet die Benchmark-Erfolgsquote deutlich verbesserte, die Anzahl der von den Betreuern gemeldeten Funktionsfehler jedoch ebenfalls zunahm. Der Übergang von Claude 3.7 Sonnet zu Claude 4 Opus führte zu einer Zunahme von Problemen mit der Codequalität, während Claude 4.5 Sonnet Verbesserungen in der Codequalität zeigte. Im Gegensatz dazu schnitt GPT-5 bei dieser manuellen Bewertung insgesamt deutlich schlechter ab als die Anthropic-Modellreihe.
Das Forschungsteam führte zudem eine geschätzte Analyse der „Aufgabenbearbeitungszeit“ durch: Laut den automatisierten Bewertungsergebnissen von SWE-bench würde Claude 4.5 Sonnet bei einer Erfolgsquote von 50 % etwa 50 Minuten menschlicher Arbeitszeit benötigen, um Aufgaben zu erledigen. Basierend auf den Bewertungen der Betreuer sinkt die geschätzte Zeit jedoch auf nur etwa 8 Minuten, was darauf hindeutet, dass der Benchmark die Fähigkeiten um das bis zu Siebenfache überschätzt.
Die Forscher betonten jedoch auch, dass diese Studie keine grundlegende Begrenzung der Fähigkeiten von KI-Programmieragenten impliziert. Mit verbesserten Prompt-Strategien, mehr menschlichem Feedback oder mehreren Iterationszyklen könnte die Lücke zwischen automatisierter Bewertung und manueller Überprüfung verringert werden. Zudem unterscheidet sich der Versuchsaufbau von realen Entwicklungsprozessen – so hatten KI-Agenten beispielsweise nur einen Einreichungsversuch, während menschliche Entwickler den Code in der Regel iterativ auf der Grundlage von Feedback modifizieren können.
Zusammenfassend kommt die Studie zu dem Schluss, dass das ausschließliche Verlassen auf Benchmark-Ergebnisse zur Beurteilung des praktischen Nutzens von KI-Programmieragenten zu systematischen Verzerrungen führen kann. Da sich KI-Codierungsmodelle rasch weiterentwickeln, ist die Entwicklung von Bewertungssystemen, die reale Entwicklungsumgebungen besser widerspiegeln, zu einer entscheidenden Forschungsrichtung im Bereich der KI-Softwareentwicklung geworden.
Verwandter Artikel
 Anthropic bringt Opus 5 auf den Markt
Anthropic hat am Freitag Opus 5 vorgestellt, die neueste Version seines Flaggschiff-Modells. Obwohl es kleiner als Fable 5 ist, bietet diese Version niedrigere Kosten und weniger Einschränkungen, was sie zur bevorzugten Wahl für die meisten Anwendung
Künstliche Intelligenz löst fast US-Militäroperation aus
Während des Frühlings machten US-Beamte eine schockierende Entdeckung, während Militärflugzeuge bereits in der Luft waren: Die nachrichtendienstlichen Informationen, die einen bewaffneten Schlag gegen ein chinesisches Schiff anleiteten, waren vollstä
Nvidias Les Karpas: Roboter warten auf den ChatGPT-Moment auf der TechCrunch Disrupt 2026
Die Einführung von ChatGPT im November 2022 verlagerte die KI abrupt von theoretischem Hype hin zur alltäglichen Nutzung und veränderte grundlegend, wie wir mit großen Sprachmodellen interagieren.Robotik war lange ein Thema der Diskussion und Entwick
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (2)
![MichaelMartinez]()
Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
![GregoryRamirez]()
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?
Untersuchungen des METR-Instituts deuten darauf hin, dass der weit verbreitete Benchmark „SWE-bench Verified“ zur Bewertung der Programmierfähigkeiten von KI die Leistung von KI-Agenten in der realen Softwareentwicklung möglicherweise erheblich überbewertet. Die Studie ergab, dass etwa die Hälfte der von der KI generierten Code-Lösungen, die vom Benchmark als „bestanden“ eingestuft wurden, von den tatsächlichen Projektverantwortlichen bei der Code-Überprüfung wahrscheinlich abgelehnt würden, was eine erhebliche Diskrepanz zwischen automatisierten Bewertungsergebnissen und der tatsächlichen Code-Qualität verdeutlicht.
SWE-bench Verified gilt seit langem als wichtiger Standard zur Bewertung KI-gestützter Softwareentwicklung, um zu testen, ob Modelle echte Programmieraufgaben in Open-Source-Projekten lösen können, und um zu überprüfen, ob Codeänderungen die automatisierte Testsuite des Projekts bestehen. Mehrere KI-Unternehmen, darunter Anthropic und OpenAI, zitieren häufig Ergebnisse dieses Benchmarks, um Modellfortschritte zu demonstrieren.
In dieser Studie beauftragte das METR-Team vier erfahrene Entwickler, die die Open-Source-Projekte scikit-learn, Sphinx und pytest betreuen, mit der manuellen Überprüfung von 296 AI-generierten Code-Beispielen. Diese Code-Beispiele wurden von fünf verschiedenen Modellen erzeugt: Claude 3.5 Sonnet, Claude 3.7 Sonnet, Claude 4 Opus, Claude 4.5 Sonnet und GPT-5. Die Ergebnisse zeigten, dass die tatsächliche Akzeptanzrate durch die Betreuer im Durchschnitt etwa 24 Prozentpunkte niedriger war als die automatisierten Bewertungen von SWE-bench – ein statistisch signifikanter Unterschied.
Die Studie stellte zudem fest, dass der abgelehnte KI-Code nicht in erster Linie auf stilistische Probleme zurückzuführen war, sondern vielmehr auf wesentlich schwerwiegendere technische Mängel. Die Betreuer kategorisierten die Probleme in drei Haupttypen: Codequalität, die nicht den Projektspezifikationen entsprach, Störung der bestehenden Codestruktur und grundlegende Funktionsfehler. Ein erheblicher Teil der Fälle betraf Funktionsfehler, bei denen der Code trotz bestandener automatisierter Tests das beabsichtigte Problem nicht korrekt löste.
Was den Modellvergleich betrifft, so ergab die Untersuchung, dass ein Upgrade von Claude 3.5 Sonnet auf Claude 3.7 Sonnet die Benchmark-Erfolgsquote deutlich verbesserte, die Anzahl der von den Betreuern gemeldeten Funktionsfehler jedoch ebenfalls zunahm. Der Übergang von Claude 3.7 Sonnet zu Claude 4 Opus führte zu einer Zunahme von Problemen mit der Codequalität, während Claude 4.5 Sonnet Verbesserungen in der Codequalität zeigte. Im Gegensatz dazu schnitt GPT-5 bei dieser manuellen Bewertung insgesamt deutlich schlechter ab als die Anthropic-Modellreihe.
Das Forschungsteam führte zudem eine geschätzte Analyse der „Aufgabenbearbeitungszeit“ durch: Laut den automatisierten Bewertungsergebnissen von SWE-bench würde Claude 4.5 Sonnet bei einer Erfolgsquote von 50 % etwa 50 Minuten menschlicher Arbeitszeit benötigen, um Aufgaben zu erledigen. Basierend auf den Bewertungen der Betreuer sinkt die geschätzte Zeit jedoch auf nur etwa 8 Minuten, was darauf hindeutet, dass der Benchmark die Fähigkeiten um das bis zu Siebenfache überschätzt.
Die Forscher betonten jedoch auch, dass diese Studie keine grundlegende Begrenzung der Fähigkeiten von KI-Programmieragenten impliziert. Mit verbesserten Prompt-Strategien, mehr menschlichem Feedback oder mehreren Iterationszyklen könnte die Lücke zwischen automatisierter Bewertung und manueller Überprüfung verringert werden. Zudem unterscheidet sich der Versuchsaufbau von realen Entwicklungsprozessen – so hatten KI-Agenten beispielsweise nur einen Einreichungsversuch, während menschliche Entwickler den Code in der Regel iterativ auf der Grundlage von Feedback modifizieren können.
Zusammenfassend kommt die Studie zu dem Schluss, dass das ausschließliche Verlassen auf Benchmark-Ergebnisse zur Beurteilung des praktischen Nutzens von KI-Programmieragenten zu systematischen Verzerrungen führen kann. Da sich KI-Codierungsmodelle rasch weiterentwickeln, ist die Entwicklung von Bewertungssystemen, die reale Entwicklungsumgebungen besser widerspiegeln, zu einer entscheidenden Forschungsrichtung im Bereich der KI-Softwareentwicklung geworden.








 Anthropic bringt Opus 5 auf den Markt
Anthropic hat am Freitag Opus 5 vorgestellt, die neueste Version seines Flaggschiff-Modells. Obwohl es kleiner als Fable 5 ist, bietet diese Version niedrigere Kosten und weniger Einschränkungen, was sie zur bevorzugten Wahl für die meisten Anwendung
 Künstliche Intelligenz löst fast US-Militäroperation aus
Während des Frühlings machten US-Beamte eine schockierende Entdeckung, während Militärflugzeuge bereits in der Luft waren: Die nachrichtendienstlichen Informationen, die einen bewaffneten Schlag gegen ein chinesisches Schiff anleiteten, waren vollstä
 Nvidias Les Karpas: Roboter warten auf den ChatGPT-Moment auf der TechCrunch Disrupt 2026
Die Einführung von ChatGPT im November 2022 verlagerte die KI abrupt von theoretischem Hype hin zur alltäglichen Nutzung und veränderte grundlegend, wie wir mit großen Sprachmodellen interagieren.Robotik war lange ein Thema der Diskussion und Entwick

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?












