


 Maison
Une étude révèle que les performances des codes d'IA sont surestimées lors des tests en conditions réelles
Une étude menée par l'institut METR indique que le benchmark SWE-bench Verified, largement utilisé pour évaluer les capacités de programmation de l'IA, pourrait surestimer de manière significative les performances des agents IA dans le développement logiciel en conditions réelles. L'étude a révélé qu'environ la moitié des solutions de code générées par l'IA et jugées « conformes » par le benchmark seraient probablement rejetées par les responsables de projets lors d'une revue de code, soulignant ainsi un écart considérable entre les résultats des évaluations automatisées et la qualité réelle du code.
SWE-bench Verified est depuis longtemps considéré comme une norme clé pour évaluer l'ingénierie logicielle assistée par l'IA, permettant de tester si les modèles peuvent résoudre de véritables tâches de programmation dans des projets open source et de vérifier si les modifications de code passent la suite de tests automatisés du projet. Plusieurs entreprises d'IA, dont Anthropic et OpenAI, citent fréquemment les résultats de ce benchmark pour démontrer les progrès de leurs modèles.
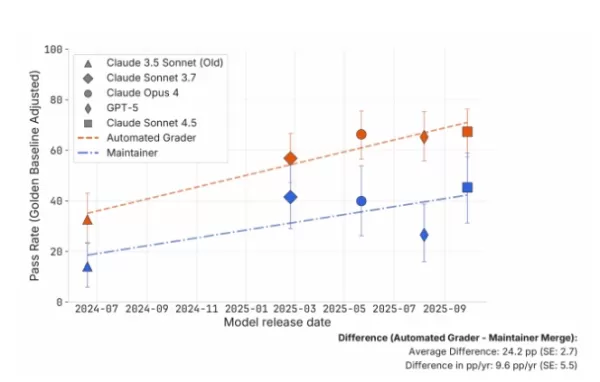
Dans cette étude, l'équipe METR a fait appel à quatre développeurs expérimentés chargés de la maintenance des projets open source scikit-learn, Sphinx et pytest pour examiner manuellement 296 extraits de code générés par l'IA. Ces échantillons de code ont été produits par cinq modèles différents : Claude 3.5 Sonnet, Claude 3.7 Sonnet, Claude 4 Opus, Claude 4.5 Sonnet et GPT-5. Les résultats ont révélé que le taux d'acceptation réel par les responsables de maintenance était, en moyenne, inférieur d'environ 24 points de pourcentage aux scores automatisés de SWE-bench — une différence statistiquement significative.
L'étude a également déterminé que le rejet du code généré par l'IA n'était pas principalement dû à des problèmes de style, mais plutôt à des défauts techniques plus importants. Les responsables de maintenance ont classé les problèmes en trois catégories principales : une qualité de code ne répondant pas aux spécifications du projet, une perturbation de la structure du code existant et des erreurs fonctionnelles fondamentales. Une part importante des cas concernait des erreurs fonctionnelles où, bien que le code ait réussi les tests automatisés, il ne résolvait pas correctement le problème visé.
En ce qui concerne la comparaison des modèles, la recherche a révélé que le passage de Claude 3.5 Sonnet à Claude 3.7 Sonnet améliorait considérablement le taux de réussite aux tests de référence, mais que le nombre d'erreurs fonctionnelles signalées par les responsables de maintenance augmentait également. Le passage de Claude 3.7 Sonnet à Claude 4 Opus a entraîné une augmentation des problèmes de qualité du code, tandis que Claude 4.5 Sonnet a montré des améliorations en la matière. En revanche, GPT-5 a obtenu des résultats globalement nettement inférieurs à ceux de la série de modèles Anthropic lors de cette évaluation manuelle.
L'équipe de recherche a également effectué une analyse estimative du « temps de réalisation des tâches » : selon les résultats de l'évaluation automatisée SWE-bench, il faudrait environ 50 minutes d'effort humain à Claude 4.5 Sonnet pour accomplir des tâches avec un taux de réussite de 50 %. Cependant, d'après les notes attribuées par les responsables de maintenance, le temps estimé tombe à seulement environ 8 minutes, ce qui suggère que le benchmark pourrait surestimer les capacités jusqu'à sept fois.
Les chercheurs ont toutefois souligné que cette étude n’implique pas une limite fondamentale des capacités des agents de programmation IA. Avec des stratégies d’invite améliorées, davantage de retours humains ou des cycles d’itération multiples, l’écart entre l’évaluation automatisée et l’examen manuel pourrait être réduit. De plus, le cadre expérimental diffère des processus de développement réels : par exemple, les agents IA n’avaient droit qu’à une seule tentative de soumission, alors que les développeurs humains peuvent généralement modifier le code de manière itérative en fonction des retours.
En résumé, l'étude conclut que le fait de se fier uniquement aux scores de référence pour évaluer l'utilité pratique des agents de programmation IA peut introduire un biais systématique. Alors que les modèles de codage IA évoluent rapidement, le développement de systèmes d'évaluation reflétant mieux les environnements de développement réels est devenu un axe de recherche crucial en génie logiciel IA.
Article connexe
 Anthropic lance Opus 5
Anthropic a dévoilé Opus 5 vendredi, la dernière itération de son modèle phare. Bien que plus petit que Fable 5, cette version offre des coûts inférieurs et moins de restrictions, ce qui en fait le choix privilégié pour la plupart des applications.I
Une hallucination de l'IA a failli déclencher une opération militaire américaine
Au cours du printemps, des responsables américains ont fait une découverte stupéfiante alors que des avions militaires étaient déjà en l’air : les renseignements qui guidaient une frappe armée contre un navire chinois avaient été entièrement fabriqué
Les Karpas de Nvidia : des robots en attente d’un moment ChatGPT lors de TechCrunch Disrupt 2026
Le lancement de ChatGPT en novembre 2022 a brusquement fait passer l’IA d’une hypothèse théorique à une utilité quotidienne, modifiant fondamentalement notre façon d’interagir avec les grands modèles de langage.La robotique fait depuis longtemps l’ob
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (2)
![MichaelMartinez]()
Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
![GregoryRamirez]()
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?
Une étude menée par l'institut METR indique que le benchmark SWE-bench Verified, largement utilisé pour évaluer les capacités de programmation de l'IA, pourrait surestimer de manière significative les performances des agents IA dans le développement logiciel en conditions réelles. L'étude a révélé qu'environ la moitié des solutions de code générées par l'IA et jugées « conformes » par le benchmark seraient probablement rejetées par les responsables de projets lors d'une revue de code, soulignant ainsi un écart considérable entre les résultats des évaluations automatisées et la qualité réelle du code.
SWE-bench Verified est depuis longtemps considéré comme une norme clé pour évaluer l'ingénierie logicielle assistée par l'IA, permettant de tester si les modèles peuvent résoudre de véritables tâches de programmation dans des projets open source et de vérifier si les modifications de code passent la suite de tests automatisés du projet. Plusieurs entreprises d'IA, dont Anthropic et OpenAI, citent fréquemment les résultats de ce benchmark pour démontrer les progrès de leurs modèles.
Dans cette étude, l'équipe METR a fait appel à quatre développeurs expérimentés chargés de la maintenance des projets open source scikit-learn, Sphinx et pytest pour examiner manuellement 296 extraits de code générés par l'IA. Ces échantillons de code ont été produits par cinq modèles différents : Claude 3.5 Sonnet, Claude 3.7 Sonnet, Claude 4 Opus, Claude 4.5 Sonnet et GPT-5. Les résultats ont révélé que le taux d'acceptation réel par les responsables de maintenance était, en moyenne, inférieur d'environ 24 points de pourcentage aux scores automatisés de SWE-bench — une différence statistiquement significative.
L'étude a également déterminé que le rejet du code généré par l'IA n'était pas principalement dû à des problèmes de style, mais plutôt à des défauts techniques plus importants. Les responsables de maintenance ont classé les problèmes en trois catégories principales : une qualité de code ne répondant pas aux spécifications du projet, une perturbation de la structure du code existant et des erreurs fonctionnelles fondamentales. Une part importante des cas concernait des erreurs fonctionnelles où, bien que le code ait réussi les tests automatisés, il ne résolvait pas correctement le problème visé.
En ce qui concerne la comparaison des modèles, la recherche a révélé que le passage de Claude 3.5 Sonnet à Claude 3.7 Sonnet améliorait considérablement le taux de réussite aux tests de référence, mais que le nombre d'erreurs fonctionnelles signalées par les responsables de maintenance augmentait également. Le passage de Claude 3.7 Sonnet à Claude 4 Opus a entraîné une augmentation des problèmes de qualité du code, tandis que Claude 4.5 Sonnet a montré des améliorations en la matière. En revanche, GPT-5 a obtenu des résultats globalement nettement inférieurs à ceux de la série de modèles Anthropic lors de cette évaluation manuelle.
L'équipe de recherche a également effectué une analyse estimative du « temps de réalisation des tâches » : selon les résultats de l'évaluation automatisée SWE-bench, il faudrait environ 50 minutes d'effort humain à Claude 4.5 Sonnet pour accomplir des tâches avec un taux de réussite de 50 %. Cependant, d'après les notes attribuées par les responsables de maintenance, le temps estimé tombe à seulement environ 8 minutes, ce qui suggère que le benchmark pourrait surestimer les capacités jusqu'à sept fois.
Les chercheurs ont toutefois souligné que cette étude n’implique pas une limite fondamentale des capacités des agents de programmation IA. Avec des stratégies d’invite améliorées, davantage de retours humains ou des cycles d’itération multiples, l’écart entre l’évaluation automatisée et l’examen manuel pourrait être réduit. De plus, le cadre expérimental diffère des processus de développement réels : par exemple, les agents IA n’avaient droit qu’à une seule tentative de soumission, alors que les développeurs humains peuvent généralement modifier le code de manière itérative en fonction des retours.
En résumé, l'étude conclut que le fait de se fier uniquement aux scores de référence pour évaluer l'utilité pratique des agents de programmation IA peut introduire un biais systématique. Alors que les modèles de codage IA évoluent rapidement, le développement de systèmes d'évaluation reflétant mieux les environnements de développement réels est devenu un axe de recherche crucial en génie logiciel IA.








 Anthropic lance Opus 5
Anthropic a dévoilé Opus 5 vendredi, la dernière itération de son modèle phare. Bien que plus petit que Fable 5, cette version offre des coûts inférieurs et moins de restrictions, ce qui en fait le choix privilégié pour la plupart des applications.I
 Une hallucination de l'IA a failli déclencher une opération militaire américaine
Au cours du printemps, des responsables américains ont fait une découverte stupéfiante alors que des avions militaires étaient déjà en l’air : les renseignements qui guidaient une frappe armée contre un navire chinois avaient été entièrement fabriqué
 Les Karpas de Nvidia : des robots en attente d’un moment ChatGPT lors de TechCrunch Disrupt 2026
Le lancement de ChatGPT en novembre 2022 a brusquement fait passer l’IA d’une hypothèse théorique à une utilité quotidienne, modifiant fondamentalement notre façon d’interagir avec les grands modèles de langage.La robotique fait depuis longtemps l’ob

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?












