


 首頁
研究發現:實際測試中,AI 程式碼的效能被高估了
METR 研究所的研究指出,廣泛用於評估 AI 程式設計能力的 SWE-bench Verified 基準測試,可能嚴重高估了 AI 代理在實際軟體開發中的表現。該研究發現,約有一半由 AI 生成的程式碼解決方案雖被該基準測試標記為「通過」,但在實際專案的程式碼審查過程中,很可能遭到專案維護人員拒絕,這凸顯了自動化評估結果與實際程式碼品質之間存在著顯著差距。
SWE-bench Verified 長期以來被視為評估 AI 輔助軟體工程的關鍵標準,用於測試模型能否解決開源專案中的真實編程任務,並驗證程式碼變更是否通過專案的自動化測試套件。包括 Anthropic 和 OpenAI 在內的多家 AI 公司,經常引用此基準測試的結果來展示模型的進展。
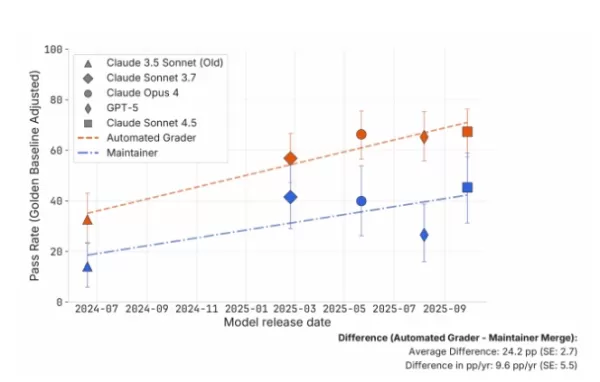
在這項研究中,METR 團隊邀請了四位負責維護 scikit-learn、Sphinx 和 pytest 等開源專案的資深開發者,對 296 段由 AI 生成的程式碼進行人工審查。這些程式碼範例由五種不同的模型產生:Claude 3.5 Sonnet、Claude 3.7 Sonnet、Claude 4 Opus、Claude 4.5 Sonnet 以及 GPT-5。 結果顯示,維護者實際的接受率平均比 SWE-bench 的自動化評分低約 24 個百分點——這是一個具有統計學意義的差異。
研究還指出,被拒絕的 AI 程式碼主要並非源於風格問題,而是更實質的工程缺陷。維護人員將問題歸類為三大類:程式碼品質未達專案規格、破壞現有程式碼結構,以及根本性的功能錯誤。其中相當一部分案例涉及功能錯誤,即儘管通過了自動化測試,程式碼卻未能正確解決預期的問題。
在模型比較方面,研究發現從 Claude 3.5 Sonnet 升級至 Claude 3.7 Sonnet 雖顯著提升了基準測試通過率,但維護人員標記的功能性錯誤數量也隨之增加。 從 Claude 3.7 Sonnet 過渡到 Claude 3.7 Sonnet 期間,問題傾向轉向更多程式碼品質問題,而 Claude 4.5 Sonnet 則在程式碼品質方面有所改善。相較之下,在此次人工評估中,GPT-5 的整體表現明顯遜於 Anthropic 模型系列。
研究團隊還針對「任務完成時間」進行了估算分析:根據 SWE-bench 自動化評估結果,若以 50% 的成功率完成任務,Claude 4.5 Sonnet 相當於需耗費約 50 分鐘的人工時間。然而,根據維護人員的評分,估算時間僅約 8 分鐘,這表明該基準測試可能將能力高估了多達七倍。
不過,研究人員也強調,這項研究並不意味著 AI 程式設計代理的能力存在根本性限制。透過改進提示策略、增加人類反饋,或進行多次迭代循環,自動化評估與人工審查之間的差距有望縮小。此外,實驗設置與實際開發流程有所不同——例如,AI 代理僅有一次提交機會,而人類開發者通常能根據反饋反覆修改程式碼。
總而言之,該研究結論指出,若僅依賴基準測試分數來評估 AI 程式設計代理的實際效用,可能會引入系統性偏差。隨著 AI 編碼模型的快速演進,開發能更真實反映實際開發環境的評估系統,已成為 AI 軟體工程領域中至關重要的研究方向。
相關文章
 內部細節曝光:下一代 Gemini 算力緊張,內部團隊在開發優先順序和資源分配上存在分歧
報告顯示,谷歌備受期待的下一代 Gemini 模型釋出已被推遲。由於內部在開發優先順序和資源分配上存在分歧,加上計算能力有限以及複雜的審批流程,導致釋出時間延後了兩個月。儘管谷歌擁有定製的 TPU 晶片,但由於模型訓練、Google Cloud 服務以及眾多消費和企業級 AI 應用對計算資源的需求相互競爭,谷歌仍面臨計算資源短缺的問題。目前,高層管理人員正透過組織結構調整來解決這些部門間的衝突。與此同時,領導層也發生了變化,聯合創始人謝爾蓋·布林越來越多地參與到核心模型訓練中,並倡導將資源專門用於
OpenAI 否認增長放緩擔憂,稱多個業務部門加速發展
針對外界對其銷售增長放緩及未達內部基準的質疑,人工智慧領域的領軍企業 OpenAI 於 4 月 28 日(星期二)發表了一份信心十足的宣告。該公司澄清稱,其消費產品和企業服務正在快速推進,直接駁斥了近期關於業務放緩的猜測。針對該公司“未達成多項內部目標”的說法,OpenAI 將這些報道斥為“典型的標題黨”。公司強調了企業對 AI 整合的強勁需求,並指出其廣告業務早期增長前景良好。據 OpenAI 內部人士透露,公司內部情緒依然樂觀。儘管市場競爭日益激烈,但公司正在向投資者傳遞信心,聲稱其商業
阿里巴巴超級盃:Qwen3.8-Max 重磅登場,程式碼與辦公工具能力全面升級
阿里巴巴正式釋出了Qwen3.8-Max,這是一款擁有2.4萬億引數的下一代基礎大模型。這一重大AI進展在編碼和專業辦公任務等核心領域帶來了顯著的效能提升,展現了強大的技術能力。在權威的Arena大模型排名中,Qwen3.8-Max取得了令人矚目的成績,僅次於Anthropic的Claude系列,位居行業前列。這一里程碑標誌著國內大模型在處理複雜任務方面取得了快速進展,為開發者和企業使用者提供了先進的智慧工具。該模型的API現已在Qwen AI平臺上上線,並整合到新推出的“Qwen Offic
相關專題推薦
音樂創作
 最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
 8 個工具
 xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai
會議助理
頂尖 AI 會議摘要工具:清晰追蹤決策與後續行動
2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai
數據分析
最佳人工智慧資料清洗工具:快速處理缺失值與重複資料
2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai

 評論 (2)
0/500
![MichaelMartinez]()
Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
![GregoryRamirez]()
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?
METR 研究所的研究指出,廣泛用於評估 AI 程式設計能力的 SWE-bench Verified 基準測試,可能嚴重高估了 AI 代理在實際軟體開發中的表現。該研究發現,約有一半由 AI 生成的程式碼解決方案雖被該基準測試標記為「通過」,但在實際專案的程式碼審查過程中,很可能遭到專案維護人員拒絕,這凸顯了自動化評估結果與實際程式碼品質之間存在著顯著差距。
SWE-bench Verified 長期以來被視為評估 AI 輔助軟體工程的關鍵標準,用於測試模型能否解決開源專案中的真實編程任務,並驗證程式碼變更是否通過專案的自動化測試套件。包括 Anthropic 和 OpenAI 在內的多家 AI 公司,經常引用此基準測試的結果來展示模型的進展。
在這項研究中,METR 團隊邀請了四位負責維護 scikit-learn、Sphinx 和 pytest 等開源專案的資深開發者,對 296 段由 AI 生成的程式碼進行人工審查。這些程式碼範例由五種不同的模型產生:Claude 3.5 Sonnet、Claude 3.7 Sonnet、Claude 4 Opus、Claude 4.5 Sonnet 以及 GPT-5。 結果顯示,維護者實際的接受率平均比 SWE-bench 的自動化評分低約 24 個百分點——這是一個具有統計學意義的差異。
研究還指出,被拒絕的 AI 程式碼主要並非源於風格問題,而是更實質的工程缺陷。維護人員將問題歸類為三大類:程式碼品質未達專案規格、破壞現有程式碼結構,以及根本性的功能錯誤。其中相當一部分案例涉及功能錯誤,即儘管通過了自動化測試,程式碼卻未能正確解決預期的問題。
在模型比較方面,研究發現從 Claude 3.5 Sonnet 升級至 Claude 3.7 Sonnet 雖顯著提升了基準測試通過率,但維護人員標記的功能性錯誤數量也隨之增加。 從 Claude 3.7 Sonnet 過渡到 Claude 3.7 Sonnet 期間,問題傾向轉向更多程式碼品質問題,而 Claude 4.5 Sonnet 則在程式碼品質方面有所改善。相較之下,在此次人工評估中,GPT-5 的整體表現明顯遜於 Anthropic 模型系列。
研究團隊還針對「任務完成時間」進行了估算分析:根據 SWE-bench 自動化評估結果,若以 50% 的成功率完成任務,Claude 4.5 Sonnet 相當於需耗費約 50 分鐘的人工時間。然而,根據維護人員的評分,估算時間僅約 8 分鐘,這表明該基準測試可能將能力高估了多達七倍。
不過,研究人員也強調,這項研究並不意味著 AI 程式設計代理的能力存在根本性限制。透過改進提示策略、增加人類反饋,或進行多次迭代循環,自動化評估與人工審查之間的差距有望縮小。此外,實驗設置與實際開發流程有所不同——例如,AI 代理僅有一次提交機會,而人類開發者通常能根據反饋反覆修改程式碼。
總而言之,該研究結論指出,若僅依賴基準測試分數來評估 AI 程式設計代理的實際效用,可能會引入系統性偏差。隨著 AI 編碼模型的快速演進,開發能更真實反映實際開發環境的評估系統,已成為 AI 軟體工程領域中至關重要的研究方向。








 內部細節曝光:下一代 Gemini 算力緊張,內部團隊在開發優先順序和資源分配上存在分歧
報告顯示,谷歌備受期待的下一代 Gemini 模型釋出已被推遲。由於內部在開發優先順序和資源分配上存在分歧,加上計算能力有限以及複雜的審批流程,導致釋出時間延後了兩個月。儘管谷歌擁有定製的 TPU 晶片,但由於模型訓練、Google Cloud 服務以及眾多消費和企業級 AI 應用對計算資源的需求相互競爭,谷歌仍面臨計算資源短缺的問題。目前,高層管理人員正透過組織結構調整來解決這些部門間的衝突。與此同時,領導層也發生了變化,聯合創始人謝爾蓋·布林越來越多地參與到核心模型訓練中,並倡導將資源專門用於
 OpenAI 否認增長放緩擔憂,稱多個業務部門加速發展
針對外界對其銷售增長放緩及未達內部基準的質疑,人工智慧領域的領軍企業 OpenAI 於 4 月 28 日(星期二)發表了一份信心十足的宣告。該公司澄清稱,其消費產品和企業服務正在快速推進,直接駁斥了近期關於業務放緩的猜測。針對該公司“未達成多項內部目標”的說法,OpenAI 將這些報道斥為“典型的標題黨”。公司強調了企業對 AI 整合的強勁需求,並指出其廣告業務早期增長前景良好。據 OpenAI 內部人士透露,公司內部情緒依然樂觀。儘管市場競爭日益激烈,但公司正在向投資者傳遞信心,聲稱其商業
 阿里巴巴超級盃:Qwen3.8-Max 重磅登場,程式碼與辦公工具能力全面升級
阿里巴巴正式釋出了Qwen3.8-Max,這是一款擁有2.4萬億引數的下一代基礎大模型。這一重大AI進展在編碼和專業辦公任務等核心領域帶來了顯著的效能提升,展現了強大的技術能力。在權威的Arena大模型排名中,Qwen3.8-Max取得了令人矚目的成績,僅次於Anthropic的Claude系列,位居行業前列。這一里程碑標誌著國內大模型在處理複雜任務方面取得了快速進展,為開發者和企業使用者提供了先進的智慧工具。該模型的API現已在Qwen AI平臺上上線,並整合到新推出的“Qwen Offic

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai

Interesting findings! I've always suspected those benchmarks were too good to be true. Real-world coding is messy, and it's no surprise that AI agents struggle with edge cases. 😅
Interessant, aber irgendwie auch nicht überraschend. Benchmarks sind oft zu optimistisch, weil sie in einer kontrollierten Umgebung laufen. In der echten Welt mit Legacy-Code, unklaren Anforderungen und Teamarbeit sieht es dann anders aus. 🤔 Vielleicht sollten wir weniger auf die Marketing-Hypes hören und mehr auf praktische Tests setzen. Wer hat schon Erfahrung mit AI-Coding-Tools im Alltag gemacht?












