


 Дом
Google GEPA повышает производительность LLM, обходя дорогостоящее обучение с подкреплением
Исследователи из Калифорнийского университета в Беркли, Стэнфордского университета и компании Databricks представили новый метод оптимизации ИИ под названием GEPA, который демонстрирует значительные улучшения по сравнению с традиционными методами обучения с подкреплением для адаптации больших языковых моделей к специализированным задачам.
GEPA отходит от традиционного подхода к обучению с помощью тысяч проб и ошибок, основанных на простых числовых оценках. Вместо этого он использует внутренние языковые возможности LLM для анализа ее работы, выявления ошибок и постепенного совершенствования инструкций. Помимо более высокой точности по сравнению с традиционными методами, GEPA гораздо эффективнее, обеспечивая превосходные результаты при сокращении числа пробных запусков в 35 раз.
Для компаний, разрабатывающих сложные ИИ-агенты и рабочие процессы, этот прорыв означает ускорение разработки, значительное снижение вычислительных затрат и более мощные и надежные приложения.
Высокая стоимость оптимизации современных систем ИИ
Современные корпоративные приложения ИИ редко полагаются на один-единственный вызов LLM. Как правило, это "составные системы ИИ" - сложные рабочие процессы, объединяющие несколько модулей LLM, внешние инструменты, такие как базы данных или интерпретаторы кода, и пользовательскую логику для выполнения сложных задач, таких как многоэтапные исследования и анализ данных.
Общей стратегией оптимизации для таких систем является обучение с подкреплением, примером которого могут служить такие методы, как групповая оптимизация относительной политики, используемая в продвинутых моделях рассуждений. Эти методы рассматривают систему ИИ как "черный ящик", оценивая задачу по базовой метрике успеха. Эта ограниченная обратная связь затем используется для постепенной корректировки параметров модели в сторону улучшения производительности.
Основным ограничением RL является его неэффективность. Для эффективного обучения на основе минимальных числовых оценок RL часто требует десятков или даже сотен тысяч пробных запусков. Для любого реального корпоративного приложения, включающего дорогостоящие инструменты или собственные модели, этот процесс непомерно медленный и дорогой.
Как объясняет Лакшья Агравал (Lakshya A Agrawal), соавтор и докторант Калифорнийского университета в Беркли, эта сложность представляет собой серьезное препятствие для многих организаций. "Для многих команд RL нецелесообразна из-за дороговизны и сложности - их подход по умолчанию в основном сводится к ручному оперативному проектированию", - отметил Агравал. GEPA предназначена для команд, работающих с высокопроизводительными моделями, которые часто не поддаются тонкой настройке, и позволяет им повысить производительность без использования специализированного оборудования".
Исследовательская группа формулирует задачу следующим образом: "Как извлечь максимальный обучающий сигнал из каждого дорогостоящего испытания, чтобы обеспечить эффективную адаптацию сложных модульных систем ИИ в условиях жестких ограничений по данным и бюджету?"
Оптимизатор, который учится с помощью языка

Фреймворк GEPA Источник: arXiv GEPA решает эту задачу, заменяя редкие сигналы вознаграждения подробной обратной связью на естественном языке. Она использует тот факт, что все действия системы искусственного интеллекта - ее шаги рассуждений, вызовы инструментов и сообщения об ошибках - могут быть представлены в виде текста, который может обрабатывать LLM. Эта методология основана на трех основных принципах.
Первый - "генетическая эволюция подсказок", когда GEPA рассматривает набор подсказок как генофонд, итеративно изменяя их для создания новых и потенциально улучшенных версий. Этот процесс мутации регулируется вторым принципом: "отражение с помощью обратной связи на естественном языке". После нескольких пробных запусков GEPA представляет LLM полную историю выполнения и результаты. Затем LLM анализирует эту информацию, чтобы диагностировать проблемы и составить более точную, усовершенствованную подсказку. Например, вместо того чтобы просто получить низкий балл за генерацию кода, он может рассмотреть ошибку компилятора и определить, что в подсказке необходимо указать конкретную версию библиотеки.
Третий принцип - "выбор по Парето", который способствует интеллектуальному поиску. Вместо того чтобы сосредоточиться на единственной подсказке с наивысшим баллом, что чревато принятием неоптимального решения, GEPA поддерживает разнообразную коллекцию специализированных подсказок. Она определяет, какие подсказки лучше всего работают в различных тестовых случаях, и составляет список ведущих кандидатов. Выбирая из этого разнообразия успешных стратегий, GEPA исследует более широкое пространство решений и с большей вероятностью обнаружит подсказку, которая будет хорошо работать при различных исходных данных.

Сосредоточение на единственном кандидате может завести модели в ловушку локальных минимумов, в то время как выборка по Парето позволяет найти больше вариантов оптимальных решений Источник: arXiv Успех всего этого процесса зависит от того, что исследователи называют "инженерией обратной связи". Агравал подчеркивает, что главное - уловить богатые текстовые данные, которые системы уже выдают, но часто игнорируют. "Обычные конвейеры обычно сжимают эту информацию в одно числовое вознаграждение, скрывая причины конкретных результатов", - объясняет он. "Основной подход GEPA заключается в структурировании обратной связи, которая раскрывает не только конечные результаты, но и промежуточные шаги и ошибки в виде обычного текста - те же данные, которые человеческий эксперт использовал бы для анализа поведения системы".
Например, для системы поиска документов это может включать в себя перечисление того, какие документы были найдены правильно, а какие пропущены, а не только сообщение об окончательной оценке точности.
GEPA на практике
Исследовательская группа оценила GEPA в четырех различных задачах, начиная с ответов на вопросы, задаваемые по нескольким каналам, и заканчивая запросами с сохранением конфиденциальности. Они тестировали модели с открытым исходным кодом и собственные модели, сравнивая GEPA с GRPO на основе RL и продвинутым оптимизатором подсказок MIPROv2.
По всем показателям GEPA значительно превзошла GRPO, добившись повышения оценки на 19 % при использовании в 35 раз меньшего количества пробных запусков. Агравал проиллюстрировал эту эффективность на конкретном примере: "Мы оптимизировали систему ответов на вопросы с помощью GEPA примерно за 3 часа по сравнению с 24 часами GRPO - восьмикратное сокращение времени разработки при 20-процентном приросте производительности", - заявил он. "Оптимизация на основе RL для того же тестового сценария стоила около 300 долларов на вычислениях на GPU, в то время как GEPA достигла лучших результатов менее чем за 20 долларов - 15-кратное сокращение затрат в наших экспериментах".
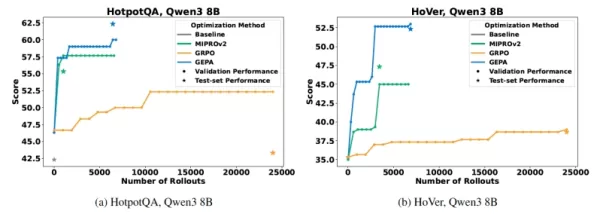
GEPA превосходит другие эталонные методы по ключевым показателям производительности Источник: arXiv Помимо сырых показателей, исследователи заметили, что оптимизированные с помощью GEPA системы более надежны при работе с новыми, невиданными данными, о чем свидетельствует меньший "разрыв обобщения". Агравал предполагает, что это повышение надежности связано с тем, что GEPA учится на более богатой обратной связи. "Меньший разрыв в обобщении GEPA, вероятно, объясняется тем, что система использует подробную обратную связь на естественном языке по каждому результату, уточняя, что удалось, что не удалось и почему, вместо того чтобы полагаться на одну цифровую оценку", - сказал он. "Это побуждает систему разрабатывать инструкции и стратегии на основе комплексного понимания успеха, а не просто запоминать шаблоны из обучающих данных". Для предприятий такая повышенная надежность означает более надежные и адаптируемые приложения ИИ в сценариях работы с клиентами.
Ключевым практическим преимуществом является то, что итоговые инструкции GEPA в 9,2 раза короче, чем подсказки, генерируемые оптимизаторами типа MIPROv2, которые часто включают множество примеров. Короткие подсказки сокращают время ожидания и снижают стоимость моделей на базе API, делая конечное приложение одновременно более быстрым и экономичным для запуска в производство.
В статье также рассматриваются перспективные применения GEPA в качестве стратегии поиска "в режиме вывода", превращающей ИИ из одношагового генератора ответов в итеративный решатель задач. Агравал описал потенциальную интеграцию в конвейер разработки компании, где GEPA может автоматически создавать и дорабатывать несколько оптимизированных версий системы, тестировать их производительность и представлять лучший вариант на рассмотрение инженеров. "Это превращает оптимизацию в непрерывный автоматизированный процесс - быстрое создание решений, которые часто соответствуют или превосходят качество ручной настройки экспертами", - добавил Агравал. В тестах на генерацию кода CUDA этот метод поднял производительность до экспертного уровня на 20 % задач, по сравнению с 0 % при одной попытке с моделью типа GPT-4o.
Авторы рассматривают GEPA как основополагающий шаг к новой парадигме в развитии ИИ. Однако, помимо содействия созданию более человекоподобного ИИ, его непосредственное влияние может заключаться в демократизации создания высокопроизводительных систем.
"Мы ожидаем, что GEPA будет способствовать позитивному сдвигу в создании систем ИИ, сделав оптимизацию доступной для конечных пользователей, которые обладают глубокими знаниями в данной области, но не имеют времени или желания осваивать сложные методы RL", - заключил Агравал. "Это расширит возможности заинтересованных сторон, обладающих точными знаниями по конкретной задаче".
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
 8 инструментов
 xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

 Комментарии (0)
Исследователи из Калифорнийского университета в Беркли, Стэнфордского университета и компании Databricks представили новый метод оптимизации ИИ под названием GEPA, который демонстрирует значительные улучшения по сравнению с традиционными методами обучения с подкреплением для адаптации больших языковых моделей к специализированным задачам.
GEPA отходит от традиционного подхода к обучению с помощью тысяч проб и ошибок, основанных на простых числовых оценках. Вместо этого он использует внутренние языковые возможности LLM для анализа ее работы, выявления ошибок и постепенного совершенствования инструкций. Помимо более высокой точности по сравнению с традиционными методами, GEPA гораздо эффективнее, обеспечивая превосходные результаты при сокращении числа пробных запусков в 35 раз.
Для компаний, разрабатывающих сложные ИИ-агенты и рабочие процессы, этот прорыв означает ускорение разработки, значительное снижение вычислительных затрат и более мощные и надежные приложения.
Высокая стоимость оптимизации современных систем ИИ
Современные корпоративные приложения ИИ редко полагаются на один-единственный вызов LLM. Как правило, это "составные системы ИИ" - сложные рабочие процессы, объединяющие несколько модулей LLM, внешние инструменты, такие как базы данных или интерпретаторы кода, и пользовательскую логику для выполнения сложных задач, таких как многоэтапные исследования и анализ данных.
Общей стратегией оптимизации для таких систем является обучение с подкреплением, примером которого могут служить такие методы, как групповая оптимизация относительной политики, используемая в продвинутых моделях рассуждений. Эти методы рассматривают систему ИИ как "черный ящик", оценивая задачу по базовой метрике успеха. Эта ограниченная обратная связь затем используется для постепенной корректировки параметров модели в сторону улучшения производительности.
Основным ограничением RL является его неэффективность. Для эффективного обучения на основе минимальных числовых оценок RL часто требует десятков или даже сотен тысяч пробных запусков. Для любого реального корпоративного приложения, включающего дорогостоящие инструменты или собственные модели, этот процесс непомерно медленный и дорогой.
Как объясняет Лакшья Агравал (Lakshya A Agrawal), соавтор и докторант Калифорнийского университета в Беркли, эта сложность представляет собой серьезное препятствие для многих организаций. "Для многих команд RL нецелесообразна из-за дороговизны и сложности - их подход по умолчанию в основном сводится к ручному оперативному проектированию", - отметил Агравал. GEPA предназначена для команд, работающих с высокопроизводительными моделями, которые часто не поддаются тонкой настройке, и позволяет им повысить производительность без использования специализированного оборудования".
Исследовательская группа формулирует задачу следующим образом: "Как извлечь максимальный обучающий сигнал из каждого дорогостоящего испытания, чтобы обеспечить эффективную адаптацию сложных модульных систем ИИ в условиях жестких ограничений по данным и бюджету?"
Оптимизатор, который учится с помощью языка
GEPA решает эту задачу, заменяя редкие сигналы вознаграждения подробной обратной связью на естественном языке. Она использует тот факт, что все действия системы искусственного интеллекта - ее шаги рассуждений, вызовы инструментов и сообщения об ошибках - могут быть представлены в виде текста, который может обрабатывать LLM. Эта методология основана на трех основных принципах.
Первый - "генетическая эволюция подсказок", когда GEPA рассматривает набор подсказок как генофонд, итеративно изменяя их для создания новых и потенциально улучшенных версий. Этот процесс мутации регулируется вторым принципом: "отражение с помощью обратной связи на естественном языке". После нескольких пробных запусков GEPA представляет LLM полную историю выполнения и результаты. Затем LLM анализирует эту информацию, чтобы диагностировать проблемы и составить более точную, усовершенствованную подсказку. Например, вместо того чтобы просто получить низкий балл за генерацию кода, он может рассмотреть ошибку компилятора и определить, что в подсказке необходимо указать конкретную версию библиотеки.
Третий принцип - "выбор по Парето", который способствует интеллектуальному поиску. Вместо того чтобы сосредоточиться на единственной подсказке с наивысшим баллом, что чревато принятием неоптимального решения, GEPA поддерживает разнообразную коллекцию специализированных подсказок. Она определяет, какие подсказки лучше всего работают в различных тестовых случаях, и составляет список ведущих кандидатов. Выбирая из этого разнообразия успешных стратегий, GEPA исследует более широкое пространство решений и с большей вероятностью обнаружит подсказку, которая будет хорошо работать при различных исходных данных.
Успех всего этого процесса зависит от того, что исследователи называют "инженерией обратной связи". Агравал подчеркивает, что главное - уловить богатые текстовые данные, которые системы уже выдают, но часто игнорируют. "Обычные конвейеры обычно сжимают эту информацию в одно числовое вознаграждение, скрывая причины конкретных результатов", - объясняет он. "Основной подход GEPA заключается в структурировании обратной связи, которая раскрывает не только конечные результаты, но и промежуточные шаги и ошибки в виде обычного текста - те же данные, которые человеческий эксперт использовал бы для анализа поведения системы".
Например, для системы поиска документов это может включать в себя перечисление того, какие документы были найдены правильно, а какие пропущены, а не только сообщение об окончательной оценке точности.
GEPA на практике
Исследовательская группа оценила GEPA в четырех различных задачах, начиная с ответов на вопросы, задаваемые по нескольким каналам, и заканчивая запросами с сохранением конфиденциальности. Они тестировали модели с открытым исходным кодом и собственные модели, сравнивая GEPA с GRPO на основе RL и продвинутым оптимизатором подсказок MIPROv2.
По всем показателям GEPA значительно превзошла GRPO, добившись повышения оценки на 19 % при использовании в 35 раз меньшего количества пробных запусков. Агравал проиллюстрировал эту эффективность на конкретном примере: "Мы оптимизировали систему ответов на вопросы с помощью GEPA примерно за 3 часа по сравнению с 24 часами GRPO - восьмикратное сокращение времени разработки при 20-процентном приросте производительности", - заявил он. "Оптимизация на основе RL для того же тестового сценария стоила около 300 долларов на вычислениях на GPU, в то время как GEPA достигла лучших результатов менее чем за 20 долларов - 15-кратное сокращение затрат в наших экспериментах".
Помимо сырых показателей, исследователи заметили, что оптимизированные с помощью GEPA системы более надежны при работе с новыми, невиданными данными, о чем свидетельствует меньший "разрыв обобщения". Агравал предполагает, что это повышение надежности связано с тем, что GEPA учится на более богатой обратной связи. "Меньший разрыв в обобщении GEPA, вероятно, объясняется тем, что система использует подробную обратную связь на естественном языке по каждому результату, уточняя, что удалось, что не удалось и почему, вместо того чтобы полагаться на одну цифровую оценку", - сказал он. "Это побуждает систему разрабатывать инструкции и стратегии на основе комплексного понимания успеха, а не просто запоминать шаблоны из обучающих данных". Для предприятий такая повышенная надежность означает более надежные и адаптируемые приложения ИИ в сценариях работы с клиентами.
Ключевым практическим преимуществом является то, что итоговые инструкции GEPA в 9,2 раза короче, чем подсказки, генерируемые оптимизаторами типа MIPROv2, которые часто включают множество примеров. Короткие подсказки сокращают время ожидания и снижают стоимость моделей на базе API, делая конечное приложение одновременно более быстрым и экономичным для запуска в производство.
В статье также рассматриваются перспективные применения GEPA в качестве стратегии поиска "в режиме вывода", превращающей ИИ из одношагового генератора ответов в итеративный решатель задач. Агравал описал потенциальную интеграцию в конвейер разработки компании, где GEPA может автоматически создавать и дорабатывать несколько оптимизированных версий системы, тестировать их производительность и представлять лучший вариант на рассмотрение инженеров. "Это превращает оптимизацию в непрерывный автоматизированный процесс - быстрое создание решений, которые часто соответствуют или превосходят качество ручной настройки экспертами", - добавил Агравал. В тестах на генерацию кода CUDA этот метод поднял производительность до экспертного уровня на 20 % задач, по сравнению с 0 % при одной попытке с моделью типа GPT-4o.
Авторы рассматривают GEPA как основополагающий шаг к новой парадигме в развитии ИИ. Однако, помимо содействия созданию более человекоподобного ИИ, его непосредственное влияние может заключаться в демократизации создания высокопроизводительных систем.
"Мы ожидаем, что GEPA будет способствовать позитивному сдвигу в создании систем ИИ, сделав оптимизацию доступной для конечных пользователей, которые обладают глубокими знаниями в данной области, но не имеют времени или желания осваивать сложные методы RL", - заключил Агравал. "Это расширит возможности заинтересованных сторон, обладающих точными знаниями по конкретной задаче".








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai












