


 Lar
O GEPA do Google aprimora o desempenho do LLM, contornando as dispendiosas necessidades de aprendizado por reforço
Pesquisadores da UC Berkeley, da Universidade de Stanford e da Databricks apresentaram um novo método de otimização de IA chamado GEPA, que demonstra melhorias notáveis em relação às técnicas tradicionais de aprendizagem por reforço para adaptar grandes modelos de linguagem a tarefas especializadas.
O GEPA se afasta da abordagem convencional de aprendizado por meio de milhares de tentativas de tentativa e erro orientadas por pontuações numéricas simples. Em vez disso, ele usa os recursos internos de linguagem de um LLM para analisar seu desempenho, identificar erros e refinar progressivamente suas instruções. Além de alcançar maior precisão do que os métodos estabelecidos, o GEPA é muito mais eficiente, oferecendo resultados superiores com até 35 vezes menos execuções de tentativas.
Para as empresas que desenvolvem fluxos de trabalho e agentes de IA complexos, esse avanço significa desenvolvimento mais rápido, custos de computação significativamente menores e aplicativos mais avançados e confiáveis.
O alto custo de otimização dos sistemas modernos de IA
Os aplicativos de IA corporativos modernos raramente dependem de uma única chamada para um LLM. Em geral, são "sistemas compostos de IA" - fluxos de trabalho sofisticados que combinam vários módulos de LLM, ferramentas externas, como bancos de dados ou interpretadores de código, e lógica personalizada para executar tarefas complexas, como pesquisa em várias etapas e análise de dados.
Uma estratégia de otimização comum para esses sistemas é o aprendizado por reforço, exemplificado por técnicas como Group Relative Policy Optimization (Otimização de Política Relativa de Grupo) usada em modelos de raciocínio avançado. Esses métodos tratam o sistema de IA como uma caixa preta, avaliando uma tarefa por meio de uma métrica básica de sucesso. Esse feedback limitado é, então, usado para ajustar gradualmente os parâmetros do modelo para melhorar o desempenho.
A principal limitação da RL é sua ineficiência. Para aprender com eficácia a partir de pontuações numéricas mínimas, a RL geralmente requer dezenas ou até centenas de milhares de execuções de teste. Para qualquer aplicativo empresarial do mundo real que envolva chamadas de ferramentas caras ou modelos proprietários, esse processo é proibitivamente lento e caro.
Conforme explicado por Lakshya A Agrawal, coautor e estudante de doutorado da Universidade da Califórnia em Berkeley, essa complexidade representa um grande obstáculo para muitas organizações. "Para muitas equipes, a RL é impraticável devido ao seu custo e complexidade - sua abordagem padrão tem sido, em grande parte, a engenharia manual de prontidão", observou Agrawal. O GEPA foi projetado para equipes que trabalham com modelos de alto desempenho que, muitas vezes, não podem ser ajustados, o que lhes permite melhorar o desempenho sem gerenciar hardware especializado.
A equipe de pesquisa apresenta o desafio da seguinte forma: "Como podemos extrair o máximo de sinal de aprendizado de cada teste dispendioso para permitir a adaptação eficaz de sistemas de IA complexos e modulares sob restrições de dados ou de orçamento?"
Um otimizador que aprende por meio da linguagem

Estrutura GEPA Fonte: arXiv O GEPA aborda esse desafio substituindo sinais de recompensa esparsos por feedback detalhado em linguagem natural. Ele aproveita o fato de que toda a execução de um sistema de IA - suas etapas de raciocínio, chamadas de ferramentas e mensagens de erro - pode ser representada como texto para um LLM processar. Essa metodologia baseia-se em três princípios fundamentais.
O primeiro é a "evolução genética de prompts", em que o GEPA trata um conjunto de prompts como um pool genético, modificando-os iterativamente para gerar versões novas e potencialmente aprimoradas. Esse processo de mutação é orientado pelo segundo princípio: "reflexão com feedback de linguagem natural". Após várias execuções de teste, o GEPA apresenta ao LLM o histórico completo de execução e os resultados. Em seguida, o LLM analisa essas informações para diagnosticar problemas e elaborar um prompt mais preciso e aprimorado. Por exemplo, em vez de apenas receber uma pontuação baixa para a geração de código, ele pode examinar um erro do compilador e determinar que o prompt deve especificar uma versão específica da biblioteca.
O terceiro princípio é a "seleção baseada em Pareto", que promove a exploração inteligente. Em vez de se concentrar apenas no prompt com a pontuação mais alta, o que pode resultar em uma solução abaixo do ideal, o GEPA mantém uma coleção diversificada de prompts especializados. Ele identifica quais prompts se destacam em diferentes casos de teste, compilando uma lista dos principais candidatos. Ao fazer uma amostragem a partir dessa variedade de estratégias bem-sucedidas, a GEPA explora um espaço de solução mais amplo e tem mais chances de descobrir um prompt com bom desempenho em diversas entradas.

O foco em um único candidato principal pode prender os modelos em mínimos locais, enquanto a seleção de Pareto explora mais opções para encontrar soluções ideais Fonte: arXiv O sucesso de todo esse processo depende do que os pesquisadores chamam de "engenharia de feedback". Agrawal enfatiza que a chave é capturar os ricos detalhes textuais que os sistemas já produzem, mas que muitas vezes são ignorados. "Os pipelines convencionais geralmente condensam essas informações em uma única recompensa numérica, ocultando os motivos por trás de resultados específicos", explicou. "A abordagem principal do GEPA é estruturar o feedback que revela não apenas os resultados finais, mas também as etapas intermediárias e os erros em texto simples - a mesma evidência que um especialista humano usaria para analisar o comportamento do sistema."
Por exemplo, para um sistema de recuperação de documentos, isso envolveria listar quais documentos foram recuperados corretamente e quais foram perdidos, em vez de apenas informar uma pontuação final de precisão.
GEPA na prática
A equipe de pesquisa avaliou o GEPA em quatro tarefas distintas, desde a resposta a perguntas em vários locais até consultas com preservação da privacidade. Eles testaram modelos proprietários e de código aberto, comparando o GEPA com o GRPO baseado em RL e o otimizador de prompt avançado MIPROv2.
Em todas as avaliações, o GEPA superou significativamente o GRPO, obtendo uma melhoria de até 19% na pontuação e usando até 35 vezes menos execuções de teste. Agrawal ilustrou essa eficiência com um exemplo específico: "Otimizamos um sistema de resposta a perguntas com o GEPA em cerca de 3 horas, em comparação com as 24 horas do GRPO - uma redução de oito vezes no tempo de desenvolvimento, aliada a um ganho de desempenho de 20%", afirmou. "A otimização baseada em RL para o mesmo cenário de teste custou cerca de US$ 300 em computação de GPU, enquanto o GEPA obteve melhores resultados por menos de US$ 20 - uma redução de custo de 15 vezes em nossos experimentos."
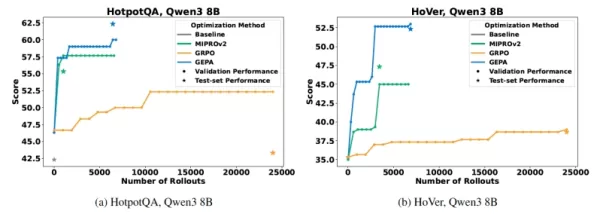
O GEPA supera outros métodos de referência nas principais medidas de desempenho Fonte: arXiv Além das métricas brutas, os pesquisadores observaram que os sistemas otimizados pelo GEPA são mais confiáveis ao lidar com dados novos e não vistos, conforme indicado por uma "lacuna de generalização" menor. Agrawal sugere que essa maior robustez decorre do fato de o GEPA aprender com um feedback mais rico. "A menor lacuna de generalização do GEPA provavelmente decorre do uso de feedback detalhado em linguagem natural sobre cada resultado - esclarecendo o que foi bem-sucedido, o que falhou e por quê - em vez de depender de uma única pontuação numérica", disse ele. "Isso incentiva o sistema a desenvolver instruções e estratégias com base em uma compreensão abrangente do sucesso, em vez de simplesmente memorizar padrões dos dados de treinamento." Para as empresas, essa confiabilidade aprimorada se traduz em aplicativos de IA mais robustos e adaptáveis em cenários voltados para o cliente.
Uma vantagem prática importante é que as instruções finais do GEPA são até 9,2 vezes mais curtas do que os prompts gerados por otimizadores como o MIPROv2, que geralmente incluem vários exemplos. Os prompts mais curtos reduzem a latência e diminuem os custos dos modelos baseados em API, tornando o aplicativo final mais rápido e mais econômico para ser executado na produção.
O documento também explora aplicações promissoras da GEPA como uma estratégia de pesquisa de "tempo de inferência", transformando uma IA de um gerador de respostas de uma única etapa em um solucionador de problemas iterativo. Agrawal descreveu uma possível integração no pipeline de desenvolvimento de uma empresa, em que a GEPA poderia criar e refinar automaticamente várias versões otimizadas de um sistema, testar seu desempenho e enviar a melhor variante para análise da engenharia. "Isso transforma a otimização em um processo contínuo e automatizado, produzindo rapidamente soluções que muitas vezes atendem ou superam a qualidade do ajuste manual especializado", acrescentou Agrawal. Em testes de geração de código CUDA, esse método elevou o desempenho a um nível de especialista em 20% das tarefas, em comparação com 0% para uma única tentativa com um modelo como o GPT-4o.
Os autores consideram o GEPA como uma etapa fundamental para um novo paradigma no desenvolvimento de IA. Entretanto, além de promover uma IA mais parecida com a humana, seu impacto mais imediato pode ser a democratização da criação de sistemas de alto desempenho.
"Prevemos que o GEPA promoverá uma mudança positiva na construção de sistemas de IA, tornando a otimização acessível aos usuários finais que possuem profundo conhecimento de domínio para a tarefa, mas podem não ter tempo ou vontade de dominar técnicas complexas de RL", concluiu Agrawal. "Ele capacita as partes interessadas que têm o conhecimento preciso e específico da tarefa."
Artigo relacionado
 Dentro dos Detalhes Revelados Sobre o Gemini de Próxima Geração: Poder de Cálculo Sobrecarregado, Equipes Internas Discordaram Sobre Prioridades de Desenvolvimento e Alocação de Recursos
Os relatórios indicam que o lançamento do tão aguardado modelo Gemini de próxima geração do Google foi adiado. Desentendimentos internos sobre prioridades de desenvolvimento e alocação de recursos, combinados com capacidade computacional limitada e p
A OpenAI descarta preocupações com a desaceleração do crescimento e afirma que múltiplas unidades de negócio estão acelerando.
Em resposta à escrutínio externo sobre o desaceleramento do crescimento das vendas e o não cumprimento de metas internas, o líder em inteligência artificial, OpenAI, emitiu uma declaração confiante na terça-feira, 28 de abril. A empresa esclareceu qu
Alibaba Super Cup: Qwen3.8-Max estreia com aprimoramento nas ferramentas de programação e escritório
A Alibaba revelou oficialmente o Qwen3.8-Max, um modelo de base de próxima geração com 2,4 trilhão de parâmetros. Este avanço significativo em IA oferece ganhos substanciais de desempenho em áreas principais, como programação e tarefas profissionais
Recomendações de tópicos especiais relacionados
Composição musical
 Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
 8 ferramentas
 xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai
Criação de quadrinhos
As melhores ferramentas de balões de diálogo com IA para a narrativa visual
As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai
Assistente de Reunião
As melhores ferramentas de resumo de reuniões com IA: acompanhe decisões e ações de acompanhamento com clareza
As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de limpeza de dados com IA: corrija valores faltantes e duplicatas rapidamente
2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai

 Comentários (0)
Pesquisadores da UC Berkeley, da Universidade de Stanford e da Databricks apresentaram um novo método de otimização de IA chamado GEPA, que demonstra melhorias notáveis em relação às técnicas tradicionais de aprendizagem por reforço para adaptar grandes modelos de linguagem a tarefas especializadas.
O GEPA se afasta da abordagem convencional de aprendizado por meio de milhares de tentativas de tentativa e erro orientadas por pontuações numéricas simples. Em vez disso, ele usa os recursos internos de linguagem de um LLM para analisar seu desempenho, identificar erros e refinar progressivamente suas instruções. Além de alcançar maior precisão do que os métodos estabelecidos, o GEPA é muito mais eficiente, oferecendo resultados superiores com até 35 vezes menos execuções de tentativas.
Para as empresas que desenvolvem fluxos de trabalho e agentes de IA complexos, esse avanço significa desenvolvimento mais rápido, custos de computação significativamente menores e aplicativos mais avançados e confiáveis.
O alto custo de otimização dos sistemas modernos de IA
Os aplicativos de IA corporativos modernos raramente dependem de uma única chamada para um LLM. Em geral, são "sistemas compostos de IA" - fluxos de trabalho sofisticados que combinam vários módulos de LLM, ferramentas externas, como bancos de dados ou interpretadores de código, e lógica personalizada para executar tarefas complexas, como pesquisa em várias etapas e análise de dados.
Uma estratégia de otimização comum para esses sistemas é o aprendizado por reforço, exemplificado por técnicas como Group Relative Policy Optimization (Otimização de Política Relativa de Grupo) usada em modelos de raciocínio avançado. Esses métodos tratam o sistema de IA como uma caixa preta, avaliando uma tarefa por meio de uma métrica básica de sucesso. Esse feedback limitado é, então, usado para ajustar gradualmente os parâmetros do modelo para melhorar o desempenho.
A principal limitação da RL é sua ineficiência. Para aprender com eficácia a partir de pontuações numéricas mínimas, a RL geralmente requer dezenas ou até centenas de milhares de execuções de teste. Para qualquer aplicativo empresarial do mundo real que envolva chamadas de ferramentas caras ou modelos proprietários, esse processo é proibitivamente lento e caro.
Conforme explicado por Lakshya A Agrawal, coautor e estudante de doutorado da Universidade da Califórnia em Berkeley, essa complexidade representa um grande obstáculo para muitas organizações. "Para muitas equipes, a RL é impraticável devido ao seu custo e complexidade - sua abordagem padrão tem sido, em grande parte, a engenharia manual de prontidão", observou Agrawal. O GEPA foi projetado para equipes que trabalham com modelos de alto desempenho que, muitas vezes, não podem ser ajustados, o que lhes permite melhorar o desempenho sem gerenciar hardware especializado.
A equipe de pesquisa apresenta o desafio da seguinte forma: "Como podemos extrair o máximo de sinal de aprendizado de cada teste dispendioso para permitir a adaptação eficaz de sistemas de IA complexos e modulares sob restrições de dados ou de orçamento?"
Um otimizador que aprende por meio da linguagem
O GEPA aborda esse desafio substituindo sinais de recompensa esparsos por feedback detalhado em linguagem natural. Ele aproveita o fato de que toda a execução de um sistema de IA - suas etapas de raciocínio, chamadas de ferramentas e mensagens de erro - pode ser representada como texto para um LLM processar. Essa metodologia baseia-se em três princípios fundamentais.
O primeiro é a "evolução genética de prompts", em que o GEPA trata um conjunto de prompts como um pool genético, modificando-os iterativamente para gerar versões novas e potencialmente aprimoradas. Esse processo de mutação é orientado pelo segundo princípio: "reflexão com feedback de linguagem natural". Após várias execuções de teste, o GEPA apresenta ao LLM o histórico completo de execução e os resultados. Em seguida, o LLM analisa essas informações para diagnosticar problemas e elaborar um prompt mais preciso e aprimorado. Por exemplo, em vez de apenas receber uma pontuação baixa para a geração de código, ele pode examinar um erro do compilador e determinar que o prompt deve especificar uma versão específica da biblioteca.
O terceiro princípio é a "seleção baseada em Pareto", que promove a exploração inteligente. Em vez de se concentrar apenas no prompt com a pontuação mais alta, o que pode resultar em uma solução abaixo do ideal, o GEPA mantém uma coleção diversificada de prompts especializados. Ele identifica quais prompts se destacam em diferentes casos de teste, compilando uma lista dos principais candidatos. Ao fazer uma amostragem a partir dessa variedade de estratégias bem-sucedidas, a GEPA explora um espaço de solução mais amplo e tem mais chances de descobrir um prompt com bom desempenho em diversas entradas.
O sucesso de todo esse processo depende do que os pesquisadores chamam de "engenharia de feedback". Agrawal enfatiza que a chave é capturar os ricos detalhes textuais que os sistemas já produzem, mas que muitas vezes são ignorados. "Os pipelines convencionais geralmente condensam essas informações em uma única recompensa numérica, ocultando os motivos por trás de resultados específicos", explicou. "A abordagem principal do GEPA é estruturar o feedback que revela não apenas os resultados finais, mas também as etapas intermediárias e os erros em texto simples - a mesma evidência que um especialista humano usaria para analisar o comportamento do sistema."
Por exemplo, para um sistema de recuperação de documentos, isso envolveria listar quais documentos foram recuperados corretamente e quais foram perdidos, em vez de apenas informar uma pontuação final de precisão.
GEPA na prática
A equipe de pesquisa avaliou o GEPA em quatro tarefas distintas, desde a resposta a perguntas em vários locais até consultas com preservação da privacidade. Eles testaram modelos proprietários e de código aberto, comparando o GEPA com o GRPO baseado em RL e o otimizador de prompt avançado MIPROv2.
Em todas as avaliações, o GEPA superou significativamente o GRPO, obtendo uma melhoria de até 19% na pontuação e usando até 35 vezes menos execuções de teste. Agrawal ilustrou essa eficiência com um exemplo específico: "Otimizamos um sistema de resposta a perguntas com o GEPA em cerca de 3 horas, em comparação com as 24 horas do GRPO - uma redução de oito vezes no tempo de desenvolvimento, aliada a um ganho de desempenho de 20%", afirmou. "A otimização baseada em RL para o mesmo cenário de teste custou cerca de US$ 300 em computação de GPU, enquanto o GEPA obteve melhores resultados por menos de US$ 20 - uma redução de custo de 15 vezes em nossos experimentos."
Além das métricas brutas, os pesquisadores observaram que os sistemas otimizados pelo GEPA são mais confiáveis ao lidar com dados novos e não vistos, conforme indicado por uma "lacuna de generalização" menor. Agrawal sugere que essa maior robustez decorre do fato de o GEPA aprender com um feedback mais rico. "A menor lacuna de generalização do GEPA provavelmente decorre do uso de feedback detalhado em linguagem natural sobre cada resultado - esclarecendo o que foi bem-sucedido, o que falhou e por quê - em vez de depender de uma única pontuação numérica", disse ele. "Isso incentiva o sistema a desenvolver instruções e estratégias com base em uma compreensão abrangente do sucesso, em vez de simplesmente memorizar padrões dos dados de treinamento." Para as empresas, essa confiabilidade aprimorada se traduz em aplicativos de IA mais robustos e adaptáveis em cenários voltados para o cliente.
Uma vantagem prática importante é que as instruções finais do GEPA são até 9,2 vezes mais curtas do que os prompts gerados por otimizadores como o MIPROv2, que geralmente incluem vários exemplos. Os prompts mais curtos reduzem a latência e diminuem os custos dos modelos baseados em API, tornando o aplicativo final mais rápido e mais econômico para ser executado na produção.
O documento também explora aplicações promissoras da GEPA como uma estratégia de pesquisa de "tempo de inferência", transformando uma IA de um gerador de respostas de uma única etapa em um solucionador de problemas iterativo. Agrawal descreveu uma possível integração no pipeline de desenvolvimento de uma empresa, em que a GEPA poderia criar e refinar automaticamente várias versões otimizadas de um sistema, testar seu desempenho e enviar a melhor variante para análise da engenharia. "Isso transforma a otimização em um processo contínuo e automatizado, produzindo rapidamente soluções que muitas vezes atendem ou superam a qualidade do ajuste manual especializado", acrescentou Agrawal. Em testes de geração de código CUDA, esse método elevou o desempenho a um nível de especialista em 20% das tarefas, em comparação com 0% para uma única tentativa com um modelo como o GPT-4o.
Os autores consideram o GEPA como uma etapa fundamental para um novo paradigma no desenvolvimento de IA. Entretanto, além de promover uma IA mais parecida com a humana, seu impacto mais imediato pode ser a democratização da criação de sistemas de alto desempenho.
"Prevemos que o GEPA promoverá uma mudança positiva na construção de sistemas de IA, tornando a otimização acessível aos usuários finais que possuem profundo conhecimento de domínio para a tarefa, mas podem não ter tempo ou vontade de dominar técnicas complexas de RL", concluiu Agrawal. "Ele capacita as partes interessadas que têm o conhecimento preciso e específico da tarefa."








 Dentro dos Detalhes Revelados Sobre o Gemini de Próxima Geração: Poder de Cálculo Sobrecarregado, Equipes Internas Discordaram Sobre Prioridades de Desenvolvimento e Alocação de Recursos
Os relatórios indicam que o lançamento do tão aguardado modelo Gemini de próxima geração do Google foi adiado. Desentendimentos internos sobre prioridades de desenvolvimento e alocação de recursos, combinados com capacidade computacional limitada e p
 A OpenAI descarta preocupações com a desaceleração do crescimento e afirma que múltiplas unidades de negócio estão acelerando.
Em resposta à escrutínio externo sobre o desaceleramento do crescimento das vendas e o não cumprimento de metas internas, o líder em inteligência artificial, OpenAI, emitiu uma declaração confiante na terça-feira, 28 de abril. A empresa esclareceu qu
 Alibaba Super Cup: Qwen3.8-Max estreia com aprimoramento nas ferramentas de programação e escritório
A Alibaba revelou oficialmente o Qwen3.8-Max, um modelo de base de próxima geração com 2,4 trilhão de parâmetros. Este avanço significativo em IA oferece ganhos substanciais de desempenho em áreas principais, como programação e tarefas profissionais

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai












