


 Дом
DeepSeek V4.1 Flash выходит с нативной мультимодальной визуализацией, превосходя профессиональную версию по мере снижения цен
Сегодня компания DeepSeek официально представила самую маленькую модель из своей новейшей серии архитектур: DeepSeek V4.1Flash. Разработанная как легковесная модель с нативным многомодальным визуальным пониманием, она направлена на обеспечение более высокой производительности, более быстрого вывода, большей пропускной способности и масштабируемости до больших размеров параметров.
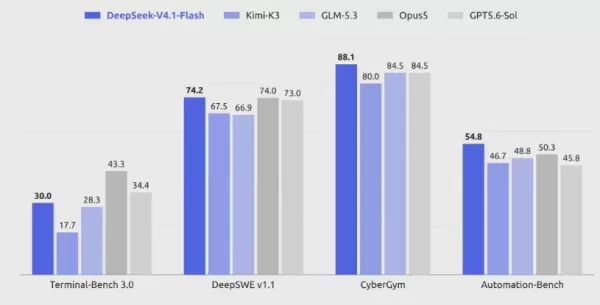
В основе DeepSeek V4.1Flash лежит архитектура Mixture of Experts (MoE) с 552B параметров, отличающаяся инновационной причинно-следственной структурой кодировщика-декодатора. Ее асимметричный дизайн приводит к тому, что входные активации составляют всего 8B, а выходные — 16B, что значительно снижает затраты по сравнению с моделями аналогичного размера. Улучшенная за счет нового подхода к предварительному обучению и крупномасштабного обучения с подкреплением, эта модель превосходит флагманские модели, такие как DeepSeek V4Pro, в различных бенчмарках.
Что касается эффективности и контроля затрат, новая модель радикально уменьшает размер KV Cache. По сравнению с ее предшественником, V4.1Flash требует лишь 1/4 высокоскоростной памяти (HBM) и 1/8 емкости твердотельного накопителя (SSD). Эта компрессия особенно полезна для сценариев использования агентов, где высоки затраты на хранение контекста и кэширование, что значительно снижает операционные расходы. Статистика показывает, что размер KV Cache сократился до 1/437 от размера исходной модели.
С выходом новой модели DeepSeek обновила свою продуктовую линейку и стратегию биллинга. DeepSeek V4.1Flash теперь доступна через API DeepSeek под именем модели deepseek-flash. Предыдущие версии, V4Flash и V4Flash Vision Exp, были прекращены, при этом старые имена (deepseek-v4-flash и deepseek-v4-flash-vision-exp) временно перенаправляются на V4.1Flash. Поскольку V4.1Flash превосходит V4Pro по производительности, стоимости, скорости и времени использования, компания планирует постепенно выводить V4Pro из эксплуатации: после 12:00 14 сентября 2026 года запросы к deepseek-v4-pro будут перенаправляться на V4.1Flash и тарифицироваться по ее ставке. Официальные партнеры, такие как WorkBuddy, CodeBuddy и OpenCode от Tencent, уже интегрировали эту модель.
Связанная статья
 Топ-1% компаний тратят 7500 долларов в месяц на сотрудника на ИИ, поскольку затраты на вычисления приближаются к расходам на персонал
Обновление от 10 июня: Свежий отчет из Индекса Ramp AI показывает, что корпоративное внедрение искусственного интеллекта в США ускоряется. Ведущие компании, отнесенные к категории «сверхактивных пользователей ИИ» (топ 1%), инвестируют до 7500 долларо
Запуск открытой платформы Aliyun Qwen: внедрение искусственного интеллекта в смартфоны, компьютеры и очки для решения задач аренды, доставки и других сценариев
По мере стремительного расширения применения искусственного интеллекта экосистема Qwen претерпела значительные улучшения. Запущенная 10 августа открытая платформа Qwen теперь предоставляет широкий доступ для мобильных телефонов, персональных компьюте
Dou Bao планирует запустить платные тарифы в середине июня, а в третьем квартале запланированы усилия по продвижению электронной коммерции.
Douyin, флагманское приложение крупной языковой модели ByteDance, планирует запустить функции платного контента к концу июня, с обновлениями, запланированными на конференции Force. Этот шаг знаменует собой важный этап в монетизации крупнейшей в Китае
Рекомендации по связанным специальным темам
дизайн
 Инструменты для создания прототипов панелей управления AI для B2B-решений типа SaaS, административных панелей и продуктов с большим объемом данных
2026 год: лучшие инструменты для создания прототипов дашбордов на основе ИИ, доступные в настоящее время для B2B-решений типа SaaS, панелей управления и продуктов с большим объемом данных! XIX.AI подготовил список самых высоко оцененных инструментов, способных кардинально изменить работу с такими системами, пройдших строгие тестирования в реальных условиях для обеспечения выдающихся результатов. Здесь вы найдете подробные сравнения бесплатных и платных версий, полные рейтинги, а также полезные рекомендации, которые помогут выбрать идеальное решение для повышения производительности и оптимизации рабочего процесса. Ознакомьтесь с предложениями прямо сейчас, чтобы получить преимущество от использования технологий ИИ!
 8 инструментов
 xix.ai
Здоровье и благополучие
Инструменты AI Sleep Insight для формирования более эффективных привычек восстановления
На сайте XIX.AI представлены лучшие инструменты 2026 года на базе ИИ для анализа сна, которые помогут вам выработать более эффективные привычки восстановления! В этом тщательно подобранном списке представлены высокооцененные и мощные решения, прошедшие реальные тесты и включенные в еженедельно обновляемый рейтинг. Здесь вы найдете сравнение бесплатных и платных версий, которое поможет вам выбрать вариант, который обязательно стоит попробовать: он повысит вашу продуктивность и поможет сформировать устойчивые привычки восстановления. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ!
7 инструментов
xix.ai
Академические исследования
Лучшие ИИ-помощники для научных исследований: ускорьте обзор литературы и отслеживание цитирований
2026 год: лучшие и наиболее высоко оцененные ИИ-помощники для оптимизации обзора литературы и отслеживания цитирований. XIX.AI предлагает мощный подбор инструментов, способных кардинально изменить ситуацию, основанный на тщательных тестах в реальных условиях и еженедельно обновляемом рейтинге. Вы найдете варианты, которые обязательно стоит попробовать: они значительно повысят вашу продуктивность и помогут быстрее преодолевать препятствия в исследовательской работе. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и раскрыть все преимущества ИИ в своей научной работе.
10 инструментов
xix.ai
Здоровье и благополучие
Лучшие приложения с ИИ для планирования питания: создавайте более продуманные режимы питания
2026: лучшие и самые популярные приложения для планирования питания на базе ИИ, которые помогут вам выработать более разумные привычки в питании. В этот тщательно подобранный список вошли мощные инструменты, прошедшие практические испытания и включенные в еженедельно обновляемый рейтинг. Здесь вы найдёте сравнение бесплатных и платных версий, которое поможет вам выбрать идеальное решение, повышающее продуктивность и позволяющее без особых усилий составлять сбалансированные меню. Познакомьтесь с ними прямо сейчас на сайте XIX.AI, чтобы раскрыть все преимущества ИИ.
12 инструментов
xix.ai
SEO
Лучшие аудиторы SEO с использованием ИИ для небольших команд: устраняйте проблемы до снижения позиций в поисковых результатах
2026 год: лучшие аудиторы SEO на основе ИИ с высокими оценками для небольших команд уже доступны на сайте XIX.AI! В нашем тщательно отобранном списке представлены мощные инструменты, которые помогут вам быстро устранять скрытые проблемы, повысить позиции сайта и сэкономить время. Получите бесплатное сравнение бесплатных и платных версий вместе с реальными тестами, чтобы выбрать оптимальный вариант для ваших нужд. Ознакомьтесь с предложениями прямо сейчас, найдите идеальный инструмент и раскройте потенциал ИИ в своей работе.
11 инструментов
xix.ai
Преобразование текста в речь
Инструменты клонирования голоса для подкастов на основе ИИ для длинных нарративов
2026 Latest Best Top-Rated AI Podcast Voice Cloning Tools for Long-Form Narration are here on XIX.AI! This curated list features powerful, game-changing solutions that deliver professional-quality audio with zero effort. We conduct real-world tests and provide a free vs paid comparison along with weekly updated rankings to help you find the must-try tool that boosts your productivity significantly. Explore now to unlock your AI edge!
10 инструментов
xix.ai

 Комментарии (0)
Сегодня компания DeepSeek официально представила самую маленькую модель из своей новейшей серии архитектур: DeepSeek V4.1Flash. Разработанная как легковесная модель с нативным многомодальным визуальным пониманием, она направлена на обеспечение более высокой производительности, более быстрого вывода, большей пропускной способности и масштабируемости до больших размеров параметров.
В основе DeepSeek V4.1Flash лежит архитектура Mixture of Experts (MoE) с 552B параметров, отличающаяся инновационной причинно-следственной структурой кодировщика-декодатора. Ее асимметричный дизайн приводит к тому, что входные активации составляют всего 8B, а выходные — 16B, что значительно снижает затраты по сравнению с моделями аналогичного размера. Улучшенная за счет нового подхода к предварительному обучению и крупномасштабного обучения с подкреплением, эта модель превосходит флагманские модели, такие как DeepSeek V4Pro, в различных бенчмарках.
Что касается эффективности и контроля затрат, новая модель радикально уменьшает размер KV Cache. По сравнению с ее предшественником, V4.1Flash требует лишь 1/4 высокоскоростной памяти (HBM) и 1/8 емкости твердотельного накопителя (SSD). Эта компрессия особенно полезна для сценариев использования агентов, где высоки затраты на хранение контекста и кэширование, что значительно снижает операционные расходы. Статистика показывает, что размер KV Cache сократился до 1/437 от размера исходной модели.
С выходом новой модели DeepSeek обновила свою продуктовую линейку и стратегию биллинга. DeepSeek V4.1Flash теперь доступна через API DeepSeek под именем модели deepseek-flash. Предыдущие версии, V4Flash и V4Flash Vision Exp, были прекращены, при этом старые имена (deepseek-v4-flash и deepseek-v4-flash-vision-exp) временно перенаправляются на V4.1Flash. Поскольку V4.1Flash превосходит V4Pro по производительности, стоимости, скорости и времени использования, компания планирует постепенно выводить V4Pro из эксплуатации: после 12:00 14 сентября 2026 года запросы к deepseek-v4-pro будут перенаправляться на V4.1Flash и тарифицироваться по ее ставке. Официальные партнеры, такие как WorkBuddy, CodeBuddy и OpenCode от Tencent, уже интегрировали эту модель.








 Топ-1% компаний тратят 7500 долларов в месяц на сотрудника на ИИ, поскольку затраты на вычисления приближаются к расходам на персонал
Обновление от 10 июня: Свежий отчет из Индекса Ramp AI показывает, что корпоративное внедрение искусственного интеллекта в США ускоряется. Ведущие компании, отнесенные к категории «сверхактивных пользователей ИИ» (топ 1%), инвестируют до 7500 долларо
 Запуск открытой платформы Aliyun Qwen: внедрение искусственного интеллекта в смартфоны, компьютеры и очки для решения задач аренды, доставки и других сценариев
По мере стремительного расширения применения искусственного интеллекта экосистема Qwen претерпела значительные улучшения. Запущенная 10 августа открытая платформа Qwen теперь предоставляет широкий доступ для мобильных телефонов, персональных компьюте
 Dou Bao планирует запустить платные тарифы в середине июня, а в третьем квартале запланированы усилия по продвижению электронной коммерции.
Douyin, флагманское приложение крупной языковой модели ByteDance, планирует запустить функции платного контента к концу июня, с обновлениями, запланированными на конференции Force. Этот шаг знаменует собой важный этап в монетизации крупнейшей в Китае
2026 год: лучшие инструменты для создания прототипов дашбордов на основе ИИ, доступные в настоящее время для B2B-решений типа SaaS, панелей управления и продуктов с большим объемом данных! XIX.AI подготовил список самых высоко оцененных инструментов, способных кардинально изменить работу с такими системами, пройдших строгие тестирования в реальных условиях для обеспечения выдающихся результатов. Здесь вы найдете подробные сравнения бесплатных и платных версий, полные рейтинги, а также полезные рекомендации, которые помогут выбрать идеальное решение для повышения производительности и оптимизации рабочего процесса. Ознакомьтесь с предложениями прямо сейчас, чтобы получить преимущество от использования технологий ИИ!
8 инструментов
xix.ai
На сайте XIX.AI представлены лучшие инструменты 2026 года на базе ИИ для анализа сна, которые помогут вам выработать более эффективные привычки восстановления! В этом тщательно подобранном списке представлены высокооцененные и мощные решения, прошедшие реальные тесты и включенные в еженедельно обновляемый рейтинг. Здесь вы найдете сравнение бесплатных и платных версий, которое поможет вам выбрать вариант, который обязательно стоит попробовать: он повысит вашу продуктивность и поможет сформировать устойчивые привычки восстановления. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ!
7 инструментов
xix.ai
2026 год: лучшие и наиболее высоко оцененные ИИ-помощники для оптимизации обзора литературы и отслеживания цитирований. XIX.AI предлагает мощный подбор инструментов, способных кардинально изменить ситуацию, основанный на тщательных тестах в реальных условиях и еженедельно обновляемом рейтинге. Вы найдете варианты, которые обязательно стоит попробовать: они значительно повысят вашу продуктивность и помогут быстрее преодолевать препятствия в исследовательской работе. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и раскрыть все преимущества ИИ в своей научной работе.
10 инструментов
xix.ai
2026: лучшие и самые популярные приложения для планирования питания на базе ИИ, которые помогут вам выработать более разумные привычки в питании. В этот тщательно подобранный список вошли мощные инструменты, прошедшие практические испытания и включенные в еженедельно обновляемый рейтинг. Здесь вы найдёте сравнение бесплатных и платных версий, которое поможет вам выбрать идеальное решение, повышающее продуктивность и позволяющее без особых усилий составлять сбалансированные меню. Познакомьтесь с ними прямо сейчас на сайте XIX.AI, чтобы раскрыть все преимущества ИИ.
12 инструментов
xix.ai
2026 год: лучшие аудиторы SEO на основе ИИ с высокими оценками для небольших команд уже доступны на сайте XIX.AI! В нашем тщательно отобранном списке представлены мощные инструменты, которые помогут вам быстро устранять скрытые проблемы, повысить позиции сайта и сэкономить время. Получите бесплатное сравнение бесплатных и платных версий вместе с реальными тестами, чтобы выбрать оптимальный вариант для ваших нужд. Ознакомьтесь с предложениями прямо сейчас, найдите идеальный инструмент и раскройте потенциал ИИ в своей работе.
11 инструментов
xix.ai
2026 Latest Best Top-Rated AI Podcast Voice Cloning Tools for Long-Form Narration are here on XIX.AI! This curated list features powerful, game-changing solutions that deliver professional-quality audio with zero effort. We conduct real-world tests and provide a free vs paid comparison along with weekly updated rankings to help you find the must-try tool that boosts your productivity significantly. Explore now to unlock your AI edge!
10 инструментов
xix.ai












