


 Hogar
DeepSeek V4.1 Flash se lanza con visión multimodal nativa, superando a la versión Pro mientras los precios caen
DeepSeek ha lanzado oficialmente hoy el modelo más pequeño de su última serie de arquitecturas: DeepSeek V4.1Flash. Diseñado como un modelo ligero con comprensión visual multimodal nativa, tiene como objetivo ofrecer un mayor rendimiento, inferencia más rápida, mayor capacidad de procesamiento y escalabilidad a tamaños de parámetros más grandes.
En su núcleo, DeepSeek V4.1Flash utiliza una arquitectura de Mezcla de Expertos (MoE) de 552B parámetros, con una innovadora estructura Causal-Encoder-Decoder. Su diseño asimétrico resulta en solo 8B de activaciones de entrada y 16B de activaciones de salida, reduciendo significativamente los costos en comparación con modelos de tamaño similar. Mejorado por un nuevo enfoque de preentrenamiento y aprendizaje por refuerzo a gran escala, este modelo supera a modelos insignia como DeepSeek V4Pro en varias pruebas de evaluación.
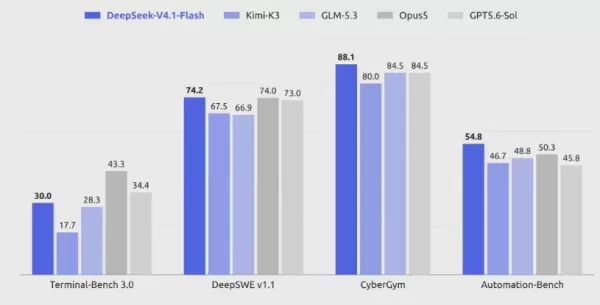
En cuanto a la eficiencia y el control de costos, el nuevo modelo reduce drásticamente el tamaño del KV Cache. En comparación con su predecesor, V4.1Flash requiere solo 1/4 de la memoria de alto ancho de banda (HBM) y 1/8 de la capacidad de la unidad de estado sólido (SSD). Esta compresión es particularmente beneficiosa para escenarios de Agentes, donde los costos de almacenamiento de contexto y aciertos en caché son altos, reduciendo significativamente los gastos operativos. Las estadísticas muestran que el KV Cache se ha reducido a 1/437 del tamaño del modelo inicial.
Con el lanzamiento del nuevo modelo, DeepSeek ha actualizado su línea de productos y estrategia de facturación. DeepSeek V4.1Flash ahora está disponible a través de la API de DeepSeek bajo el nombre de modelo deepseek-flash. Las versiones anteriores, V4Flash y V4Flash Vision Exp, han sido descontinuadas, con los nombres antiguos (deepseek-v4-flash y deepseek-v4-flash-vision-exp) redirigiendo temporalmente a V4.1Flash. Dado que V4.1Flash supera a V4Pro en rendimiento, costo, velocidad y tiempo de uso, la empresa planea eliminar gradualmente V4Pro: después de las 12:00 del 14 de septiembre de 2026, las solicitudes a deepseek-v4-pro se redirigirán a V4.1Flash y se facturarán a su tarifa. Socios oficiales como WorkBuddy, CodeBuddy y OpenCode de Tencent ya han integrado este modelo.
Artículo relacionado
 Lanzamiento de la Plataforma Abierta Qwen de Aliyun, que permite la implementación de inteligencia artificial en teléfonos, computadoras y gafas, abarcando servicios como alquiler, envíos y más
A medida que las aplicaciones de inteligencia artificial se expanden rápidamente, Qwen ha mejorado significativamente su ecosistema. Lanzado el 10 de agosto, la Plataforma Abierta de Qwen ahora proporciona un amplio acceso para teléfonos móviles, com
Dou Bao planea lanzar niveles de pago a mediados de junio, con un impulso al comercio electrónico previsto para el tercer trimestre
Douyin, la aplicación insignia de modelos grandes de ByteDance, está prevista para lanzar funciones de contenido pagado a finales de junio, con actualizaciones programadas para la conferencia Force. Este movimiento marca un hito importante en la mone
La CCTV expone una estafa de citas con IA que apunta a mujeres de mediana edad y mayores; 28 detenidos
Los informes recientes de CCTV News destacan una nueva ola de estafas de citas impulsadas por inteligencia artificial que tienen como objetivo a mujeres de mediana edad y mayores. Los delincuentes están aprovechando personalidades generadas por IA pa
Recomendaciones de temas especiales relacionados
diseño
 Herramientas de maqueta para paneles de control de IA destinadas a SaaS B2B, paneles de administración y productos con gran volumen de datos
¡Las mejores herramientas de wireframing para paneles de control de IA de 2026, ideales para SaaS B2B, paneles de administración y productos con grandes volúmenes de datos! XIX.AI ha elaborado una lista de las herramientas más destacadas y revolucionarias, seleccionadas tras rigurosas pruebas en entornos reales que garantizan resultados excepcionales. En ella encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas e información valiosa que te ayudarán a elegir la solución perfecta para aumentar tu productividad y optimizar tu flujo de trabajo. ¡Explórala ahora mismo para darle un impulso a tus capacidades con la IA!
 8 herramientas
 xix.ai
Salud y bienestar
Herramientas de análisis del sueño basadas en IA para mejorar los hábitos de recuperación
¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 basadas en IA para analizar el sueño y mejorar los hábitos de recuperación! Esta lista seleccionada incluye soluciones potentes y mejor valoradas que ofrecen pruebas en condiciones reales y clasificaciones actualizadas semanalmente. Encontrarás una comparación entre las opciones gratuitas y las de pago para ayudarte a elegir la que más te convenga, que impulse tu productividad y te ayude a desarrollar hábitos de recuperación constantes. ¡Explórala ahora para sacar el máximo partido a la IA!
7 herramientas
xix.ai
Investigación Académica
Los mejores asistentes de investigación basados en IA: agiliza la revisión bibliográfica y el seguimiento de citas
Los mejores asistentes de investigación con IA de 2026, mejor valorados para optimizar las revisiones bibliográficas y el seguimiento de citas. XIX.AI ofrece una selección revolucionaria y potente, respaldada por rigurosas pruebas en el mundo real y clasificaciones que se actualizan semanalmente. Encontrarás opciones que no te puedes perder y que aumentan significativamente la productividad, ayudándote a superar más rápidamente los obstáculos en tu investigación. Explora ahora mismo para descubrir tu herramienta perfecta y sacar el máximo partido a la IA en tu trabajo académico.
10 herramientas
xix.ai
Salud y bienestar
Las mejores aplicaciones de planificación de comidas con IA: crea rutinas nutricionales más inteligentes
Las mejores y más valoradas aplicaciones de planificación de comidas con IA de 2026 para crear rutinas nutricionales más inteligentes. Esta lista seleccionada incluye potentes herramientas que ofrecen pruebas en el mundo real y clasificaciones actualizadas semanalmente. Encontrarás una comparación entre las versiones gratuitas y las de pago que te ayudará a elegir la solución imprescindible que potencia la productividad y te permite crear comidas equilibradas sin esfuerzo. Explora ahora en XIX.AI para sacar partido a tu ventaja con la IA.
12 herramientas
xix.ai
SEO
Mejores auditores de SEO con IA para equipos pequeños: soluciona los problemas antes de que disminuyan las posiciones en los rankings
¡Los mejores auditores de SEO con inteligencia artificial más valorados de 2026 para equipos pequeños ya están disponibles en XIX.AI! Nuestra lista cuidadosamente seleccionada incluye herramientas potentes que le ayudan a solucionar rápidamente los problemas ocultos, mejorar su posición en los resultados de búsqueda y ahorrar tiempo. Obtenga una comparación gratuita con la versión de pago, además de pruebas en condiciones reales, para elegir la opción que mejor se adapte a sus necesidades. Explore ahora y descubra la herramienta perfecta para usted, así como cómo aprovechar al máximo las ventajas de la inteligencia artificial.
11 herramientas
xix.ai
Texto a voz
Herramientas de clonación de voz para podcasts con IA para narraciones de formato largo
¡Las mejores herramientas de clonación de voz para podcasts con IA mejor valoradas y de última generación de 2026 para narraciones extensas ya están disponibles en XIX.AI! Esta lista seleccionada incluye soluciones poderosas y transformadoras que ofrecen audio de calidad profesional con cero esfuerzo. Realizamos pruebas en el mundo real y proporcionamos una comparación entre versiones gratuitas y de pago, junto con clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta imprescindible que aumentará significativamente tu productividad. ¡Explora ahora para desbloquear tu ventaja con IA!
10 herramientas
xix.ai

 comentario (0)
0/500
DeepSeek ha lanzado oficialmente hoy el modelo más pequeño de su última serie de arquitecturas: DeepSeek V4.1Flash. Diseñado como un modelo ligero con comprensión visual multimodal nativa, tiene como objetivo ofrecer un mayor rendimiento, inferencia más rápida, mayor capacidad de procesamiento y escalabilidad a tamaños de parámetros más grandes.
En su núcleo, DeepSeek V4.1Flash utiliza una arquitectura de Mezcla de Expertos (MoE) de 552B parámetros, con una innovadora estructura Causal-Encoder-Decoder. Su diseño asimétrico resulta en solo 8B de activaciones de entrada y 16B de activaciones de salida, reduciendo significativamente los costos en comparación con modelos de tamaño similar. Mejorado por un nuevo enfoque de preentrenamiento y aprendizaje por refuerzo a gran escala, este modelo supera a modelos insignia como DeepSeek V4Pro en varias pruebas de evaluación.
En cuanto a la eficiencia y el control de costos, el nuevo modelo reduce drásticamente el tamaño del KV Cache. En comparación con su predecesor, V4.1Flash requiere solo 1/4 de la memoria de alto ancho de banda (HBM) y 1/8 de la capacidad de la unidad de estado sólido (SSD). Esta compresión es particularmente beneficiosa para escenarios de Agentes, donde los costos de almacenamiento de contexto y aciertos en caché son altos, reduciendo significativamente los gastos operativos. Las estadísticas muestran que el KV Cache se ha reducido a 1/437 del tamaño del modelo inicial.
Con el lanzamiento del nuevo modelo, DeepSeek ha actualizado su línea de productos y estrategia de facturación. DeepSeek V4.1Flash ahora está disponible a través de la API de DeepSeek bajo el nombre de modelo deepseek-flash. Las versiones anteriores, V4Flash y V4Flash Vision Exp, han sido descontinuadas, con los nombres antiguos (deepseek-v4-flash y deepseek-v4-flash-vision-exp) redirigiendo temporalmente a V4.1Flash. Dado que V4.1Flash supera a V4Pro en rendimiento, costo, velocidad y tiempo de uso, la empresa planea eliminar gradualmente V4Pro: después de las 12:00 del 14 de septiembre de 2026, las solicitudes a deepseek-v4-pro se redirigirán a V4.1Flash y se facturarán a su tarifa. Socios oficiales como WorkBuddy, CodeBuddy y OpenCode de Tencent ya han integrado este modelo.








 Lanzamiento de la Plataforma Abierta Qwen de Aliyun, que permite la implementación de inteligencia artificial en teléfonos, computadoras y gafas, abarcando servicios como alquiler, envíos y más
A medida que las aplicaciones de inteligencia artificial se expanden rápidamente, Qwen ha mejorado significativamente su ecosistema. Lanzado el 10 de agosto, la Plataforma Abierta de Qwen ahora proporciona un amplio acceso para teléfonos móviles, com
 Dou Bao planea lanzar niveles de pago a mediados de junio, con un impulso al comercio electrónico previsto para el tercer trimestre
Douyin, la aplicación insignia de modelos grandes de ByteDance, está prevista para lanzar funciones de contenido pagado a finales de junio, con actualizaciones programadas para la conferencia Force. Este movimiento marca un hito importante en la mone
 La CCTV expone una estafa de citas con IA que apunta a mujeres de mediana edad y mayores; 28 detenidos
Los informes recientes de CCTV News destacan una nueva ola de estafas de citas impulsadas por inteligencia artificial que tienen como objetivo a mujeres de mediana edad y mayores. Los delincuentes están aprovechando personalidades generadas por IA pa
¡Las mejores herramientas de wireframing para paneles de control de IA de 2026, ideales para SaaS B2B, paneles de administración y productos con grandes volúmenes de datos! XIX.AI ha elaborado una lista de las herramientas más destacadas y revolucionarias, seleccionadas tras rigurosas pruebas en entornos reales que garantizan resultados excepcionales. En ella encontrarás datos detallados de comparación entre versiones gratuitas y de pago, clasificaciones completas e información valiosa que te ayudarán a elegir la solución perfecta para aumentar tu productividad y optimizar tu flujo de trabajo. ¡Explórala ahora mismo para darle un impulso a tus capacidades con la IA!
8 herramientas
xix.ai
¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 basadas en IA para analizar el sueño y mejorar los hábitos de recuperación! Esta lista seleccionada incluye soluciones potentes y mejor valoradas que ofrecen pruebas en condiciones reales y clasificaciones actualizadas semanalmente. Encontrarás una comparación entre las opciones gratuitas y las de pago para ayudarte a elegir la que más te convenga, que impulse tu productividad y te ayude a desarrollar hábitos de recuperación constantes. ¡Explórala ahora para sacar el máximo partido a la IA!
7 herramientas
xix.ai
Los mejores asistentes de investigación con IA de 2026, mejor valorados para optimizar las revisiones bibliográficas y el seguimiento de citas. XIX.AI ofrece una selección revolucionaria y potente, respaldada por rigurosas pruebas en el mundo real y clasificaciones que se actualizan semanalmente. Encontrarás opciones que no te puedes perder y que aumentan significativamente la productividad, ayudándote a superar más rápidamente los obstáculos en tu investigación. Explora ahora mismo para descubrir tu herramienta perfecta y sacar el máximo partido a la IA en tu trabajo académico.
10 herramientas
xix.ai
Las mejores y más valoradas aplicaciones de planificación de comidas con IA de 2026 para crear rutinas nutricionales más inteligentes. Esta lista seleccionada incluye potentes herramientas que ofrecen pruebas en el mundo real y clasificaciones actualizadas semanalmente. Encontrarás una comparación entre las versiones gratuitas y las de pago que te ayudará a elegir la solución imprescindible que potencia la productividad y te permite crear comidas equilibradas sin esfuerzo. Explora ahora en XIX.AI para sacar partido a tu ventaja con la IA.
12 herramientas
xix.ai
¡Los mejores auditores de SEO con inteligencia artificial más valorados de 2026 para equipos pequeños ya están disponibles en XIX.AI! Nuestra lista cuidadosamente seleccionada incluye herramientas potentes que le ayudan a solucionar rápidamente los problemas ocultos, mejorar su posición en los resultados de búsqueda y ahorrar tiempo. Obtenga una comparación gratuita con la versión de pago, además de pruebas en condiciones reales, para elegir la opción que mejor se adapte a sus necesidades. Explore ahora y descubra la herramienta perfecta para usted, así como cómo aprovechar al máximo las ventajas de la inteligencia artificial.
11 herramientas
xix.ai
¡Las mejores herramientas de clonación de voz para podcasts con IA mejor valoradas y de última generación de 2026 para narraciones extensas ya están disponibles en XIX.AI! Esta lista seleccionada incluye soluciones poderosas y transformadoras que ofrecen audio de calidad profesional con cero esfuerzo. Realizamos pruebas en el mundo real y proporcionamos una comparación entre versiones gratuitas y de pago, junto con clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta imprescindible que aumentará significativamente tu productividad. ¡Explora ahora para desbloquear tu ventaja con IA!
10 herramientas
xix.ai












