


 Maison
DeepSeek V4.1 Flash est lancé avec une vision multimodale native, surpassant la version Pro alors que les prix baissent
DeepSeek a officiellement lancé aujourd’hui le modèle le plus léger de sa dernière série d’architectures : DeepSeek V4.1Flash. Conçu comme un modèle léger doté d’une compréhension visuelle multimodale native, il vise à offrir des performances supérieures, une inférence plus rapide, un débit accru et une évolutivité vers des tailles de paramètres plus importantes.
Au cœur de DeepSeek V4.1Flash se trouve une architecture Mixture of Experts (MoE) de 552 milliards de paramètres, intégrant une structure Causal-Encoder-Decoder innovante. Son design asymétrique ne génère que 8 milliards d’activations en entrée et 16 milliards en sortie, réduisant considérablement les coûts par rapport à des modèles de taille similaire. Renforcé par une nouvelle approche de pré-entraînement et un apprentissage par renforcement à grande échelle, ce modèle surpasse les modèles phares tels que DeepSeek V4Pro dans divers benchmarks.
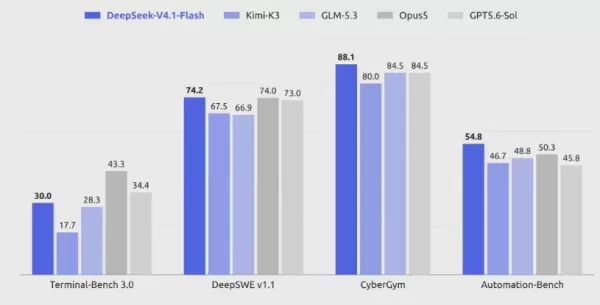
En matière d’efficacité et de maîtrise des coûts, le nouveau modèle réduit drastiquement la taille du KV Cache. Par rapport à son prédécesseur, V4.1Flash nécessite seulement 1/4 de la mémoire haute bande passante (HBM) et 1/8 de la capacité du disque à semi-conducteurs (SSD). Cette compression est particulièrement bénéfique pour les scénarios d’agents, où les coûts de stockage du contexte et de taux de hit du cache sont élevés, réduisant ainsi significativement les dépenses opérationnelles. Les statistiques montrent que le KV Cache a été réduit à 1/437 de la taille du modèle initial.
Avec le lancement de ce nouveau modèle, DeepSeek a mis à jour sa gamme de produits et sa stratégie de facturation. DeepSeek V4.1Flash est désormais disponible via l’API DeepSeek sous le nom de modèle deepseek-flash. Les versions précédentes, V4Flash et V4Flash Vision Exp, ont été abandonnées, les anciens noms (deepseek-v4-flash et deepseek-v4-flash-vision-exp) étant temporairement redirigés vers V4.1Flash. Étant donné que V4.1Flash surpasse V4Pro en termes de performances, de coût, de vitesse et de durée d’utilisation, l’entreprise prévoit de progressivement retirer V4Pro : après 12h00 le 14 septembre 2026, les requêtes adressées à deepseek-v4-pro seront redirigées vers V4.1Flash et facturées selon son tarif. Des partenaires officiels tels que WorkBuddy, CodeBuddy et OpenCode de Tencent ont déjà intégré ce modèle.
Article connexe
 Lancement de la Plateforme Ouverte Qwen d'Aliyun, permettant l'intégration de l'IA sur les téléphones, les ordinateurs et les lunettes, que ce soit pour la location, l'expédition ou d'autres usages
Alors que les applications d’IA se développent rapidement, Qwen a considérablement amélioré son écosystème. Lancée le 10 août, la Plateforme Ouverte Qwen offre désormais un accès élargi aux partenaires de l’écosystème et aux développeurs, que ce soit
Dou Bao prévoit de lancer des offres payantes à la mi-juin, avec une campagne de promotion sur le commerce électronique prévue pour le troisième trimestre
Douyin, l’application phare de ByteDance en matière de grands modèles linguistiques, prévoit de lancer des fonctionnalités de contenu payant d’ici la fin juin, avec des mises à jour annoncées lors de la conférence Force. Cette initiative marque une é
La CCTV met au jour une arnaque aux rencontres par intelligence artificielle ciblant les femmes d’âge mûr et âgées, 28 personnes arrêtées
Les derniers rapports de CCTV News mettent en lumière une nouvelle vague d’arnaques aux rencontres basées sur l’intelligence artificielle, ciblant les femmes d’âge mûr et âgées. Les criminels exploitent des profils générés par l’IA pour attirer les v
Recommandations de sujets spéciaux liés
conception
 Outils de maquettage de tableau de bord IA pour les solutions SaaS B2B, les panneaux d’administration et les produits à forte charge de données
2026 : Les meilleures outils de maquettage de tableau de bord IA disponibles, conçus pour les solutions SaaS B2B, les panneaux d’administration et les produits à forte charge de données ! XIX.AI a sélectionné une liste des outils les plus performants, ayant été soumis à des tests rigoureux dans des conditions réelles afin d’offrir des résultats exceptionnels. Vous y trouverez des données de comparaison détaillées entre les versions gratuites et payantes, des classements complets ainsi que des analyses utiles pour vous aider à choisir la solution idéale afin d’améliorer votre productivité et d’optimiser vos processus de travail. Découvrez-les dès maintenant pour tirer parti pleinement des avantages offerts par l’IA !
 8 outils
 xix.ai
Santé et bien-être
Outils d'analyse du sommeil basés sur l'IA pour de meilleures habitudes de récupération
Les meilleurs outils 2026 d'analyse du sommeil basés sur l'IA pour adopter de meilleures habitudes de récupération sont disponibles sur XIX.AI ! Cette sélection regroupe des solutions performantes et très bien notées, accompagnées de tests concrets et de classements mis à jour chaque semaine. Vous y trouverez un comparatif entre les versions gratuites et payantes pour vous aider à choisir l'option incontournable qui boostera votre productivité et vous aidera à adopter des habitudes de récupération régulières. Découvrez-la dès maintenant pour tirer parti de l'IA !
7 outils
xix.ai
Recherche académique
Les meilleurs assistants de recherche basés sur l'IA : accélérez la revue de la littérature et le suivi des citations
2026 : les meilleurs assistants de recherche IA les mieux notés pour optimiser les revues de littérature et le suivi des citations. XIX.AI propose une sélection puissante et révolutionnaire, étayée par des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des solutions incontournables qui boostent considérablement votre productivité et vous aident à surmonter plus rapidement les obstacles rencontrés dans vos recherches. Explorez dès maintenant cette sélection pour découvrir l’outil qui vous convient le mieux et tirer pleinement parti de l’IA dans vos travaux universitaires.
10 outils
xix.ai
Santé et bien-être
Les meilleures applications d'IA pour planifier ses repas : adoptez des habitudes alimentaires plus intelligentes
2026 : les meilleures applications d’IA de planification des repas les mieux notées pour adopter des habitudes alimentaires plus intelligentes. Cette sélection comprend des outils performants qui ont fait leurs preuves dans la pratique et dont le classement est mis à jour chaque semaine. Vous y trouverez un comparatif entre les versions gratuites et payantes pour vous aider à choisir la solution incontournable qui boostera votre productivité et vous permettra de créer des repas équilibrés sans effort. Découvrez-les dès maintenant sur XIX.AI pour tirer pleinement parti de l'IA.
12 outils
xix.ai
Référencement
Meilleurs auditeurs SEO IA pour les petites équipes : résolvez les problèmes avant que le classement ne décline
Les meilleurs auditeurs SEO IA hautement notés de 2026, adaptés aux petites équipes, sont disponibles sur XIX.AI ! Notre liste rigoureusement sélectionnée propose des outils puissants qui vous aident à résoudre rapidement les problèmes cachés, à améliorer votre classement et à gagner du temps. Obtenez une comparaison gratuite versus payante ainsi que des tests en conditions réelles pour choisir la solution la plus adaptée à vos besoins. Découvrez-les dès maintenant afin de trouver l’outil idéal et de tirer parti de l’avantage offert par l’IA.
11 outils
xix.ai
Synthèse vocale
Outils de clonage de voix pour podcasts IA destinés à la narration longue forme
Les derniers outils de clonage de voix pour podcasts par IA les mieux notés et les plus performants de 2026 pour les narrations longues sont disponibles sur XIX.AI ! Cette liste soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui offrent un audio de qualité professionnelle sans aucun effort. Nous réalisons des tests concrets et fournissons une comparaison entre les versions gratuite et payante, ainsi que des classements mis à jour chaque semaine, afin de vous aider à trouver l’outil incontournable qui booste considérablement votre productivité. Explorez dès maintenant pour débloquer votre avantage grâce à l’IA !
10 outils
xix.ai

 commentaires (0)
DeepSeek a officiellement lancé aujourd’hui le modèle le plus léger de sa dernière série d’architectures : DeepSeek V4.1Flash. Conçu comme un modèle léger doté d’une compréhension visuelle multimodale native, il vise à offrir des performances supérieures, une inférence plus rapide, un débit accru et une évolutivité vers des tailles de paramètres plus importantes.
Au cœur de DeepSeek V4.1Flash se trouve une architecture Mixture of Experts (MoE) de 552 milliards de paramètres, intégrant une structure Causal-Encoder-Decoder innovante. Son design asymétrique ne génère que 8 milliards d’activations en entrée et 16 milliards en sortie, réduisant considérablement les coûts par rapport à des modèles de taille similaire. Renforcé par une nouvelle approche de pré-entraînement et un apprentissage par renforcement à grande échelle, ce modèle surpasse les modèles phares tels que DeepSeek V4Pro dans divers benchmarks.
En matière d’efficacité et de maîtrise des coûts, le nouveau modèle réduit drastiquement la taille du KV Cache. Par rapport à son prédécesseur, V4.1Flash nécessite seulement 1/4 de la mémoire haute bande passante (HBM) et 1/8 de la capacité du disque à semi-conducteurs (SSD). Cette compression est particulièrement bénéfique pour les scénarios d’agents, où les coûts de stockage du contexte et de taux de hit du cache sont élevés, réduisant ainsi significativement les dépenses opérationnelles. Les statistiques montrent que le KV Cache a été réduit à 1/437 de la taille du modèle initial.
Avec le lancement de ce nouveau modèle, DeepSeek a mis à jour sa gamme de produits et sa stratégie de facturation. DeepSeek V4.1Flash est désormais disponible via l’API DeepSeek sous le nom de modèle deepseek-flash. Les versions précédentes, V4Flash et V4Flash Vision Exp, ont été abandonnées, les anciens noms (deepseek-v4-flash et deepseek-v4-flash-vision-exp) étant temporairement redirigés vers V4.1Flash. Étant donné que V4.1Flash surpasse V4Pro en termes de performances, de coût, de vitesse et de durée d’utilisation, l’entreprise prévoit de progressivement retirer V4Pro : après 12h00 le 14 septembre 2026, les requêtes adressées à deepseek-v4-pro seront redirigées vers V4.1Flash et facturées selon son tarif. Des partenaires officiels tels que WorkBuddy, CodeBuddy et OpenCode de Tencent ont déjà intégré ce modèle.








 Lancement de la Plateforme Ouverte Qwen d'Aliyun, permettant l'intégration de l'IA sur les téléphones, les ordinateurs et les lunettes, que ce soit pour la location, l'expédition ou d'autres usages
Alors que les applications d’IA se développent rapidement, Qwen a considérablement amélioré son écosystème. Lancée le 10 août, la Plateforme Ouverte Qwen offre désormais un accès élargi aux partenaires de l’écosystème et aux développeurs, que ce soit
 Dou Bao prévoit de lancer des offres payantes à la mi-juin, avec une campagne de promotion sur le commerce électronique prévue pour le troisième trimestre
Douyin, l’application phare de ByteDance en matière de grands modèles linguistiques, prévoit de lancer des fonctionnalités de contenu payant d’ici la fin juin, avec des mises à jour annoncées lors de la conférence Force. Cette initiative marque une é
 La CCTV met au jour une arnaque aux rencontres par intelligence artificielle ciblant les femmes d’âge mûr et âgées, 28 personnes arrêtées
Les derniers rapports de CCTV News mettent en lumière une nouvelle vague d’arnaques aux rencontres basées sur l’intelligence artificielle, ciblant les femmes d’âge mûr et âgées. Les criminels exploitent des profils générés par l’IA pour attirer les v
2026 : Les meilleures outils de maquettage de tableau de bord IA disponibles, conçus pour les solutions SaaS B2B, les panneaux d’administration et les produits à forte charge de données ! XIX.AI a sélectionné une liste des outils les plus performants, ayant été soumis à des tests rigoureux dans des conditions réelles afin d’offrir des résultats exceptionnels. Vous y trouverez des données de comparaison détaillées entre les versions gratuites et payantes, des classements complets ainsi que des analyses utiles pour vous aider à choisir la solution idéale afin d’améliorer votre productivité et d’optimiser vos processus de travail. Découvrez-les dès maintenant pour tirer parti pleinement des avantages offerts par l’IA !
8 outils
xix.ai
Les meilleurs outils 2026 d'analyse du sommeil basés sur l'IA pour adopter de meilleures habitudes de récupération sont disponibles sur XIX.AI ! Cette sélection regroupe des solutions performantes et très bien notées, accompagnées de tests concrets et de classements mis à jour chaque semaine. Vous y trouverez un comparatif entre les versions gratuites et payantes pour vous aider à choisir l'option incontournable qui boostera votre productivité et vous aidera à adopter des habitudes de récupération régulières. Découvrez-la dès maintenant pour tirer parti de l'IA !
7 outils
xix.ai
2026 : les meilleurs assistants de recherche IA les mieux notés pour optimiser les revues de littérature et le suivi des citations. XIX.AI propose une sélection puissante et révolutionnaire, étayée par des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des solutions incontournables qui boostent considérablement votre productivité et vous aident à surmonter plus rapidement les obstacles rencontrés dans vos recherches. Explorez dès maintenant cette sélection pour découvrir l’outil qui vous convient le mieux et tirer pleinement parti de l’IA dans vos travaux universitaires.
10 outils
xix.ai
2026 : les meilleures applications d’IA de planification des repas les mieux notées pour adopter des habitudes alimentaires plus intelligentes. Cette sélection comprend des outils performants qui ont fait leurs preuves dans la pratique et dont le classement est mis à jour chaque semaine. Vous y trouverez un comparatif entre les versions gratuites et payantes pour vous aider à choisir la solution incontournable qui boostera votre productivité et vous permettra de créer des repas équilibrés sans effort. Découvrez-les dès maintenant sur XIX.AI pour tirer pleinement parti de l'IA.
12 outils
xix.ai
Les meilleurs auditeurs SEO IA hautement notés de 2026, adaptés aux petites équipes, sont disponibles sur XIX.AI ! Notre liste rigoureusement sélectionnée propose des outils puissants qui vous aident à résoudre rapidement les problèmes cachés, à améliorer votre classement et à gagner du temps. Obtenez une comparaison gratuite versus payante ainsi que des tests en conditions réelles pour choisir la solution la plus adaptée à vos besoins. Découvrez-les dès maintenant afin de trouver l’outil idéal et de tirer parti de l’avantage offert par l’IA.
11 outils
xix.ai
Les derniers outils de clonage de voix pour podcasts par IA les mieux notés et les plus performants de 2026 pour les narrations longues sont disponibles sur XIX.AI ! Cette liste soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui offrent un audio de qualité professionnelle sans aucun effort. Nous réalisons des tests concrets et fournissons une comparaison entre les versions gratuite et payante, ainsi que des classements mis à jour chaque semaine, afin de vous aider à trouver l’outil incontournable qui booste considérablement votre productivité. Explorez dès maintenant pour débloquer votre avantage grâce à l’IA !
10 outils
xix.ai












