


 Lar
DeepSeek V4.1 Flash é lançado com visão multimodal nativa, superando a versão Pro à medida que os preços caem
O DeepSeek lançou oficialmente hoje o menor modelo de sua mais recente série de arquiteturas: o DeepSeek V4.1Flash. Projetado como um modelo leve com compreensão visual multimodal nativa, ele visa oferecer maior desempenho, inferência mais rápida, maior capacidade de processamento e escalabilidade para tamanhos de parâmetros maiores.
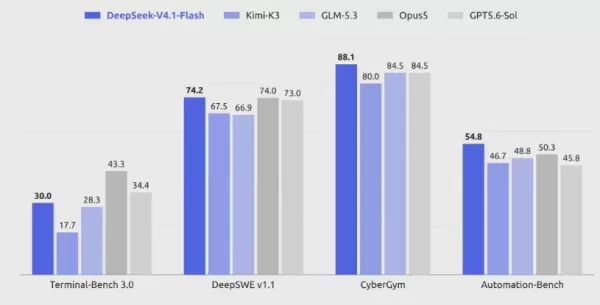
Em seu núcleo, o DeepSeek V4.1Flash utiliza uma arquitetura de Mistura de Especialistas (MoE) com 552 bilhões de parâmetros, apresentando uma estrutura inovadora de Codificador-Decodificador Causal. Seu design assimétrico resulta em apenas 8 bilhões de ativações de entrada e 16 bilhões de ativações de saída, reduzindo significativamente os custos em comparação com modelos de tamanho semelhante. Aprimorado por uma nova abordagem de pré-treinamento e aprendizado por reforço em larga escala, este modelo supera modelos de ponta como o DeepSeek V4Pro em várias avaliações.
No que diz respeito à eficiência e ao controle de custos, o novo modelo reduz drasticamente o tamanho do Cache KV. Em comparação com seu antecessor, o V4.1Flash requer apenas 1/4 da memória de alta largura de banda (HBM) e 1/8 da capacidade de unidade de estado sólido (SSD). Essa compressão é particularmente benéfica para cenários de Agentes, onde os custos de armazenamento de contexto e de acerto de cache são elevados, reduzindo significativamente as despesas operacionais. As estatísticas mostram que o Cache KV encolheu para 1/437 do tamanho do modelo inicial.
Com o lançamento do novo modelo, o DeepSeek atualizou sua linha de produtos e sua estratégia de cobrança. O DeepSeek V4.1Flash agora está disponível por meio da API do DeepSeek sob o nome de modelo deepseek-flash. As versões anteriores, V4Flash e V4Flash Vision Exp, foram descontinuadas, com os nomes antigos (deepseek-v4-flash e deepseek-v4-flash-vision-exp) sendo redirecionados temporariamente para o V4.1Flash. Como o V4.1Flash supera o V4Pro em desempenho, custo, velocidade e tempo de uso, a empresa planeja descontinuar o V4Pro: após as 12h00 de 14 de setembro de 2026, as solicitações para deepseek-v4-pro serão roteadas para o V4.1Flash e cobradas conforme sua tarifa. Parceiros oficiais como WorkBuddy, CodeBuddy e o OpenCode da Tencent já integraram este modelo.
Artigo relacionado
 As 1% das melhores empresas gastam US$ 7.500 mensais por funcionário em IA, à medida que os custos de computação se aproximam dos gastos com mão de obra
Atualização de 10 de junho: Um novo relatório do Índice Ramp AI revela que a adoção corporativa de inteligência artificial nos Estados Unidos está se acelerando. As empresas líderes, categorizadas como o topo 1% dos "usuários avançados de IA", estão
Plataforma Aberta Qwen da Alibaba Cloud é Lançada, Habilitando IA em Celulares, Computadores e Óculos em Aluguel, Envio e Muito Mais
À medida que as aplicações de IA se expandem rapidamente, o Qwen atualizou significativamente o seu ecossistema. Lançado em 10 de agosto, a Plataforma Aberta Qwen agora oferece amplo acesso para smartphones, computadores pessoais e óculos de IA a par
Dou Bao previsto para lançar planos pagos em meados de junho, com foco no comércio eletrônico planejado para o terceiro trimestre
O Douyin, principal aplicação de modelo grande da ByteDance, está prestes a lançar recursos de conteúdo pago até o final de junho, com atualizações agendadas para a conferência Force. Esta medida marca um grande marco na monetização do maior modelo g
Recomendações de tópicos especiais relacionados
projeto
 Ferramentas de wireframing para painéis de IA em soluções SaaS B2B, painéis administrativos e produtos com grande volume de dados
2026 – As melhores ferramentas de wireframing para painéis de controle de IA disponíveis atualmente, ideais para SaaS B2B, painéis administrativos e produtos com grande volume de dados! A XIX.AI compilou uma lista com as ferramentas mais bem avaliadas, capazes de transformar processos e que passam por testes rigorosos em condições reais para gerar resultados excepcionais. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e informações úteis para ajudá-lo a escolher a solução perfeita para aumentar a produtividade e otimizar seu fluxo de trabalho. Explore agora e aproveite todas as vantagens oferecidas pela inteligência artificial!
 8 ferramentas
 xix.ai
Saúde e Bem-Estar
Ferramentas de análise do sono com IA para melhores hábitos de recuperação
As melhores e mais recentes ferramentas de IA para análises do sono em 2026, que promovem melhores hábitos de recuperação, estão aqui no XIX.AI! Esta lista selecionada apresenta soluções poderosas e com as melhores avaliações, que oferecem testes práticos e rankings atualizados semanalmente. Você encontrará uma comparação entre versões gratuitas e pagas para ajudá-lo a escolher a opção imperdível que aumenta a produtividade e ajuda a criar hábitos de recuperação consistentes. Explore agora para aproveitar todas as vantagens da IA!
7 ferramentas
xix.ai
Pesquisa Acadêmica
Os melhores assistentes de pesquisa em IA: agilize a revisão da literatura e o acompanhamento de citações
2026: Os melhores e mais bem avaliados assistentes de pesquisa com IA para otimizar revisões de literatura e acompanhamento de citações. A XIX.AI seleciona uma gama poderosa e revolucionária de ferramentas, respaldada por testes rigorosos em condições reais e rankings atualizados semanalmente. Você encontrará opções imperdíveis que aumentam significativamente a produtividade, ajudando-o a superar obstáculos na pesquisa com mais rapidez. Explore agora para descobrir sua ferramenta perfeita e aproveitar toda a vantagem da IA em seus trabalhos acadêmicos.
10 ferramentas
xix.ai
Saúde e Bem-Estar
Os melhores aplicativos de planejamento alimentar com IA: crie rotinas nutricionais mais inteligentes
2026: os melhores e mais bem avaliados aplicativos de planejamento alimentar com IA para criar rotinas nutricionais mais inteligentes. Esta lista selecionada inclui ferramentas poderosas que oferecem testes práticos e rankings atualizados semanalmente. Você encontrará uma comparação entre versões gratuitas e pagas para ajudá-lo a escolher a solução imperdível que aumenta a produtividade e ajuda a criar refeições balanceadas sem esforço. Explore agora no XIX.AI para aproveitar ao máximo as vantagens da IA.
12 ferramentas
xix.ai
SEO
Melhores auditores de SEO com IA para equipes pequenas: resolva os problemas antes que a classificação decline
2026 – Os melhores auditores de SEO com IA, altamente avaliados, para equipes pequenas já estão disponíveis no XIX.AI! Nossa lista selecionada apresenta ferramentas poderosas que ajudam você a corrigir problemas ocultos rapidamente, melhorar seu posicionamento nos resultados de busca e economizar tempo. Confira uma comparação entre as opções gratuitas e as pagas, além de testes reais, para escolher a melhor solução para suas necessidades. Explore agora e encontre a ferramenta perfeita para você, aproveitando todo o potencial da inteligência artificial.
11 ferramentas
xix.ai
Conversão de texto para fala
Ferramentas de Clonagem de Voz para Podcasts de IA para Narração de Longa Duração
2026 Últimas Melhores Ferramentas de Clonagem de Voz para Podcast com IA Mais Bem Avaliadas para Narração de Longa Duração estão aqui na XIX.AI! Esta lista selecionada apresenta soluções poderosas e transformadoras que entregam áudio de qualidade profissional com zero esforço. Realizamos testes do mundo real e fornecemos uma comparação entre gratuito e pago, juntamente com classificações atualizadas semanalmente, para ajudá-lo a encontrar a ferramenta essencial que aumenta significativamente sua produtividade. Explore agora para desbloquear sua vantagem com IA!
10 ferramentas
xix.ai

 Comentários (0)
O DeepSeek lançou oficialmente hoje o menor modelo de sua mais recente série de arquiteturas: o DeepSeek V4.1Flash. Projetado como um modelo leve com compreensão visual multimodal nativa, ele visa oferecer maior desempenho, inferência mais rápida, maior capacidade de processamento e escalabilidade para tamanhos de parâmetros maiores.
Em seu núcleo, o DeepSeek V4.1Flash utiliza uma arquitetura de Mistura de Especialistas (MoE) com 552 bilhões de parâmetros, apresentando uma estrutura inovadora de Codificador-Decodificador Causal. Seu design assimétrico resulta em apenas 8 bilhões de ativações de entrada e 16 bilhões de ativações de saída, reduzindo significativamente os custos em comparação com modelos de tamanho semelhante. Aprimorado por uma nova abordagem de pré-treinamento e aprendizado por reforço em larga escala, este modelo supera modelos de ponta como o DeepSeek V4Pro em várias avaliações.
No que diz respeito à eficiência e ao controle de custos, o novo modelo reduz drasticamente o tamanho do Cache KV. Em comparação com seu antecessor, o V4.1Flash requer apenas 1/4 da memória de alta largura de banda (HBM) e 1/8 da capacidade de unidade de estado sólido (SSD). Essa compressão é particularmente benéfica para cenários de Agentes, onde os custos de armazenamento de contexto e de acerto de cache são elevados, reduzindo significativamente as despesas operacionais. As estatísticas mostram que o Cache KV encolheu para 1/437 do tamanho do modelo inicial.
Com o lançamento do novo modelo, o DeepSeek atualizou sua linha de produtos e sua estratégia de cobrança. O DeepSeek V4.1Flash agora está disponível por meio da API do DeepSeek sob o nome de modelo deepseek-flash. As versões anteriores, V4Flash e V4Flash Vision Exp, foram descontinuadas, com os nomes antigos (deepseek-v4-flash e deepseek-v4-flash-vision-exp) sendo redirecionados temporariamente para o V4.1Flash. Como o V4.1Flash supera o V4Pro em desempenho, custo, velocidade e tempo de uso, a empresa planeja descontinuar o V4Pro: após as 12h00 de 14 de setembro de 2026, as solicitações para deepseek-v4-pro serão roteadas para o V4.1Flash e cobradas conforme sua tarifa. Parceiros oficiais como WorkBuddy, CodeBuddy e o OpenCode da Tencent já integraram este modelo.








 As 1% das melhores empresas gastam US$ 7.500 mensais por funcionário em IA, à medida que os custos de computação se aproximam dos gastos com mão de obra
Atualização de 10 de junho: Um novo relatório do Índice Ramp AI revela que a adoção corporativa de inteligência artificial nos Estados Unidos está se acelerando. As empresas líderes, categorizadas como o topo 1% dos "usuários avançados de IA", estão
 Plataforma Aberta Qwen da Alibaba Cloud é Lançada, Habilitando IA em Celulares, Computadores e Óculos em Aluguel, Envio e Muito Mais
À medida que as aplicações de IA se expandem rapidamente, o Qwen atualizou significativamente o seu ecossistema. Lançado em 10 de agosto, a Plataforma Aberta Qwen agora oferece amplo acesso para smartphones, computadores pessoais e óculos de IA a par
 Dou Bao previsto para lançar planos pagos em meados de junho, com foco no comércio eletrônico planejado para o terceiro trimestre
O Douyin, principal aplicação de modelo grande da ByteDance, está prestes a lançar recursos de conteúdo pago até o final de junho, com atualizações agendadas para a conferência Force. Esta medida marca um grande marco na monetização do maior modelo g
2026 – As melhores ferramentas de wireframing para painéis de controle de IA disponíveis atualmente, ideais para SaaS B2B, painéis administrativos e produtos com grande volume de dados! A XIX.AI compilou uma lista com as ferramentas mais bem avaliadas, capazes de transformar processos e que passam por testes rigorosos em condições reais para gerar resultados excepcionais. Você encontrará dados detalhados de comparação entre versões gratuitas e pagas, classificações abrangentes e informações úteis para ajudá-lo a escolher a solução perfeita para aumentar a produtividade e otimizar seu fluxo de trabalho. Explore agora e aproveite todas as vantagens oferecidas pela inteligência artificial!
8 ferramentas
xix.ai
As melhores e mais recentes ferramentas de IA para análises do sono em 2026, que promovem melhores hábitos de recuperação, estão aqui no XIX.AI! Esta lista selecionada apresenta soluções poderosas e com as melhores avaliações, que oferecem testes práticos e rankings atualizados semanalmente. Você encontrará uma comparação entre versões gratuitas e pagas para ajudá-lo a escolher a opção imperdível que aumenta a produtividade e ajuda a criar hábitos de recuperação consistentes. Explore agora para aproveitar todas as vantagens da IA!
7 ferramentas
xix.ai
2026: Os melhores e mais bem avaliados assistentes de pesquisa com IA para otimizar revisões de literatura e acompanhamento de citações. A XIX.AI seleciona uma gama poderosa e revolucionária de ferramentas, respaldada por testes rigorosos em condições reais e rankings atualizados semanalmente. Você encontrará opções imperdíveis que aumentam significativamente a produtividade, ajudando-o a superar obstáculos na pesquisa com mais rapidez. Explore agora para descobrir sua ferramenta perfeita e aproveitar toda a vantagem da IA em seus trabalhos acadêmicos.
10 ferramentas
xix.ai
2026: os melhores e mais bem avaliados aplicativos de planejamento alimentar com IA para criar rotinas nutricionais mais inteligentes. Esta lista selecionada inclui ferramentas poderosas que oferecem testes práticos e rankings atualizados semanalmente. Você encontrará uma comparação entre versões gratuitas e pagas para ajudá-lo a escolher a solução imperdível que aumenta a produtividade e ajuda a criar refeições balanceadas sem esforço. Explore agora no XIX.AI para aproveitar ao máximo as vantagens da IA.
12 ferramentas
xix.ai
2026 – Os melhores auditores de SEO com IA, altamente avaliados, para equipes pequenas já estão disponíveis no XIX.AI! Nossa lista selecionada apresenta ferramentas poderosas que ajudam você a corrigir problemas ocultos rapidamente, melhorar seu posicionamento nos resultados de busca e economizar tempo. Confira uma comparação entre as opções gratuitas e as pagas, além de testes reais, para escolher a melhor solução para suas necessidades. Explore agora e encontre a ferramenta perfeita para você, aproveitando todo o potencial da inteligência artificial.
11 ferramentas
xix.ai
2026 Últimas Melhores Ferramentas de Clonagem de Voz para Podcast com IA Mais Bem Avaliadas para Narração de Longa Duração estão aqui na XIX.AI! Esta lista selecionada apresenta soluções poderosas e transformadoras que entregam áudio de qualidade profissional com zero esforço. Realizamos testes do mundo real e fornecemos uma comparação entre gratuito e pago, juntamente com classificações atualizadas semanalmente, para ajudá-lo a encontrar a ferramenta essencial que aumenta significativamente sua produtividade. Explore agora para desbloquear sua vantagem com IA!
10 ferramentas
xix.ai












