


 Heim
DeepSeek V4.1 Flash startet mit nativer multimodaler Bilderkennung und übertrifft die Pro-Version, während die Preise sinken
DeepSeek hat heute offiziell das kleinste Modell seiner neuesten Architekturserie gestartet: DeepSeek V4.1Flash. Als leichtgewichtiges Modell mit nativer multimodaler visueller Verständnisfähigkeit konzipiert, zielt es darauf ab, höhere Leistung, schnellere Inferenz, größeren Durchsatz und Skalierbarkeit auf größere Parametergrößen zu bieten.
Im Kern nutzt DeepSeek V4.1Flash eine Mixture-of-Experts-(MoE)-Architektur mit 552 Milliarden Parametern, die durch eine innovative kausale Encoder-Decoder-Struktur gekennzeichnet ist. Sein asymmetrisches Design führt zu nur 8 Milliarden Eingabe-Aktivierungen und 16 Milliarden Ausgabe-Aktivierungen, was die Kosten im Vergleich zu ähnlich großen Modellen erheblich senkt. Verbessert durch einen neuen Pretraining-Ansatz und großskaliges Verstärkungslernen übertrifft dieses Modell Flaggschiffmodelle wie DeepSeek V4Pro in verschiedenen Benchmarks.
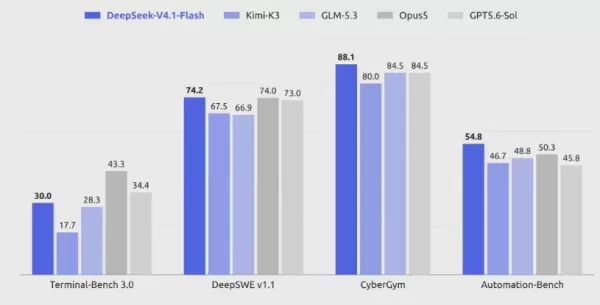
In Bezug auf Effizienz und Kostenkontrolle reduziert das neue Modell die Größe des KV-Cache drastisch. Im Vergleich zu seinem Vorgänger benötigt V4.1Flash nur 1/4 des High-Bandwidth-Speichers (HBM) und 1/8 der Festkapazität von Solid-State-Drives (SSD). Diese Komprimierung ist besonders vorteilhaft für Agent-Szenarien, in denen die Kosten für Kontextspeicherung und Cache-Treffer hoch sind, was die Betriebskosten erheblich senkt. Statistiken zeigen, dass der KV-Cache auf 1/437 der Größe des ursprünglichen Modells geschrumpft ist.
Mit der Veröffentlichung des neuen Modells hat DeepSeek seine Produktlinie und Abrechnungsstrategie aktualisiert. DeepSeek V4.1Flash ist nun über die DeepSeek-API unter dem Modellnamen deepseek-flash verfügbar. Vorherige Versionen, V4Flash und V4Flash Vision Exp, wurden eingestellt, wobei alte Namen (deepseek-v4-flash und deepseek-v4-flash-vision-exp) vorübergehend auf V4.1Flash umgeleitet werden. Da V4.1Flash V4Pro in Bezug auf Leistung, Kosten, Geschwindigkeit und Nutzungsdauer übertrifft, plant das Unternehmen, V4Pro schrittweise außer Betrieb zu setzen: Nach 12:00 Uhr am 14. September 2026 werden Anfragen an deepseek-v4-pro auf V4.1Flash umgeleitet und nach dessen Tarif abgerechnet. Offizielle Partner wie WorkBuddy, CodeBuddy und Tencent's OpenCode haben dieses Modell bereits integriert.
Verwandter Artikel
 Einführung der Aliyun Qwen Open Platform: KI auf Smartphones, PCs und Brillen – vom Leihen über den Versand bis hin zu weiteren Anwendungen
Da sich KI-Anwendungen rasch ausweiten, hat Qwen seinen Ökosystembereich erheblich ausgebaut. Die am 10. August gestartete Qwen Open Platform bietet nun mobilen Geräten, PCs und KI-Brillen einen breiten Zugang für Ökosystempartner und Entwickler.In
Dou Bao plant, die kostenpflichtigen Stufen Mitte Juni einzuführen; für das dritte Quartal ist ein E-Commerce-Push geplant.
Douyin, die Flaggschiff-Anwendung des großen Modells von ByteDance, wird bis Ende Juni kostenpflichtige Inhaltsfunktionen einführen, wobei Updates für die Force-Konferenz geplant sind. Dieser Schritt markiert einen wichtigen Meilenstein bei der Monet
CCTV deckt KI-Dating-Betrug auf, der sich an mittlere und ältere Frauen richtet, 28 Festnahmen
Aktuelle Berichte von CCTV News heben eine neue Welle von KI-gesteuerten Dating-Betrugsfällen hervor, die sich an mittlere und ältere Frauen richten. Kriminelle nutzen KI-generierte Personas, um Opfer in finanzielle Betrugshandlungen zu locken. Die B
Empfehlungen zu verwandten Spezialthemen
Design
 Wireframing-Tools für AI-Dashboards in B2B-SaaS-Lösungen, Admin-Panels sowie datenintensiven Produkten
2026 – Die neuesten und besten Tools für das Wireframing von AI-Dashboards für B2B-SaaS-Lösungen, Admin-Panels sowie datenintensive Produkte! XIX.AI hat eine Liste der am besten bewerteten, leistungsstarken Tools zusammengestellt, die strenge Prüfungen im echten Einsatz durchlaufen haben, um hervorragende Ergebnisse zu liefern. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Versionen, umfassende Ranglisten sowie wertvolle Erkenntnisse, die Ihnen dabei helfen, die ideale Lösung zu wählen, um Ihre Produktivität zu steigern und Ihren Arbeitsablauf zu optimieren. Entdecken Sie sie jetzt, um Ihren Wettbewerbsvorteil durch KI zu erlangen!
 8 Tools
 xix.ai
Gesundheit Wellness
KI-basierte Tools zur Schlafanalyse für bessere Erholungsgewohnheiten
Die besten KI-Tools für Schlafanalysen aus dem Jahr 2026 für bessere Erholungsgewohnheiten finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält erstklassige, leistungsstarke Lösungen, die Praxistests und wöchentlich aktualisierte Ranglisten bieten. Sie finden hier einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die Option auszuwählen, die Sie unbedingt ausprobieren sollten, um Ihre Produktivität zu steigern und beständige Erholungsgewohnheiten aufzubauen. Entdecken Sie die Liste jetzt und nutzen Sie Ihren KI-Vorteil!
7 Tools
xix.ai
Akademische Forschung
Die besten KI-Forschungsassistenten: Beschleunigen Sie die Literaturrecherche und die Zitierverfolgung
Die besten und am besten bewerteten KI-Forschungsassistenten des Jahres 2026 zur Optimierung von Literaturrecherchen und Zitierverfolgung. XIX.AI stellt eine leistungsstarke, bahnbrechende Auswahl zusammen, die auf strengen Praxistests und wöchentlich aktualisierten Rankings basiert. Hier finden Sie Optionen, die Sie unbedingt ausprobieren sollten, da sie Ihre Produktivität erheblich steigern und Ihnen helfen, Forschungsengpässe schneller zu überwinden. Entdecken Sie jetzt das für Sie perfekte Tool und nutzen Sie den KI-Vorteil in Ihrer akademischen Arbeit.
10 Tools
xix.ai
Gesundheit Wellness
Die besten KI-Apps zur Essensplanung: Entwickeln Sie intelligentere Ernährungsgewohnheiten
2026: Die neuesten, besten und am besten bewerteten KI-Apps zur Mahlzeitenplanung für intelligentere Ernährungsgewohnheiten. Diese sorgfältig zusammengestellte Liste enthält leistungsstarke Tools, die auf Praxistests basieren und wöchentlich aktualisierte Rankings bieten. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die Lösung zu finden, die Sie unbedingt ausprobieren sollten – eine Lösung, die Ihre Produktivität steigert und Ihnen dabei hilft, mühelos ausgewogene Mahlzeiten zuzubereiten. Entdecken Sie jetzt auf XIX.AI, wie Sie Ihren KI-Vorteil nutzen können.
12 Tools
xix.ai
SEO
Die besten AI-basierten SEO-Auditer für kleine Teams: Beheben Sie Probleme, bevor die Rankings nachlassen
2026 – Die besten, am höchsten bewerteten AI-SEO-Auditor-Tools für kleine Teams sind jetzt auf XIX.AI verfügbar! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke Werkzeuge, die Ihnen dabei helfen, versteckte Probleme schnell zu beheben, Ihre Rankings zu verbessern und Zeit zu sparen. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante sowie Ergebnisse aus praktischen Tests, um die beste Lösung für Ihre Bedürfnisse auszuwählen. Entdecken Sie jetzt das perfekte Tool für Sie und sichern Sie sich einen Wettbewerbsvorteil durch KI.
11 Tools
xix.ai
Text-zu-Sprache
AI-Podcast-Stimmenklonungstools für langformatige Erzählungen
2026 Neueste Besten Top-Bewerteten KI-Podcast-Stimmklonungstools für Langform-Erzählungen sind hier auf XIX.AI! Diese kuratierte Liste enthält leistungsstarke, bahnbrechende Lösungen, die Audio in professioneller Qualität mit minimalem Aufwand liefern. Wir führen praxisnahe Tests durch und bieten einen kostenlosen versus kostenpflichtigen Vergleich sowie wöchentlich aktualisierte Rankings, um Ihnen zu helfen, das unbedingt auszuprobierende Tool zu finden, das Ihre Produktivität erheblich steigert. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten!
10 Tools
xix.ai

 Kommentare (0)
DeepSeek hat heute offiziell das kleinste Modell seiner neuesten Architekturserie gestartet: DeepSeek V4.1Flash. Als leichtgewichtiges Modell mit nativer multimodaler visueller Verständnisfähigkeit konzipiert, zielt es darauf ab, höhere Leistung, schnellere Inferenz, größeren Durchsatz und Skalierbarkeit auf größere Parametergrößen zu bieten.
Im Kern nutzt DeepSeek V4.1Flash eine Mixture-of-Experts-(MoE)-Architektur mit 552 Milliarden Parametern, die durch eine innovative kausale Encoder-Decoder-Struktur gekennzeichnet ist. Sein asymmetrisches Design führt zu nur 8 Milliarden Eingabe-Aktivierungen und 16 Milliarden Ausgabe-Aktivierungen, was die Kosten im Vergleich zu ähnlich großen Modellen erheblich senkt. Verbessert durch einen neuen Pretraining-Ansatz und großskaliges Verstärkungslernen übertrifft dieses Modell Flaggschiffmodelle wie DeepSeek V4Pro in verschiedenen Benchmarks.
In Bezug auf Effizienz und Kostenkontrolle reduziert das neue Modell die Größe des KV-Cache drastisch. Im Vergleich zu seinem Vorgänger benötigt V4.1Flash nur 1/4 des High-Bandwidth-Speichers (HBM) und 1/8 der Festkapazität von Solid-State-Drives (SSD). Diese Komprimierung ist besonders vorteilhaft für Agent-Szenarien, in denen die Kosten für Kontextspeicherung und Cache-Treffer hoch sind, was die Betriebskosten erheblich senkt. Statistiken zeigen, dass der KV-Cache auf 1/437 der Größe des ursprünglichen Modells geschrumpft ist.
Mit der Veröffentlichung des neuen Modells hat DeepSeek seine Produktlinie und Abrechnungsstrategie aktualisiert. DeepSeek V4.1Flash ist nun über die DeepSeek-API unter dem Modellnamen deepseek-flash verfügbar. Vorherige Versionen, V4Flash und V4Flash Vision Exp, wurden eingestellt, wobei alte Namen (deepseek-v4-flash und deepseek-v4-flash-vision-exp) vorübergehend auf V4.1Flash umgeleitet werden. Da V4.1Flash V4Pro in Bezug auf Leistung, Kosten, Geschwindigkeit und Nutzungsdauer übertrifft, plant das Unternehmen, V4Pro schrittweise außer Betrieb zu setzen: Nach 12:00 Uhr am 14. September 2026 werden Anfragen an deepseek-v4-pro auf V4.1Flash umgeleitet und nach dessen Tarif abgerechnet. Offizielle Partner wie WorkBuddy, CodeBuddy und Tencent's OpenCode haben dieses Modell bereits integriert.








 Einführung der Aliyun Qwen Open Platform: KI auf Smartphones, PCs und Brillen – vom Leihen über den Versand bis hin zu weiteren Anwendungen
Da sich KI-Anwendungen rasch ausweiten, hat Qwen seinen Ökosystembereich erheblich ausgebaut. Die am 10. August gestartete Qwen Open Platform bietet nun mobilen Geräten, PCs und KI-Brillen einen breiten Zugang für Ökosystempartner und Entwickler.In
 Dou Bao plant, die kostenpflichtigen Stufen Mitte Juni einzuführen; für das dritte Quartal ist ein E-Commerce-Push geplant.
Douyin, die Flaggschiff-Anwendung des großen Modells von ByteDance, wird bis Ende Juni kostenpflichtige Inhaltsfunktionen einführen, wobei Updates für die Force-Konferenz geplant sind. Dieser Schritt markiert einen wichtigen Meilenstein bei der Monet
 CCTV deckt KI-Dating-Betrug auf, der sich an mittlere und ältere Frauen richtet, 28 Festnahmen
Aktuelle Berichte von CCTV News heben eine neue Welle von KI-gesteuerten Dating-Betrugsfällen hervor, die sich an mittlere und ältere Frauen richten. Kriminelle nutzen KI-generierte Personas, um Opfer in finanzielle Betrugshandlungen zu locken. Die B
2026 – Die neuesten und besten Tools für das Wireframing von AI-Dashboards für B2B-SaaS-Lösungen, Admin-Panels sowie datenintensive Produkte! XIX.AI hat eine Liste der am besten bewerteten, leistungsstarken Tools zusammengestellt, die strenge Prüfungen im echten Einsatz durchlaufen haben, um hervorragende Ergebnisse zu liefern. Sie finden detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Versionen, umfassende Ranglisten sowie wertvolle Erkenntnisse, die Ihnen dabei helfen, die ideale Lösung zu wählen, um Ihre Produktivität zu steigern und Ihren Arbeitsablauf zu optimieren. Entdecken Sie sie jetzt, um Ihren Wettbewerbsvorteil durch KI zu erlangen!
8 Tools
xix.ai
Die besten KI-Tools für Schlafanalysen aus dem Jahr 2026 für bessere Erholungsgewohnheiten finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält erstklassige, leistungsstarke Lösungen, die Praxistests und wöchentlich aktualisierte Ranglisten bieten. Sie finden hier einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die Option auszuwählen, die Sie unbedingt ausprobieren sollten, um Ihre Produktivität zu steigern und beständige Erholungsgewohnheiten aufzubauen. Entdecken Sie die Liste jetzt und nutzen Sie Ihren KI-Vorteil!
7 Tools
xix.ai
Die besten und am besten bewerteten KI-Forschungsassistenten des Jahres 2026 zur Optimierung von Literaturrecherchen und Zitierverfolgung. XIX.AI stellt eine leistungsstarke, bahnbrechende Auswahl zusammen, die auf strengen Praxistests und wöchentlich aktualisierten Rankings basiert. Hier finden Sie Optionen, die Sie unbedingt ausprobieren sollten, da sie Ihre Produktivität erheblich steigern und Ihnen helfen, Forschungsengpässe schneller zu überwinden. Entdecken Sie jetzt das für Sie perfekte Tool und nutzen Sie den KI-Vorteil in Ihrer akademischen Arbeit.
10 Tools
xix.ai
2026: Die neuesten, besten und am besten bewerteten KI-Apps zur Mahlzeitenplanung für intelligentere Ernährungsgewohnheiten. Diese sorgfältig zusammengestellte Liste enthält leistungsstarke Tools, die auf Praxistests basieren und wöchentlich aktualisierte Rankings bieten. Hier finden Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen dabei hilft, die Lösung zu finden, die Sie unbedingt ausprobieren sollten – eine Lösung, die Ihre Produktivität steigert und Ihnen dabei hilft, mühelos ausgewogene Mahlzeiten zuzubereiten. Entdecken Sie jetzt auf XIX.AI, wie Sie Ihren KI-Vorteil nutzen können.
12 Tools
xix.ai
2026 – Die besten, am höchsten bewerteten AI-SEO-Auditor-Tools für kleine Teams sind jetzt auf XIX.AI verfügbar! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke Werkzeuge, die Ihnen dabei helfen, versteckte Probleme schnell zu beheben, Ihre Rankings zu verbessern und Zeit zu sparen. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante sowie Ergebnisse aus praktischen Tests, um die beste Lösung für Ihre Bedürfnisse auszuwählen. Entdecken Sie jetzt das perfekte Tool für Sie und sichern Sie sich einen Wettbewerbsvorteil durch KI.
11 Tools
xix.ai
2026 Neueste Besten Top-Bewerteten KI-Podcast-Stimmklonungstools für Langform-Erzählungen sind hier auf XIX.AI! Diese kuratierte Liste enthält leistungsstarke, bahnbrechende Lösungen, die Audio in professioneller Qualität mit minimalem Aufwand liefern. Wir führen praxisnahe Tests durch und bieten einen kostenlosen versus kostenpflichtigen Vergleich sowie wöchentlich aktualisierte Rankings, um Ihnen zu helfen, das unbedingt auszuprobierende Tool zu finden, das Ihre Produktivität erheblich steigert. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten!
10 Tools
xix.ai












