


 Дом
Подразделение Tongyi компании Alibaba представило Fun-CineForge: модель искусственного интеллекта с открытым исходным кодом, обеспечивающая синтез речи кинематографического качества
16 марта лаборатория Alibaba Tongyi Lab официально представила и открыла исходный код мультимодальной модели Fun-CineForge для синтеза голоса киноуровня, предназначенной для различных сценариев. Эта модель решает основные проблемы в области дубляжа с помощью ИИ, включая несоответствие синхронизации губ, недостаток эмоциональной выразительности и несогласованность голосовых характеристик у разных персонажей. Кроме того, в ней представлен высококачественный метод построения наборов данных.
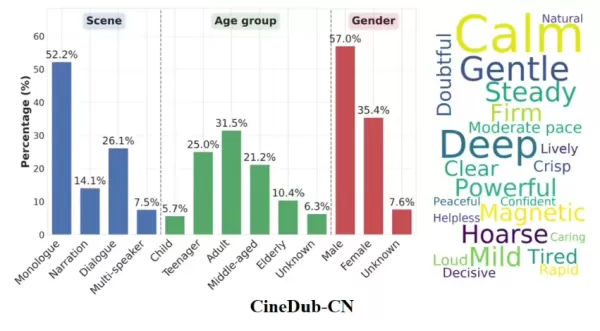
С технической точки зрения Fun-CineForge является пионером концепции «временной модальности». В отличие от традиционных моделей, которые сосредоточены исключительно на тексте или визуальных элементах, она обеспечивает синтез голоса в точных временных интервалах благодаря точному управлению временными метками. Даже в сложных сценах фильмов с закрытыми персонажами, частыми переключениями камеры или размытыми лицами модель сохраняет высокую степень аудиовизуальной синхронизации и соблюдения инструкций.
Еще одним ключевым нововведением является сопутствующий конвейер построения набора данных CineDub с открытым исходным кодом. Tongyi Lab использовала цепочку рассуждений на основе крупных языковых моделей для автоматического преобразования необработанных видеоматериалов в структурированные данные, что значительно сократило необходимость в ручной аннотации. Этот процесс обеспечивает уровень ошибок по словам примерно 1% и уровень ошибок диаризации говорящих всего 1,20%, создавая высококонкурентную основу для обучения крупных моделей.
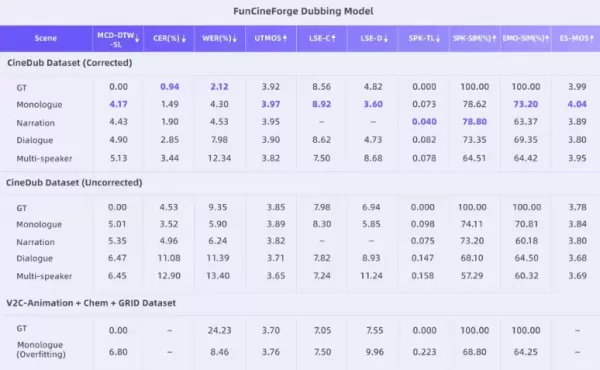
Fun-CineForge теперь доступен на GitHub, HuggingFace и в сообществе ModelScope, поддерживая инференцию для видеороликов длиной до 30 секунд. Он превосходен не только в монологах одного говорящего, но и предлагает профессиональную поддержку для сценариев диалогов в дуэте и с участием нескольких говорящих. Этот прорыв сигнализирует об эволюции технологии голосового ИИ от базовых ролей в обслуживании клиентов и в качестве помощников к высококачественной анимации и постпродакшну фильмов.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
Создание видео
 Генераторы привлекательных заглавий для коротких видеороликов с использованием ИИ: для Reels, Shorts и кампаний по запуску продуктов
2026: лучшие современные генераторы захватывающих заставок для короткометражных видео на базе ИИ для Reels, Shorts и кампаний по запуску продуктов! XIX.AI подбирает самые высокооцененные и мощные инструменты, способные кардинально изменить ситуацию, которые в ходе реальных тестов демонстрируют результаты, которые обязательно стоит попробовать. Эта страница, обновляемая еженедельно, предлагает сравнительные рейтинги бесплатных и платных инструментов, чтобы помочь вам найти идеальное решение для повышения креативности и продуктивности при создании контента. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ!
 11 инструментов
 xix.ai
письмо
Инструменты для создания плана статей с использованием ИИ при написании длинных текстов
2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai
чат-бот
Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

 Комментарии (1)
![NicholasThomas]()
Just tried the demo and honestly blown away by how natural the lip-sync feels now! 😮 Always thought AI dubbing sounded a bit robotic, but this seems like a huge leap. Wonder if this will start being used in indie films or even gaming soon? The open-source move is pretty bold too—curious to see how other companies respond.
16 марта лаборатория Alibaba Tongyi Lab официально представила и открыла исходный код мультимодальной модели Fun-CineForge для синтеза голоса киноуровня, предназначенной для различных сценариев. Эта модель решает основные проблемы в области дубляжа с помощью ИИ, включая несоответствие синхронизации губ, недостаток эмоциональной выразительности и несогласованность голосовых характеристик у разных персонажей. Кроме того, в ней представлен высококачественный метод построения наборов данных.
С технической точки зрения Fun-CineForge является пионером концепции «временной модальности». В отличие от традиционных моделей, которые сосредоточены исключительно на тексте или визуальных элементах, она обеспечивает синтез голоса в точных временных интервалах благодаря точному управлению временными метками. Даже в сложных сценах фильмов с закрытыми персонажами, частыми переключениями камеры или размытыми лицами модель сохраняет высокую степень аудиовизуальной синхронизации и соблюдения инструкций.
Еще одним ключевым нововведением является сопутствующий конвейер построения набора данных CineDub с открытым исходным кодом. Tongyi Lab использовала цепочку рассуждений на основе крупных языковых моделей для автоматического преобразования необработанных видеоматериалов в структурированные данные, что значительно сократило необходимость в ручной аннотации. Этот процесс обеспечивает уровень ошибок по словам примерно 1% и уровень ошибок диаризации говорящих всего 1,20%, создавая высококонкурентную основу для обучения крупных моделей.
Fun-CineForge теперь доступен на GitHub, HuggingFace и в сообществе ModelScope, поддерживая инференцию для видеороликов длиной до 30 секунд. Он превосходен не только в монологах одного говорящего, но и предлагает профессиональную поддержку для сценариев диалогов в дуэте и с участием нескольких говорящих. Этот прорыв сигнализирует об эволюции технологии голосового ИИ от базовых ролей в обслуживании клиентов и в качестве помощников к высококачественной анимации и постпродакшну фильмов.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026: лучшие современные генераторы захватывающих заставок для короткометражных видео на базе ИИ для Reels, Shorts и кампаний по запуску продуктов! XIX.AI подбирает самые высокооцененные и мощные инструменты, способные кардинально изменить ситуацию, которые в ходе реальных тестов демонстрируют результаты, которые обязательно стоит попробовать. Эта страница, обновляемая еженедельно, предлагает сравнительные рейтинги бесплатных и платных инструментов, чтобы помочь вам найти идеальное решение для повышения креативности и продуктивности при создании контента. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ!
11 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

Just tried the demo and honestly blown away by how natural the lip-sync feels now! 😮 Always thought AI dubbing sounded a bit robotic, but this seems like a huge leap. Wonder if this will start being used in indie films or even gaming soon? The open-source move is pretty bold too—curious to see how other companies respond.












