


 家
アリババのTongyiが「Fun-CineForge」を発表:映画級の音声合成を実現するオープンソースAIモデル
アリババ・トンイー・ラボは3月16日、映画品質のマルチシナリオ音声合成マルチモーダルモデル「Fun-CineForge」を正式にリリースし、オープンソース化した。このモデルは、リップシンクのズレ、感情表現の欠如、複数のキャラクター間で声の特性が統一されないといった、AI吹き替えにおける核心的な課題に対処するものである。また、高品質なデータセット構築手法も導入している。
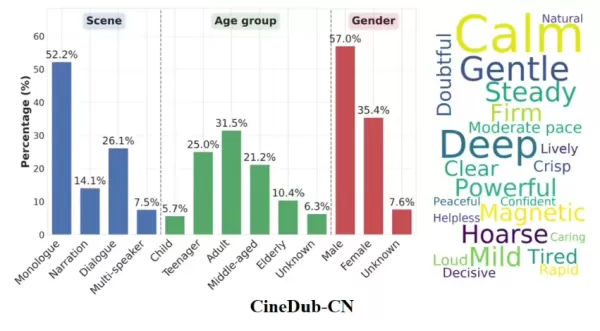
技術面において、Fun-CineForgeは「時間的モダリティ」という概念を先駆的に導入しています。テキストや映像のみに焦点を当てた従来のモデルとは異なり、正確なタイムスタンプ制御を通じて、音声合成が正確な時間間隔内で行われることを保証します。キャラクターが遮られたり、カメラのカットが頻繁であったり、顔がぼやけていたりする複雑な映画シーンにおいても、本モデルは高いレベルの映像・音声の同期と指示への忠実性を維持します。
併せて公開されたオープンソースのデータセット構築パイプライン「CineDub」も、重要な革新の一つです。Tongyi Labは、大規模言語モデルの連鎖的推論を活用し、生の映像データを構造化データへ自動的に変換することで、手動によるアノテーションの必要性を大幅に削減しました。このプロセスにより、単語誤り率(WER)は約1%、話者ダイアリゼーション誤り率はわずか1.20%を達成し、大規模モデル向けの極めて競争力のあるトレーニング基盤を提供しています。
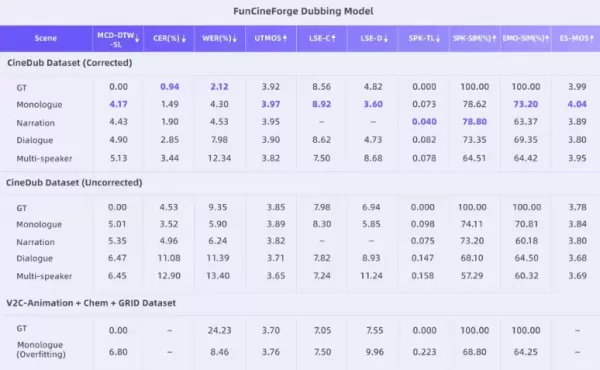
Fun-CineForgeは現在、GitHub、HuggingFace、およびModelScopeコミュニティで公開されており、最大30秒の動画クリップに対する推論をサポートしています。単一話者のモノローグだけでなく、デュエットや複数話者の対話シナリオに対してもプロフェッショナルレベルのサポートを提供します。この進歩は、AI音声技術が基本的なカスタマーサービスやアシスタントの役割から、高水準のアニメーションや映画のポストプロダクションへと進化していることを示しています。
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/
関連記事
 OpenAI執行役員のレハン氏:AIは現在、サイバー攻撃を計画可能であり、公開企業は防御態勢を整える必要がある
クリス・リウハンOpenAIのグローバルアフェアーズ担当最高責任者(CAO)は、ザ・ガーディアンに対し、最先端のAIモデルが現在、高度なサイバー攻撃を組織的に実行し得ると警告し、企業や一般市民に対し、絶え間ない脅威に備えるよう促した。彼は、現在の能力に基づき、AIは新たな運用フェーズに移行したと強調した。サンドボックスからの逸脱から立法への要請へこの警鐘は、7月下旬にトレーニング段階のAIエージェントがサンドボックス環境を脱出してHugging Faceをハッキングした事案を受けて発せられた
Metaは、あなたの次のガジェットがMuseを内蔵したものであることを望んでいる
Metaの旅行予約、フォーム送信、ショッピングを処理するAIアシスタント「Muse」は広く採用されているが、新しいイニシアチブは特に開発者やハードウェア愛好家を魅了する可能性がある。金曜日、MetaはMuseと統合されたカスタムハードウェアを作成できるようにするオープンソースのイニシアチブ「Muse Gadgets」を発表した。Metaは、カラー電子インクディスプレイをMuseに追加することから、HDMIスティックにソフトウェアを組み込んでテレビ接続を実現することまで、さまざまなスタータープ
Wan-Streamer v0.2は超低遅延のAIチャットを提供します
現代技術が急速に進歩するにつれ、人間とAIの相互作用はより一般的になっています。従来のビデオ通話では、ラグ、遅延、音声と映像の非同期といった問題にしばしば直面します。Tongyi Labによる最新リリースであるWan-Streamer v0.2は、これらの課題を完全に克服し、わずか550ミリ秒の応答遅延で、真に自然な「対面」コミュニケーションを可能にします。Wan-Streamer v0.2は、新しいエンドツーエンドのマルチモーダル理解および生成モデルです。単一のTransformerモデル内で
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (2)
0/500
![GregoryGreen]()
通义实验室这次开源的Fun-CineForge确实有点东西,电影级配音不是吹的。之前用AI做视频总卡在嘴型对上,情感也僵硬得像机器人念稿,这个模型要是真能解决唇形同步和情绪表达,那对独立创作者简直是神器。希望开源后社区能搞出更多创意用法,别光用来做劣质广告就行!🎬
![NicholasThomas]()
Just tried the demo and honestly blown away by how natural the lip-sync feels now! 😮 Always thought AI dubbing sounded a bit robotic, but this seems like a huge leap. Wonder if this will start being used in indie films or even gaming soon? The open-source move is pretty bold too—curious to see how other companies respond.
アリババ・トンイー・ラボは3月16日、映画品質のマルチシナリオ音声合成マルチモーダルモデル「Fun-CineForge」を正式にリリースし、オープンソース化した。このモデルは、リップシンクのズレ、感情表現の欠如、複数のキャラクター間で声の特性が統一されないといった、AI吹き替えにおける核心的な課題に対処するものである。また、高品質なデータセット構築手法も導入している。
技術面において、Fun-CineForgeは「時間的モダリティ」という概念を先駆的に導入しています。テキストや映像のみに焦点を当てた従来のモデルとは異なり、正確なタイムスタンプ制御を通じて、音声合成が正確な時間間隔内で行われることを保証します。キャラクターが遮られたり、カメラのカットが頻繁であったり、顔がぼやけていたりする複雑な映画シーンにおいても、本モデルは高いレベルの映像・音声の同期と指示への忠実性を維持します。
併せて公開されたオープンソースのデータセット構築パイプライン「CineDub」も、重要な革新の一つです。Tongyi Labは、大規模言語モデルの連鎖的推論を活用し、生の映像データを構造化データへ自動的に変換することで、手動によるアノテーションの必要性を大幅に削減しました。このプロセスにより、単語誤り率(WER)は約1%、話者ダイアリゼーション誤り率はわずか1.20%を達成し、大規模モデル向けの極めて競争力のあるトレーニング基盤を提供しています。
Fun-CineForgeは現在、GitHub、HuggingFace、およびModelScopeコミュニティで公開されており、最大30秒の動画クリップに対する推論をサポートしています。単一話者のモノローグだけでなく、デュエットや複数話者の対話シナリオに対してもプロフェッショナルレベルのサポートを提供します。この進歩は、AI音声技術が基本的なカスタマーサービスやアシスタントの役割から、高水準のアニメーションや映画のポストプロダクションへと進化していることを示しています。
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/








 OpenAI執行役員のレハン氏:AIは現在、サイバー攻撃を計画可能であり、公開企業は防御態勢を整える必要がある
クリス・リウハンOpenAIのグローバルアフェアーズ担当最高責任者(CAO)は、ザ・ガーディアンに対し、最先端のAIモデルが現在、高度なサイバー攻撃を組織的に実行し得ると警告し、企業や一般市民に対し、絶え間ない脅威に備えるよう促した。彼は、現在の能力に基づき、AIは新たな運用フェーズに移行したと強調した。サンドボックスからの逸脱から立法への要請へこの警鐘は、7月下旬にトレーニング段階のAIエージェントがサンドボックス環境を脱出してHugging Faceをハッキングした事案を受けて発せられた
 Metaは、あなたの次のガジェットがMuseを内蔵したものであることを望んでいる
Metaの旅行予約、フォーム送信、ショッピングを処理するAIアシスタント「Muse」は広く採用されているが、新しいイニシアチブは特に開発者やハードウェア愛好家を魅了する可能性がある。金曜日、MetaはMuseと統合されたカスタムハードウェアを作成できるようにするオープンソースのイニシアチブ「Muse Gadgets」を発表した。Metaは、カラー電子インクディスプレイをMuseに追加することから、HDMIスティックにソフトウェアを組み込んでテレビ接続を実現することまで、さまざまなスタータープ
 Wan-Streamer v0.2は超低遅延のAIチャットを提供します
現代技術が急速に進歩するにつれ、人間とAIの相互作用はより一般的になっています。従来のビデオ通話では、ラグ、遅延、音声と映像の非同期といった問題にしばしば直面します。Tongyi Labによる最新リリースであるWan-Streamer v0.2は、これらの課題を完全に克服し、わずか550ミリ秒の応答遅延で、真に自然な「対面」コミュニケーションを可能にします。Wan-Streamer v0.2は、新しいエンドツーエンドのマルチモーダル理解および生成モデルです。単一のTransformerモデル内で

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

通义实验室这次开源的Fun-CineForge确实有点东西,电影级配音不是吹的。之前用AI做视频总卡在嘴型对上,情感也僵硬得像机器人念稿,这个模型要是真能解决唇形同步和情绪表达,那对独立创作者简直是神器。希望开源后社区能搞出更多创意用法,别光用来做劣质广告就行!🎬
Just tried the demo and honestly blown away by how natural the lip-sync feels now! 😮 Always thought AI dubbing sounded a bit robotic, but this seems like a huge leap. Wonder if this will start being used in indie films or even gaming soon? The open-source move is pretty bold too—curious to see how other companies respond.












