


 Heim
Alibabas Tongyi stellt Fun-CineForge vor: Open-Source-KI-Modell ermöglicht Sprachsynthese in Kinoqualität
Das Alibaba Tongyi Lab hat am 16. März das multimodale Modell „Fun-CineForge“ für die filmspitzen, szenarioübergreifende Sprachsynthese offiziell vorgestellt und als Open-Source-Projekt veröffentlicht. Dieses Modell befasst sich mit zentralen Herausforderungen bei der KI-Synchronisation, darunter Lippensynchronisationsfehler, mangelnder emotionaler Ausdruck und uneinheitliche Stimmcharakteristika bei mehreren Charakteren. Zudem führt es eine hochwertige Methode zur Erstellung von Datensätzen ein.
Technisch gesehen ist Fun-CineForge Vorreiter beim Konzept der „zeitlichen Modalität“. Im Gegensatz zu herkömmlichen Modellen, die sich ausschließlich auf Text oder Bildmaterial konzentrieren, stellt es durch präzise Zeitstempelsteuerung sicher, dass die Sprachsynthese innerhalb genauer Zeitintervalle erfolgt. Selbst in komplexen Filmszenen mit verdeckten Charakteren, häufigen Kameraschnitten oder unscharfen Gesichtern gewährleistet das Modell ein hohes Maß an audiovisueller Synchronisation und die Einhaltung von Anweisungen.
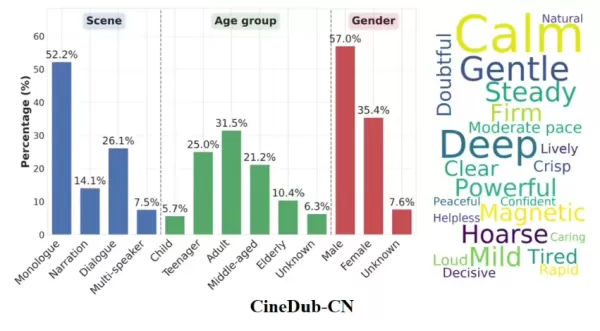
Die begleitende Open-Source-Pipeline zur Erstellung des CineDub-Datensatzes ist eine weitere wichtige Innovation. Tongyi Lab nutzte die Kettengedanken-Argumentation großer Sprachmodelle, um rohes Filmmaterial automatisch in strukturierte Daten umzuwandeln, wodurch der Bedarf an manueller Annotation erheblich reduziert wurde. Dieser Prozess erreicht eine Wortfehlerrate von etwa 1 % und eine Sprecher-Diarisierungsfehlerrate von nur 1,20 %, was eine äußerst wettbewerbsfähige Trainingsgrundlage für große Modelle bietet.
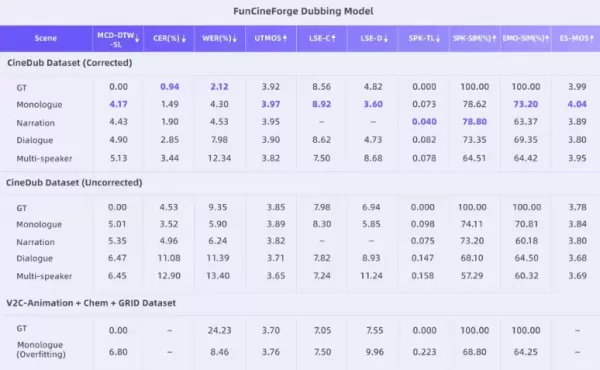
Fun-CineForge ist nun auf GitHub, HuggingFace und in der ModelScope-Community verfügbar und unterstützt die Inferenz für Videoclips mit einer Länge von bis zu 30 Sekunden. Es zeichnet sich nicht nur bei Monologen einzelner Sprecher aus, sondern bietet auch professionelle Unterstützung für Duett- und Mehrsprecher-Dialogszenarien. Dieser Fortschritt signalisiert die Entwicklung der KI-Sprachtechnologie von grundlegenden Kundendienst- und Assistenzfunktionen hin zu hochwertiger Animation und Film-Postproduktion.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/
Verwandter Artikel
 Wan-Streamer v0.2 bietet ultra-niedrige Latenz für KI-Chats
Da sich die moderne Technologie rasch weiterentwickelt, wird die Interaktion zwischen Mensch und KI immer häufiger. Traditionelle Videoanrufe kämpfen oft mit Verzögerungen, Latenzzeiten und einer Synchronisationslücke zwischen Audio und Video. Wan-St
Meta schließt sich TSMC und Micron an, um neue Server mit alter Speicherhardware auszustatten
Während die Einführung künstlicher Intelligenz weltweit voranschreitet, herrscht bei dem nächsten Generation DDR5-Speicher eine kritische Knappheit. Um Verzögerungen beim Aufbau von KI-Rechenzentren zu vermeiden, hat Meta mit Branchenführern wie TSMC
Wie Zeitreihendatenbanken Echtzeit-Robotikdaten ermöglichen
Doug Pagnutti von Tiger Data.Pagnutti fungiert als Industrial Developer Advocate bei Tiger Data und unterstützt Teams beim Aufbau industrieller Systeme in der Praxis.Mit über 12 Jahren Erfahrung in den Bereichen Öl und Gas sowie Fertigungsautomatisie
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (2)
![GregoryGreen]()
通义实验室这次开源的Fun-CineForge确实有点东西,电影级配音不是吹的。之前用AI做视频总卡在嘴型对上,情感也僵硬得像机器人念稿,这个模型要是真能解决唇形同步和情绪表达,那对独立创作者简直是神器。希望开源后社区能搞出更多创意用法,别光用来做劣质广告就行!🎬
![NicholasThomas]()
Just tried the demo and honestly blown away by how natural the lip-sync feels now! 😮 Always thought AI dubbing sounded a bit robotic, but this seems like a huge leap. Wonder if this will start being used in indie films or even gaming soon? The open-source move is pretty bold too—curious to see how other companies respond.
Das Alibaba Tongyi Lab hat am 16. März das multimodale Modell „Fun-CineForge“ für die filmspitzen, szenarioübergreifende Sprachsynthese offiziell vorgestellt und als Open-Source-Projekt veröffentlicht. Dieses Modell befasst sich mit zentralen Herausforderungen bei der KI-Synchronisation, darunter Lippensynchronisationsfehler, mangelnder emotionaler Ausdruck und uneinheitliche Stimmcharakteristika bei mehreren Charakteren. Zudem führt es eine hochwertige Methode zur Erstellung von Datensätzen ein.
Technisch gesehen ist Fun-CineForge Vorreiter beim Konzept der „zeitlichen Modalität“. Im Gegensatz zu herkömmlichen Modellen, die sich ausschließlich auf Text oder Bildmaterial konzentrieren, stellt es durch präzise Zeitstempelsteuerung sicher, dass die Sprachsynthese innerhalb genauer Zeitintervalle erfolgt. Selbst in komplexen Filmszenen mit verdeckten Charakteren, häufigen Kameraschnitten oder unscharfen Gesichtern gewährleistet das Modell ein hohes Maß an audiovisueller Synchronisation und die Einhaltung von Anweisungen.
Die begleitende Open-Source-Pipeline zur Erstellung des CineDub-Datensatzes ist eine weitere wichtige Innovation. Tongyi Lab nutzte die Kettengedanken-Argumentation großer Sprachmodelle, um rohes Filmmaterial automatisch in strukturierte Daten umzuwandeln, wodurch der Bedarf an manueller Annotation erheblich reduziert wurde. Dieser Prozess erreicht eine Wortfehlerrate von etwa 1 % und eine Sprecher-Diarisierungsfehlerrate von nur 1,20 %, was eine äußerst wettbewerbsfähige Trainingsgrundlage für große Modelle bietet.
Fun-CineForge ist nun auf GitHub, HuggingFace und in der ModelScope-Community verfügbar und unterstützt die Inferenz für Videoclips mit einer Länge von bis zu 30 Sekunden. Es zeichnet sich nicht nur bei Monologen einzelner Sprecher aus, sondern bietet auch professionelle Unterstützung für Duett- und Mehrsprecher-Dialogszenarien. Dieser Fortschritt signalisiert die Entwicklung der KI-Sprachtechnologie von grundlegenden Kundendienst- und Assistenzfunktionen hin zu hochwertiger Animation und Film-Postproduktion.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/








 Wan-Streamer v0.2 bietet ultra-niedrige Latenz für KI-Chats
Da sich die moderne Technologie rasch weiterentwickelt, wird die Interaktion zwischen Mensch und KI immer häufiger. Traditionelle Videoanrufe kämpfen oft mit Verzögerungen, Latenzzeiten und einer Synchronisationslücke zwischen Audio und Video. Wan-St
 Meta schließt sich TSMC und Micron an, um neue Server mit alter Speicherhardware auszustatten
Während die Einführung künstlicher Intelligenz weltweit voranschreitet, herrscht bei dem nächsten Generation DDR5-Speicher eine kritische Knappheit. Um Verzögerungen beim Aufbau von KI-Rechenzentren zu vermeiden, hat Meta mit Branchenführern wie TSMC
 Wie Zeitreihendatenbanken Echtzeit-Robotikdaten ermöglichen
Doug Pagnutti von Tiger Data.Pagnutti fungiert als Industrial Developer Advocate bei Tiger Data und unterstützt Teams beim Aufbau industrieller Systeme in der Praxis.Mit über 12 Jahren Erfahrung in den Bereichen Öl und Gas sowie Fertigungsautomatisie

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

通义实验室这次开源的Fun-CineForge确实有点东西,电影级配音不是吹的。之前用AI做视频总卡在嘴型对上,情感也僵硬得像机器人念稿,这个模型要是真能解决唇形同步和情绪表达,那对独立创作者简直是神器。希望开源后社区能搞出更多创意用法,别光用来做劣质广告就行!🎬
Just tried the demo and honestly blown away by how natural the lip-sync feels now! 😮 Always thought AI dubbing sounded a bit robotic, but this seems like a huge leap. Wonder if this will start being used in indie films or even gaming soon? The open-source move is pretty bold too—curious to see how other companies respond.












