


 Lar
Meta interrompe o licenciamento do livro para treinamento de IA, os documentos do tribunal revelam
Em um desenvolvimento recente no processo de direitos autorais em andamento contra a Meta, surgiram novos documentos judiciais que dão peso a rumores anteriores sobre a empresa que acertou a pausa em negociações com os editores de livros. Essas discussões foram feitas para garantir licenças para o treinamento de dados para alimentar alguns dos modelos generativos de IA da Meta. O caso em questão, Kadrey v. Meta plataformas, é apenas uma das várias batalhas legais semelhantes que navegam no sistema judicial dos EUA, onde as empresas de IA se encontram em desacordo com autores e outros detentores de direitos autorais. Normalmente, as empresas de IA, como réus, argumentam que o uso de material protegido por direitos autorais para o treinamento se enquadra em "Uso justo", uma posição ferozmente contestada pelos demandantes, que são os proprietários de direitos autorais. Os últimos registros, submetidos ao tribunal na sexta -feira, contêm trechos de depoimentos de meta funcionários, tomados pela equipe jurídica dos demandantes. Esses documentos sugerem que alguns da Meta acreditavam que a negociação de licenças para dados de livros para treinar IA pode não ser uma estratégia viável de longo prazo. Durante seu depoimento, Sy Choudhury, que lidera as iniciativas de parceria da AI da Meta, mencionou que suas tentativas de se conectar com vários editores foram recebidas com a recepção morna. "Não me lembro da lista inteira, mas lembro que tínhamos feito uma longa lista de vasculhar inicialmente a Internet dos principais editores, etc.", afirmou Choudhury, de acordo com a transcrição. "E não obtivemos contato e feedback - de muitos dos nossos alcance de chamadas frias para tentar estabelecer contato". Ele acrescentou que apenas um punhado de editores realmente se envolveu com eles. As transcrições do tribunal revelam que a Meta controlou certos esforços de licenciamento de livros relacionados à IA no início de abril de 2023, citando questões com o tempo e outros obstáculos logísticos. Choudhury explicou que alguns editores, particularmente aqueles que lidam com ficção, não possuíam os direitos da meta de conteúdo estava interessada em licenciamento. "Gostaria de ressaltar que, na categoria de ficção, aprendemos rapidamente com a equipe de desenvolvimento de negócios com a qual a maioria dos editores que estávamos conversando, eles mesmos estavam representando que não tinham, na verdade, os direitos de licenciar os dados para nós", disse ele. "E assim levaria muito tempo para se envolver com todos os seus autores". Choudhury também revelou durante seu depoimento que a Meta falou anteriormente outros esforços de licenciamento relacionados à IA. Ele citou uma instância em que eles tentaram licenciar mundos 3D dos fabricantes de motores e jogos de jogos para sua equipe de pesquisa de IA, mas receberam pouco interesse. "E da mesma maneira que estou descrevendo aqui para dados de ficção e livros didáticos, temos muito pouco envolvimento para ter uma conversa [...] decidimos - nesse caso, decidimos construir nossa própria solução", explicou. The plaintiffs' legal team, representing notable authors like Sarah Silverman and Ta-Nehisi Coates, has amended their complaint multiple times since the lawsuit was initiated in the US District Court for the Northern District of California, San Francisco Division, in 2023. The most recent amendment accuses Meta of comparing pirated books with copyrighted ones available for licensing to evaluate the feasibility of entering into a licensing agreement with a editor. Além disso, a denúncia alega que a Meta utilizou "Bibliotecas de Sombras", cheias de e-books pirateados para treinar vários de seus modelos de IA, incluindo a conhecida série Llama de modelos "abertos". Ele sugere que a Meta pode ter acessado essas bibliotecas por meio de torrenting, um método de compartilhamento de arquivos que envolve o upload ou a "semeadura", os arquivos que se estão baixando, que a alegação dos demandantes constitui violação de direitos autorais.
Artigo relacionado
 A Apple concorda com um acordo de US$ 250 milhões devido ao atraso no lançamento da IA do Siri
A Apple concordou em pagar 250 milhões de dólares para resolver uma ação coletiva sobre sua comercialização de recursos de IA antes do lançamento do iPhone 16, conforme notificado pela primeira vez pelo Financial Times.A ação alegou que a Apple exag
O Muse da Meta supera o ChatGPT no lançamento inicial para dispositivos móveis
Novos dados sugerem que o mais recente aplicativo de IA da Meta, o Muse, pode se tornar o próximo grande sucesso do gigante das redes sociais. De acordo com estimativas recentes da Appfigures, o Muse foi baixado em dispositivos móveis mais vezes em s
A Muse da Meta chega ao Mac, permitindo que a IA realize ações no seu computador
O mais recente assistente de IA da Meta, Muse, já está disponível no Mac.No macOS, o Muse integra-se aos seus arquivos, mensagens, calendário, notas e e-mail, operando diretamente dentro de seus aplicativos nativos.Este lançamento para desktop segu
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (35)
![BillyYoung]()
Интересно, сколько вообще больших книг Meta успела закупить до этих судебных процессов? 🧐 Это похоже на попытку заткнуть дыру в лодке, когда она уже почти набрала воды. Их модель Llama уже обучена на части этого контента, разве нет? Остановка переговоров выглядит скорее как PR-ход из-за иска, а не реальная смена этических принципов в ИИ. Ждём следующий ход от Google и OpenAI.
![VictoriaBaker]()
Pas étonnant que Meta fasse marche arrière... Les questions de droits d'auteur dans l'IA deviennent vraiment épineuses. Est-ce qu'on va vers un futur où seuls les géants tech pourront se permettre d'entraîner des modèles ? 😬 Cette course aux données commence à ressembler à une partie d'échecs légale.
![CarlMartin]()
Intéressant, mais Meta aurait dû anticiper ces problèmes de droits d'auteur depuis longtemps... C'est un peu naïf de penser qu'on peut utiliser des livres sans permission, non ? 😅 Les grandes entreprises tech devraient vraiment réfléchir aux conséquences avant d'agir.
![KeithLopez]()
Wow, Meta pausing book licensing talks for AI training is a big shift! Makes me wonder if they're rethinking their whole AI strategy or just dodging legal heat. 📚⚖️
![RaymondGarcia]()
Wow, Meta's hitting the brakes on book licensing for AI? Kinda wild to think how much copyrighted stuff gets scooped up for these models. Makes me wonder what's next for AI ethics.
![CharlesRoberts]()
Nossa, a decisão da Meta de interromper a licença de livros para treinamento de IA é algo grande! Parece que eles estão freando seus projetos de IA. Fico me perguntando o que vem a seguir para eles. Espero que encontrem uma maneira de avançar sem pisar em muitos calos! 🤔








 A Apple concorda com um acordo de US$ 250 milhões devido ao atraso no lançamento da IA do Siri
A Apple concordou em pagar 250 milhões de dólares para resolver uma ação coletiva sobre sua comercialização de recursos de IA antes do lançamento do iPhone 16, conforme notificado pela primeira vez pelo Financial Times.A ação alegou que a Apple exag
 O Muse da Meta supera o ChatGPT no lançamento inicial para dispositivos móveis
Novos dados sugerem que o mais recente aplicativo de IA da Meta, o Muse, pode se tornar o próximo grande sucesso do gigante das redes sociais. De acordo com estimativas recentes da Appfigures, o Muse foi baixado em dispositivos móveis mais vezes em s
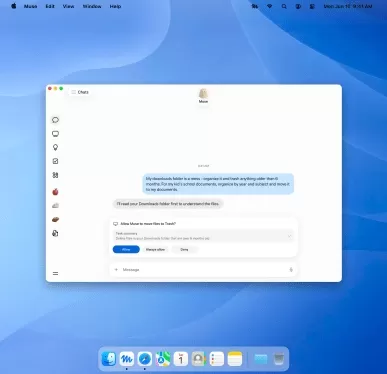 A Muse da Meta chega ao Mac, permitindo que a IA realize ações no seu computador
O mais recente assistente de IA da Meta, Muse, já está disponível no Mac.No macOS, o Muse integra-se aos seus arquivos, mensagens, calendário, notas e e-mail, operando diretamente dentro de seus aplicativos nativos.Este lançamento para desktop segu

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

Интересно, сколько вообще больших книг Meta успела закупить до этих судебных процессов? 🧐 Это похоже на попытку заткнуть дыру в лодке, когда она уже почти набрала воды. Их модель Llama уже обучена на части этого контента, разве нет? Остановка переговоров выглядит скорее как PR-ход из-за иска, а не реальная смена этических принципов в ИИ. Ждём следующий ход от Google и OpenAI.
Pas étonnant que Meta fasse marche arrière... Les questions de droits d'auteur dans l'IA deviennent vraiment épineuses. Est-ce qu'on va vers un futur où seuls les géants tech pourront se permettre d'entraîner des modèles ? 😬 Cette course aux données commence à ressembler à une partie d'échecs légale.
Intéressant, mais Meta aurait dû anticiper ces problèmes de droits d'auteur depuis longtemps... C'est un peu naïf de penser qu'on peut utiliser des livres sans permission, non ? 😅 Les grandes entreprises tech devraient vraiment réfléchir aux conséquences avant d'agir.
Wow, Meta pausing book licensing talks for AI training is a big shift! Makes me wonder if they're rethinking their whole AI strategy or just dodging legal heat. 📚⚖️
Wow, Meta's hitting the brakes on book licensing for AI? Kinda wild to think how much copyrighted stuff gets scooped up for these models. Makes me wonder what's next for AI ethics.
Nossa, a decisão da Meta de interromper a licença de livros para treinamento de IA é algo grande! Parece que eles estão freando seus projetos de IA. Fico me perguntando o que vem a seguir para eles. Espero que encontrem uma maneira de avançar sem pisar em muitos calos! 🤔












