
option
Maison
Flash info
Contenu
JustinScott
JustinScott
9 juillet 2026

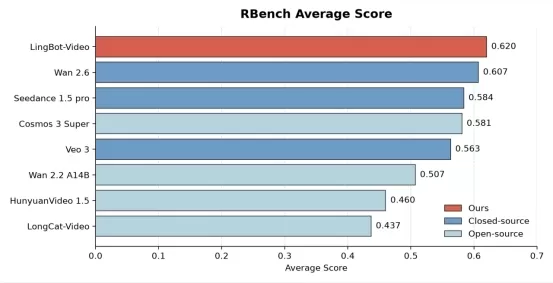
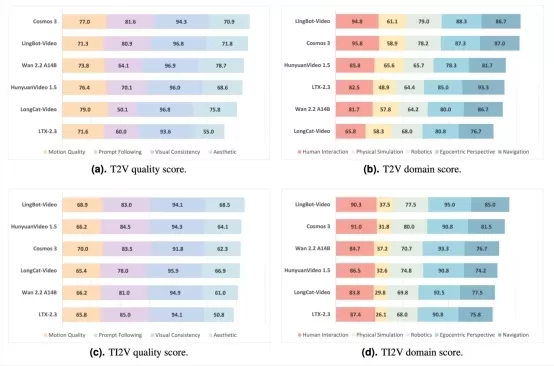
Ant Group a mis en open source LingBot-Video, le premier modèle de base pour la génération vidéo basé sur une architecture Mixture-of-Experts conçue pour l’intelligence incarnée. Il a obtenu un score de 0,620 sur le benchmark RBench, surpassant ainsi Wan2.6 et d’autres modèles. Grâce à ses 30 milliards de paramètres tout en n’activant que 3 milliards par inférence, il offre une efficacité de raisonnement plus élevée. Entraîné sur 70 000 heures de données liées à l’intelligence incarnée au moyen d’un système de récompense basé sur un apprentissage par renforcement multidimensionnel, ce modèle se distingue par sa capacité à garantir une plausibilité physique et à accomplir efficacement les tâches en robotique.
Ant Group a mis en open source LingBot-Video, le premier modèle de base pour la génération vidéo basé sur une architecture Mixture-of-Experts conçue pour l’intelligence incarnée. Il a obtenu un score de 0,620 sur le benchmark RBench, surpassant ainsi Wan2.6 et d’autres modèles. Grâce à ses 30 milliards de paramètres tout en n’activant que 3 milliards par inférence, il offre une efficacité de raisonnement plus élevée. Entraîné sur 70 000 heures de données liées à l’intelligence incarnée au moyen d’un système de récompense basé sur un apprentissage par renforcement multidimensionnel, ce modèle se distingue par sa capacité à garantir une plausibilité physique et à accomplir efficacement les tâches en robotique. Ant Group a mis en open source LingBot-Video, le premier modèle de base pour la génération vidéo basé sur une architecture Mixture-of-Experts conçue pour l’intelligence incarnée. Il a obtenu un score de 0,620 sur le benchmark RBench, surpassant ainsi Wan2.6 et d’autres modèles. Grâce à ses 30 milliards de paramètres tout en n’activant que 3 milliards par inférence, il offre une efficacité de raisonnement plus élevée. Entraîné sur 70 000 heures de données liées à l’intelligence incarnée au moyen d’un système de récompense basé sur un apprentissage par renforcement multidimensionnel, ce modèle se distingue par sa capacité à garantir une plausibilité physique et à accomplir efficacement les tâches en robotique. Ant Group a mis en open source LingBot-Video, le premier modèle de base pour la génération vidéo basé sur une architecture Mixture-of-Experts conçue pour l’intelligence incarnée. Il a obtenu un score de 0,620 sur le benchmark RBench, surpassant ainsi Wan2.6 et d’autres modèles. Grâce à ses 30 milliards de paramètres tout en n’activant que 3 milliards par inférence, il offre une efficacité de raisonnement plus élevée. Entraîné sur 70 000 heures de données liées à l’intelligence incarnée au moyen d’un système de récompense basé sur un apprentissage par renforcement multidimensionnel, ce modèle se distingue par sa capacité à garantir une plausibilité physique et à accomplir efficacement les tâches en robotique.
commentaires (0)
0/300
OR