
opción
Hogar
Última hora
Contenido
JustinScott
JustinScott
9 de julio de 2026

Ant Group ha hecho público el código de LingBot-Video, el primer modelo fundamental para la generación de video basado en una arquitectura Mixture-of-Experts diseñada específicamente para la inteligencia encarnada. Este modelo obtuvo un puntaje de 0.620 en la prueba de referencia RBench, superando a Wan2.6 y a otros competidores. Al contar con 30 mil millones de parámetros pero activar únicamente 3 mil millones por inferencia, ofrece una mayor eficiencia en el razonamiento. Entrenado con 70,000 horas de datos relacionados con la inteligencia encarnada y un sistema de recompensas basado en aprendizaje por refuerzo multidimensional, destaca por su capacidad para garantizar la plausibilidad física y completar tareas en el ámbito de la robótica.
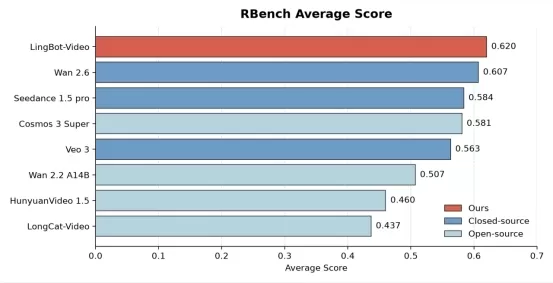
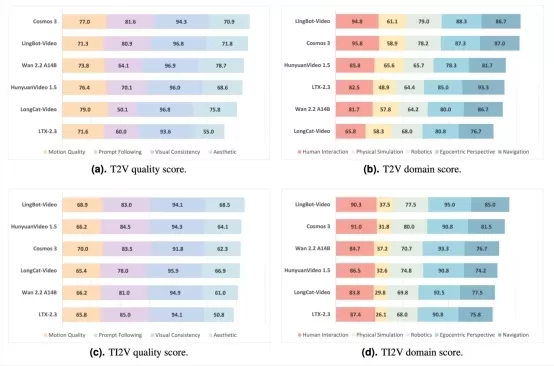
Ant Group ha hecho público el código de LingBot-Video, el primer modelo fundamental para la generación de video basado en una arquitectura Mixture-of-Experts diseñada específicamente para la inteligencia encarnada. Este modelo obtuvo un puntaje de 0.620 en la prueba de referencia RBench, superando a Wan2.6 y a otros competidores. Al contar con 30 mil millones de parámetros pero activar únicamente 3 mil millones por inferencia, ofrece una mayor eficiencia en el razonamiento. Entrenado con 70,000 horas de datos relacionados con la inteligencia encarnada y un sistema de recompensas basado en aprendizaje por refuerzo multidimensional, destaca por su capacidad para garantizar la plausibilidad física y completar tareas en el ámbito de la robótica. Ant Group ha hecho público el código de LingBot-Video, el primer modelo fundamental para la generación de video basado en una arquitectura Mixture-of-Experts diseñada específicamente para la inteligencia encarnada. Este modelo obtuvo un puntaje de 0.620 en la prueba de referencia RBench, superando a Wan2.6 y a otros competidores. Al contar con 30 mil millones de parámetros pero activar únicamente 3 mil millones por inferencia, ofrece una mayor eficiencia en el razonamiento. Entrenado con 70,000 horas de datos relacionados con la inteligencia encarnada y un sistema de recompensas basado en aprendizaje por refuerzo multidimensional, destaca por su capacidad para garantizar la plausibilidad física y completar tareas en el ámbito de la robótica. Ant Group ha hecho público el código de LingBot-Video, el primer modelo fundamental para la generación de video basado en una arquitectura Mixture-of-Experts diseñada específicamente para la inteligencia encarnada. Este modelo obtuvo un puntaje de 0.620 en la prueba de referencia RBench, superando a Wan2.6 y a otros competidores. Al contar con 30 mil millones de parámetros pero activar únicamente 3 mil millones por inferencia, ofrece una mayor eficiencia en el razonamiento. Entrenado con 70,000 horas de datos relacionados con la inteligencia encarnada y un sistema de recompensas basado en aprendizaje por refuerzo multidimensional, destaca por su capacidad para garantizar la plausibilidad física y completar tareas en el ámbito de la robótica.
comentario (0)
0/300
OR