
opção
JustinScott
JustinScott
9 de Julho de 2026

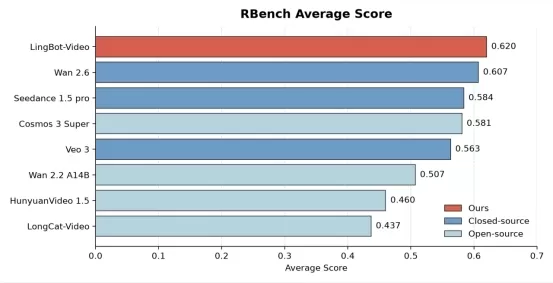
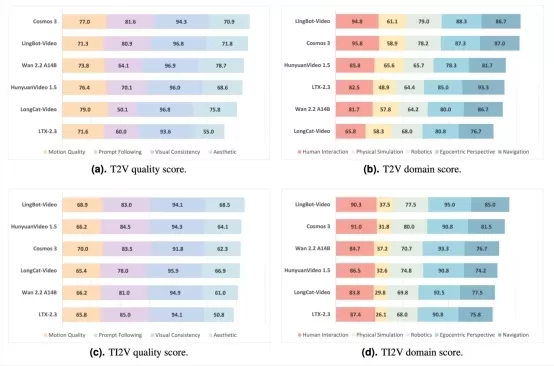
O Ant Group disponibilizou em código aberto o LingBot-Video, o primeiro modelo fundamental de geração de vídeo baseado em uma arquitetura Mixture-of-Experts desenvolvida para inteligência corporal. Ele alcançou a marca de 0,620 no benchmark RBench, superando modelos como o Wan2.6 e outros concorrentes. Com 30 bilhões de parâmetros, mas ativando apenas 3 bilhões por inferência, ele oferece maior eficiência no raciocínio. Treinado com 70.000 horas de dados relacionados à inteligência corporal, utilizando um sistema de recompensas de aprendizado por reforço multidimensional, esse modelo se destaca pela plausibilidade física e pela capacidade de completar tarefas em robótica.
O Ant Group disponibilizou em código aberto o LingBot-Video, o primeiro modelo fundamental de geração de vídeo baseado em uma arquitetura Mixture-of-Experts desenvolvida para inteligência corporal. Ele alcançou a marca de 0,620 no benchmark RBench, superando modelos como o Wan2.6 e outros concorrentes. Com 30 bilhões de parâmetros, mas ativando apenas 3 bilhões por inferência, ele oferece maior eficiência no raciocínio. Treinado com 70.000 horas de dados relacionados à inteligência corporal, utilizando um sistema de recompensas de aprendizado por reforço multidimensional, esse modelo se destaca pela plausibilidade física e pela capacidade de completar tarefas em robótica. O Ant Group disponibilizou em código aberto o LingBot-Video, o primeiro modelo fundamental de geração de vídeo baseado em uma arquitetura Mixture-of-Experts desenvolvida para inteligência corporal. Ele alcançou a marca de 0,620 no benchmark RBench, superando modelos como o Wan2.6 e outros concorrentes. Com 30 bilhões de parâmetros, mas ativando apenas 3 bilhões por inferência, ele oferece maior eficiência no raciocínio. Treinado com 70.000 horas de dados relacionados à inteligência corporal, utilizando um sistema de recompensas de aprendizado por reforço multidimensional, esse modelo se destaca pela plausibilidade física e pela capacidade de completar tarefas em robótica. O Ant Group disponibilizou em código aberto o LingBot-Video, o primeiro modelo fundamental de geração de vídeo baseado em uma arquitetura Mixture-of-Experts desenvolvida para inteligência corporal. Ele alcançou a marca de 0,620 no benchmark RBench, superando modelos como o Wan2.6 e outros concorrentes. Com 30 bilhões de parâmetros, mas ativando apenas 3 bilhões por inferência, ele oferece maior eficiência no raciocínio. Treinado com 70.000 horas de dados relacionados à inteligência corporal, utilizando um sistema de recompensas de aprendizado por reforço multidimensional, esse modelo se destaca pela plausibilidade física e pela capacidade de completar tarefas em robótica.
Comentários (0)
0/300
OR