


 Maison
La prise en charge officielle de Tongyi Qianwen arrive alors qu’Unsloth Dynamic V3 réduit la taille de Qwen3.8-27B grâce à une version 1 bit fonctionnant avec 8 Go de mémoire
Tongyi Qianwen (Qwen) a récemment rendu hommage publiquement à l’équipe d’Unsloth pour avoir publié la version quantifiée Qwen3.8-27B GGUF, la qualifiant de « plus compacte et plus intelligente ». Cet échange a suscité un vif débat au sein de la communauté open source, soulignant la réduction constante des obstacles au déploiement local de grands modèles.
Échange officiel : Tongyi Qianwen remercie Unsloth
Dans sa déclaration officielle, Tongyi Qianwen a exprimé sa sincère gratitude envers Unsloth pour son travail, qualifiant cette nouvelle d’excellente pour la communauté et encourageant les utilisateurs à essayer cette version « plus compacte et plus intelligente » de Qwen3.8-27B. Cette initiative met en évidence la synergie croissante entre les développeurs de modèles open source et les fournisseurs de solutions d’optimisation par quantification.
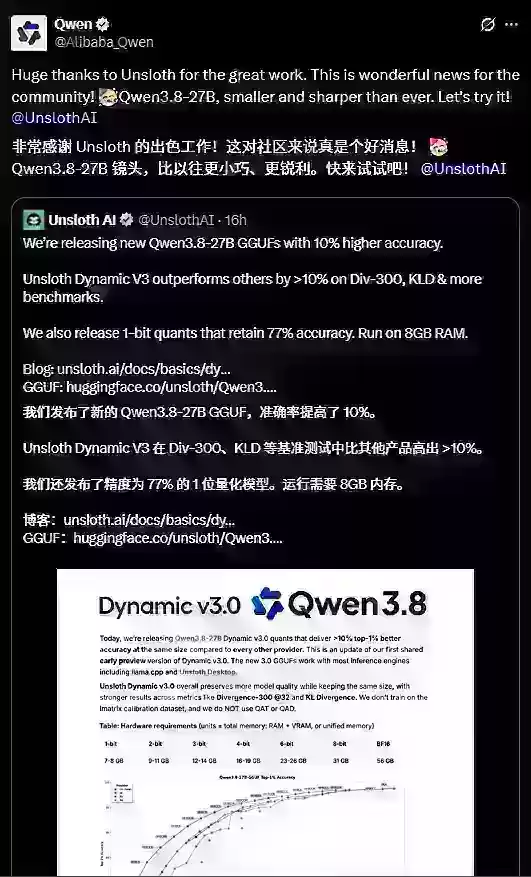
Mise à jour majeure de la solution de quantification Dynamic V3 d’Unsloth
La dernière solution de quantification Dynamic V3 (v3.0) d’Unsloth est spécialement optimisée pour le modèle Qwen3.8-27B. Selon les données officielles, cette approche améliore la précision de plus de 10 % par rapport aux autres méthodes de quantification courantes pour une taille de fichier identique, offrant des performances exceptionnelles sur des benchmarks clés tels que Div-300 et KLD (KL Divergence).
Cette mise à jour va au-delà d’une simple compression. En tirant parti de techniques de quantification post-entraînement améliorées, elle préserve mieux la qualité de sortie du modèle d’origine, se rapprochant ainsi des performances en précision totale dans le codage d’agents intelligents, les dialogues et les tâches multilingues. Les fichiers GGUF correspondants sont désormais disponibles sur Hugging Face et prennent en charge les outils d’inférence courants tels que llama.cpp et Unsloth Desktop.
Version à quantification sur 1 bit : fonctionne avec 8 Go de mémoire
Il convient de noter qu’Unsloth a également publié une version à quantification sur 1 bit. Cette variante conserve environ 77 % de précision tout en réduisant considérablement les besoins en ressources, ce qui permet un fonctionnement sur des appareils dotés de seulement 8 Go de mémoire. Certaines variantes ultra-compressées (telles que UD-IQ1_S, environ 6,2 Go) réduisent la taille du fichier d’environ 89 % par rapport à la précision complète, tout en offrant des performances exploitables.
Auparavant, l’exécution d’un Qwen3.8-27B quantifié à 4 bits nécessitait généralement entre 16 et 19 Go de VRAM ou de mémoire système. Désormais, ces options à faible nombre de bits permettent aux ordinateurs portables standard et aux appareils grand public d’expérimenter ce modèle multimodal de 27 milliards de paramètres.
Importance pour l’écosystème local de l’IA
Qwen3.8-27B prend en charge nativement les capacités multimodales, dispose d’une fenêtre de contexte de 262 000 tokens (extensible à environ 1 million de tokens) et excelle dans les scénarios de codage et de flux de travail bureautiques. Sous licence Apache 2.0, il s’intègre parfaitement à la quantification Dynamic V3 d’Unsloth, permettant aux développeurs d’effectuer des inférences et des réglages fins en local avec plus de facilité et en réduisant leur dépendance vis-à-vis de l’infrastructure cloud.
AIbase considère que la collaboration fructueuse entre Tongyi Qianwen et Unsloth, ainsi que les doubles avancées en matière de précision et d’efficacité offertes par Dynamic V3, marquent le début d’une nouvelle ère dans la localisation des grands modèles open source. Les développeurs intéressés peuvent télécharger les derniers fichiers GGUF sur Hugging Face et consulter la documentation officielle d’Unsloth pour obtenir des guides d’installation.
Article connexe
 OpenAI lance GPT-6 Astra, marquant ainsi une avancée majeure vers l'intelligence artificielle générale
OpenAI a officiellement présenté son tout dernier modèle linguistique phare, le GPT-6Astra. Lors d’une conférence de presse, le président de la société, Greg Brockman, a fait l’éloge de ce modèle, lai
Wayve lance une offre publique d'achat réservée à ses salariés d'un montant de 85 millions de dollars, sur la base d'une valorisation de 8,5 milliards de dollars
Wayve, une start-up britannique spécialisée dans les technologies de conduite autonome, permet à ses employés de céder une partie de leurs actions acquises dans le cadre d’une offre publique d’achat d
Sam Altman met en garde contre l'idée selon laquelle Claude serait doté de conscience
Mustafa Suleyman, responsable de l’IA chez Microsoft, a récemment qualifié de « très dangereuse » l’hypothèse avancée par Anthropic selon laquelle son grand modèle linguistique, Claude, posséderait un
Recommandations de sujets spéciaux liés
Création d'animations
 Les meilleurs générateurs de synchronisation labiale basés sur l'IA pour les scènes de dialogue
Les meilleurs générateurs de synchronisation labiale par IA les mieux notés de 2026 pour les scènes de dialogue sont disponibles sur XIX.AI ! Cette sélection soigneusement élaborée regroupe des outils puissants et révolutionnaires qui offrent une synchronisation labiale impeccable pour n'importe quel scénario, améliorant ainsi considérablement l'efficacité de votre montage vidéo. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal qu'il faut absolument essayer. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l'IA !
 8 outils
 xix.ai
Rapide
Optimiseurs de prompts d'IA : affiner les instructions pour une meilleure qualité des résultats
Les meilleurs optimiseurs de prompts IA de 2026, sélectionnés pour une qualité de résultat optimale ! XIX.AI propose des solutions puissantes et révolutionnaires qui vous aident à affiner vos instructions sans effort, à améliorer votre efficacité rédactionnelle et à obtenir des résultats de meilleure qualité à chaque fois. Consultez un comparatif entre les versions gratuites et payantes, accompagné de tests en conditions réelles et de classements mis à jour chaque semaine. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux et exploiter pleinement le potentiel de l'IA !
16 outils
xix.ai
Création d'animations
Outils de mouvement IA Runway pour les storyboards publicitaires, les scènes de personnages et les prototypes visuels
2026 Derniers Meilleurs Outils de Mouvement IA pour Passerelle Top-rated sélectionnés puissants options révolutionnaires pour créer des storyboards publicitaires des scènes de personnages et des prototypes visuels grâce à des tests en conditions réelles Comparaisons hebdomadaires mises à jour entre versions gratuites et payantes Vous aide à augmenter considérablement la productivité Explorez maintenant
9 outils
xix.ai
Recherche académique
Outils de recherche de jeux de données d'IA pour les projets universitaires
Les meilleurs outils de découverte de jeux de données IA les mieux notés de 2026 pour vos projets universitaires ! XIX.AI a sélectionné une collection puissante et révolutionnaire d'options hautement fiables, toutes soumises à des tests rigoureux en conditions réelles et mises à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes pour vous aider à choisir l'outil idéal qui optimisera l'efficacité de vos recherches et vous fournira des résultats de la plus haute qualité. Découvrez-les dès maintenant pour prendre une longueur d'avance en matière d'IA !
16 outils
xix.ai
Réseaux sociaux
Les meilleurs générateurs de légendes basés sur l'IA : rédigez rapidement des publications sur les réseaux sociaux adaptées à chaque plateforme
Page des meilleurs générateurs de légendes par IA de 2026 ! XIX.AI a sélectionné une liste des outils les mieux notés et incontournables pour rédiger rapidement des publications sur les réseaux sociaux, adaptés à chaque plateforme. Ces outils sont soumis à des tests rigoureux en conditions réelles et font l'objet d'une comparaison entre les versions gratuites et payantes, ainsi que d'un classement clair, afin de vous aider à trouver la meilleure option pour booster votre productivité et tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai
Santé et bien-être
Les meilleurs outils d'accompagnement du sommeil basés sur l'IA pour les travailleurs postés, la récupération après un décalage horaire et l'amélioration des habitudes de vie
Les meilleurs outils de coaching du sommeil basés sur l'IA de 2026 pour les travailleurs postés, la récupération après un décalage horaire et l'amélioration des habitudes ! XIX.AI a sélectionné une liste des outils les mieux notés, puissants et révolutionnaires, qui ont fait leurs preuves dans la pratique pour offrir des conseils précis. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, et découvrirez comment ces solutions incontournables contribuent à améliorer la qualité du sommeil, à accélérer la récupération après un décalage horaire et à adopter des habitudes plus saines. Explorez dès maintenant cette sélection pour trouver l'outil qui vous convient le mieux !
7 outils
xix.ai

 commentaires (0)
Tongyi Qianwen (Qwen) a récemment rendu hommage publiquement à l’équipe d’Unsloth pour avoir publié la version quantifiée Qwen3.8-27B GGUF, la qualifiant de « plus compacte et plus intelligente ». Cet échange a suscité un vif débat au sein de la communauté open source, soulignant la réduction constante des obstacles au déploiement local de grands modèles.
Échange officiel : Tongyi Qianwen remercie Unsloth
Dans sa déclaration officielle, Tongyi Qianwen a exprimé sa sincère gratitude envers Unsloth pour son travail, qualifiant cette nouvelle d’excellente pour la communauté et encourageant les utilisateurs à essayer cette version « plus compacte et plus intelligente » de Qwen3.8-27B. Cette initiative met en évidence la synergie croissante entre les développeurs de modèles open source et les fournisseurs de solutions d’optimisation par quantification.
Mise à jour majeure de la solution de quantification Dynamic V3 d’Unsloth
La dernière solution de quantification Dynamic V3 (v3.0) d’Unsloth est spécialement optimisée pour le modèle Qwen3.8-27B. Selon les données officielles, cette approche améliore la précision de plus de 10 % par rapport aux autres méthodes de quantification courantes pour une taille de fichier identique, offrant des performances exceptionnelles sur des benchmarks clés tels que Div-300 et KLD (KL Divergence).
Cette mise à jour va au-delà d’une simple compression. En tirant parti de techniques de quantification post-entraînement améliorées, elle préserve mieux la qualité de sortie du modèle d’origine, se rapprochant ainsi des performances en précision totale dans le codage d’agents intelligents, les dialogues et les tâches multilingues. Les fichiers GGUF correspondants sont désormais disponibles sur Hugging Face et prennent en charge les outils d’inférence courants tels que llama.cpp et Unsloth Desktop.
Version à quantification sur 1 bit : fonctionne avec 8 Go de mémoire
Il convient de noter qu’Unsloth a également publié une version à quantification sur 1 bit. Cette variante conserve environ 77 % de précision tout en réduisant considérablement les besoins en ressources, ce qui permet un fonctionnement sur des appareils dotés de seulement 8 Go de mémoire. Certaines variantes ultra-compressées (telles que UD-IQ1_S, environ 6,2 Go) réduisent la taille du fichier d’environ 89 % par rapport à la précision complète, tout en offrant des performances exploitables.
Auparavant, l’exécution d’un Qwen3.8-27B quantifié à 4 bits nécessitait généralement entre 16 et 19 Go de VRAM ou de mémoire système. Désormais, ces options à faible nombre de bits permettent aux ordinateurs portables standard et aux appareils grand public d’expérimenter ce modèle multimodal de 27 milliards de paramètres.
Importance pour l’écosystème local de l’IA
Qwen3.8-27B prend en charge nativement les capacités multimodales, dispose d’une fenêtre de contexte de 262 000 tokens (extensible à environ 1 million de tokens) et excelle dans les scénarios de codage et de flux de travail bureautiques. Sous licence Apache 2.0, il s’intègre parfaitement à la quantification Dynamic V3 d’Unsloth, permettant aux développeurs d’effectuer des inférences et des réglages fins en local avec plus de facilité et en réduisant leur dépendance vis-à-vis de l’infrastructure cloud.
AIbase considère que la collaboration fructueuse entre Tongyi Qianwen et Unsloth, ainsi que les doubles avancées en matière de précision et d’efficacité offertes par Dynamic V3, marquent le début d’une nouvelle ère dans la localisation des grands modèles open source. Les développeurs intéressés peuvent télécharger les derniers fichiers GGUF sur Hugging Face et consulter la documentation officielle d’Unsloth pour obtenir des guides d’installation.








 OpenAI lance GPT-6 Astra, marquant ainsi une avancée majeure vers l'intelligence artificielle générale
OpenAI a officiellement présenté son tout dernier modèle linguistique phare, le GPT-6Astra. Lors d’une conférence de presse, le président de la société, Greg Brockman, a fait l’éloge de ce modèle, lai
 Wayve lance une offre publique d'achat réservée à ses salariés d'un montant de 85 millions de dollars, sur la base d'une valorisation de 8,5 milliards de dollars
Wayve, une start-up britannique spécialisée dans les technologies de conduite autonome, permet à ses employés de céder une partie de leurs actions acquises dans le cadre d’une offre publique d’achat d
 Sam Altman met en garde contre l'idée selon laquelle Claude serait doté de conscience
Mustafa Suleyman, responsable de l’IA chez Microsoft, a récemment qualifié de « très dangereuse » l’hypothèse avancée par Anthropic selon laquelle son grand modèle linguistique, Claude, posséderait un
Les meilleurs générateurs de synchronisation labiale par IA les mieux notés de 2026 pour les scènes de dialogue sont disponibles sur XIX.AI ! Cette sélection soigneusement élaborée regroupe des outils puissants et révolutionnaires qui offrent une synchronisation labiale impeccable pour n'importe quel scénario, améliorant ainsi considérablement l'efficacité de votre montage vidéo. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal qu'il faut absolument essayer. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l'IA !
8 outils
xix.ai
Les meilleurs optimiseurs de prompts IA de 2026, sélectionnés pour une qualité de résultat optimale ! XIX.AI propose des solutions puissantes et révolutionnaires qui vous aident à affiner vos instructions sans effort, à améliorer votre efficacité rédactionnelle et à obtenir des résultats de meilleure qualité à chaque fois. Consultez un comparatif entre les versions gratuites et payantes, accompagné de tests en conditions réelles et de classements mis à jour chaque semaine. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux et exploiter pleinement le potentiel de l'IA !
16 outils
xix.ai
2026 Derniers Meilleurs Outils de Mouvement IA pour Passerelle Top-rated sélectionnés puissants options révolutionnaires pour créer des storyboards publicitaires des scènes de personnages et des prototypes visuels grâce à des tests en conditions réelles Comparaisons hebdomadaires mises à jour entre versions gratuites et payantes Vous aide à augmenter considérablement la productivité Explorez maintenant
9 outils
xix.ai
Les meilleurs outils de découverte de jeux de données IA les mieux notés de 2026 pour vos projets universitaires ! XIX.AI a sélectionné une collection puissante et révolutionnaire d'options hautement fiables, toutes soumises à des tests rigoureux en conditions réelles et mises à jour chaque semaine. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes pour vous aider à choisir l'outil idéal qui optimisera l'efficacité de vos recherches et vous fournira des résultats de la plus haute qualité. Découvrez-les dès maintenant pour prendre une longueur d'avance en matière d'IA !
16 outils
xix.ai
Page des meilleurs générateurs de légendes par IA de 2026 ! XIX.AI a sélectionné une liste des outils les mieux notés et incontournables pour rédiger rapidement des publications sur les réseaux sociaux, adaptés à chaque plateforme. Ces outils sont soumis à des tests rigoureux en conditions réelles et font l'objet d'une comparaison entre les versions gratuites et payantes, ainsi que d'un classement clair, afin de vous aider à trouver la meilleure option pour booster votre productivité et tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
11 outils
xix.ai

Les meilleurs outils de coaching du sommeil basés sur l'IA de 2026 pour les travailleurs postés, la récupération après un décalage horaire et l'amélioration des habitudes ! XIX.AI a sélectionné une liste des outils les mieux notés, puissants et révolutionnaires, qui ont fait leurs preuves dans la pratique pour offrir des conseils précis. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, et découvrirez comment ces solutions incontournables contribuent à améliorer la qualité du sommeil, à accélérer la récupération après un décalage horaire et à adopter des habitudes plus saines. Explorez dès maintenant cette sélection pour trouver l'outil qui vous convient le mieux !
7 outils
xix.ai












