


 Hogar
Llega el soporte oficial para Tongyi Qianwen, mientras que Unsloth Dynamic V3 reduce el tamaño de Qwen3.8-27B con una versión de 1 bit que se ejecuta en 8 GB de memoria
Tongyi Qianwen (Qwen) ha agradecido recientemente y de forma pública al equipo de Unsloth por lanzar la versión cuantificada Qwen3.8-27B GGUF, elogiándola por ser «más pequeña y más inteligente». Este intercambio ha suscitado un amplio debate en la comunidad de código abierto, lo que pone de relieve cómo se están reduciendo progresivamente las barreras para la implementación local de modelos de gran tamaño.
Interacción oficial: Tongyi Qianwen da las gracias a Unsloth
En su comunicado oficial, Tongyi Qianwen expresó su sincero agradecimiento por el trabajo de Unsloth, calificándolo de excelente noticia para la comunidad y animando a los usuarios a probar esta versión «más pequeña y más inteligente» de Qwen3.8-27B. Esta iniciativa pone de relieve la creciente sinergia entre los desarrolladores de modelos de código abierto y los proveedores de optimización de cuantificación.
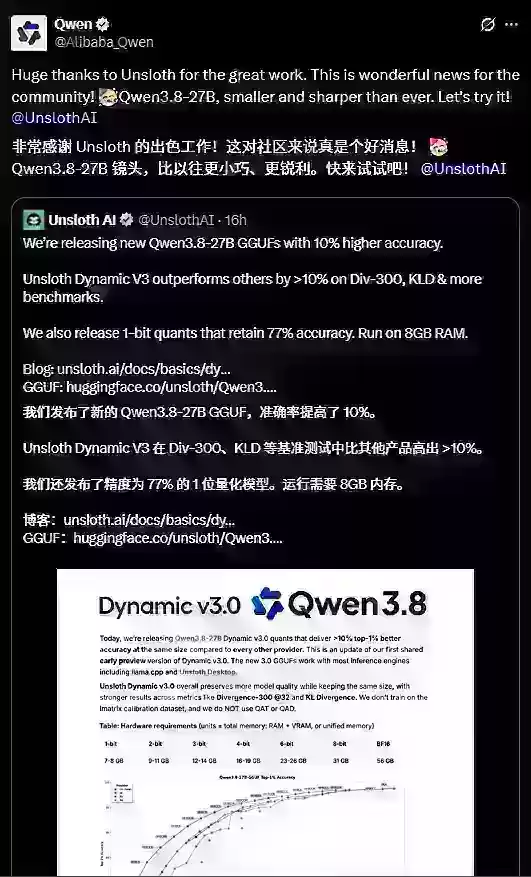
Actualización importante de la cuantificación Dynamic V3 de Unsloth
La última solución de cuantificación Dynamic V3 (v3.0) de Unsloth está optimizada específicamente para Qwen3.8-27B. Según datos oficiales, este enfoque aumenta la precisión en más de un 10 % en comparación con otros métodos de cuantificación habituales con el mismo tamaño de archivo, lo que ofrece un rendimiento excepcional en pruebas de referencia clave como Div-300 y KLD (divergencia KL).
Esta actualización va más allá de la simple compresión. Al aprovechar técnicas mejoradas de cuantificación posteriores al entrenamiento, conserva mejor la calidad de salida del modelo original, acercándose mucho al rendimiento de precisión completa en tareas de codificación de agentes inteligentes, diálogo y multilingüismo. Los archivos GGUF correspondientes ya están disponibles en Hugging Face y son compatibles con herramientas de inferencia habituales, como llama.cpp y Unsloth Desktop.
Versión de cuantificación de 1 bit: funciona con 8 GB de memoria
Cabe destacar que Unsloth también ha lanzado una versión con cuantificación de 1 bit. Esta variante conserva aproximadamente un 77 % de precisión al tiempo que reduce drásticamente los requisitos de recursos, lo que permite su funcionamiento en dispositivos con tan solo 8 GB de memoria. Algunas variantes ultracomprimidas (como UD-IQ1_S, de unos 6,2 GB) reducen el tamaño del archivo en aproximadamente un 89 % en comparación con la precisión completa, al tiempo que siguen ofreciendo un rendimiento aceptable.
Anteriormente, ejecutar un Qwen3.8-27B cuantificado a 4 bits solía requerir entre 16 y 19 GB de VRAM o memoria del sistema. Ahora, estas opciones de bajo número de bits permiten que los portátiles estándar y los dispositivos de consumo puedan experimentar con este modelo multimodal de 27 000 millones de parámetros.
Importancia para el ecosistema local de IA
Qwen3.8-27B es compatible de forma nativa con capacidades multimodales, cuenta con una ventana de contexto de 262 000 (ampliable a aproximadamente 1 millón de tokens) y destaca en escenarios de programación y flujos de trabajo de oficina. Con licencia Apache 2.0, se integra a la perfección con la cuantificación Dynamic V3 de Unsloth, lo que permite a los desarrolladores realizar inferencias y ajustes finos de forma local con mayor facilidad y una menor dependencia de la infraestructura en la nube.
AIbase considera que la colaboración positiva entre Tongyi Qianwen y Unsloth, junto con los dobles avances en precisión y eficiencia que ofrece Dynamic V3, marcan una nueva era en la localización de grandes modelos de código abierto. Los desarrolladores interesados pueden descargar los últimos archivos GGUF desde Hugging Face y consultar la documentación oficial de Unsloth para obtener guías de configuración.
Artículo relacionado
 OpenAI lanza GPT-6 Astra, lo que supone un gran paso hacia la inteligencia artificial general
OpenAI ha presentado oficialmente su nuevo modelo lingüístico de gran escala insignia, el GPT-6Astra. Durante una rueda de prensa, el presidente de la empresa, Greg Brockman, elogió enormemente el mod
Wayve lanza una oferta pública de adquisición para sus empleados por valor de 85 millones de dólares, con una valoración de 8.5 mil millones de dólares
Wayve, una startup de tecnología de conducción autónoma con sede en el Reino Unido, está permitiendo a sus empleados vender una parte de sus acciones consolidadas a través de una oferta pública de adq
Sam Altman advierte de que no se debe afirmar que Claude es consciente
Mustafa Suleyman, director de IA de Microsoft, calificó recientemente de «muy peligrosa» la hipótesis de Anthropic de que su modelo de lenguaje a gran escala, Claude, posee conciencia, durante su inte
Recomendaciones de temas especiales relacionados
Creación de animación
 Los mejores generadores de sincronización labial con IA para escenas de diálogo
¡Ya están aquí, en XIX.AI, los mejores generadores de sincronización labial con IA mejor valorados de 2026 para escenas de diálogo! Esta selección incluye potentes herramientas revolucionarias que ofrecen movimientos labiales sincronizados a la perfección para cualquier guion, lo que aumenta considerablemente la eficiencia en la edición de vídeo. Disfruta de una comparación entre las opciones gratuitas y de pago, junto con pruebas reales y clasificaciones actualizadas semanalmente, que te ayudarán a encontrar la opción perfecta que no te puedes perder. ¡Explora ahora mismo y descubre tu ventaja con la IA!
 8 herramientas
 xix.ai
Inmediato
Optimizadores de indicaciones para IA: perfecciona las instrucciones para obtener una mejor calidad de resultados
¡Los mejores optimizadores de prompts de IA de 2026, seleccionados para ofrecer la máxima calidad de resultados! XIX.AI ofrece potentes soluciones revolucionarias que te ayudan a perfeccionar las instrucciones sin esfuerzo, aumentar la eficiencia en la redacción y obtener resultados de mayor calidad en todo momento. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente. ¡Explora ahora para descubrir tu herramienta perfecta y sacar el máximo partido a tu IA!
16 herramientas
xix.ai
Creación de animación
Herramientas de movimiento de Runway AI para storyboards publicitarios, escenas de personajes y prototipos visuales
2026 Últimas Mejores Herramientas de Movimiento de IA para Pasarela Opciones destacadas seleccionadas y poderosas que cambian las reglas del juego para crear storyboards publicitarios, escenas de personajes y prototipos visuales mediante pruebas en el mundo real. Clasificaciones comparativas semanales actualizadas entre versiones gratuitas y de pago. Ayúdanos a aumentar significativamente la productividad. Explora ahora
9 herramientas
xix.ai
Investigación Académica
Herramientas de búsqueda de conjuntos de datos de IA para proyectos académicos
¡Las mejores herramientas de 2026 para descubrir conjuntos de datos de IA mejor valoradas para proyectos académicos! XIX.AI ha seleccionado una colección de opciones potentes y revolucionarias, todas ellas altamente fiables, sometidas a rigurosas pruebas en el mundo real y actualizadas semanalmente. Encontrarás información detallada que compara las versiones gratuitas con las de pago para ayudarte a elegir la herramienta perfecta que potencie la eficiencia de tu investigación y ofrezca resultados de máxima calidad. ¡Explora ahora mismo y descubre tu ventaja en IA!
16 herramientas
xix.ai
Redes Sociales
Los mejores generadores de pies de foto con IA: redacta rápidamente publicaciones para redes sociales adaptadas a cada plataforma
¡Página con los mejores generadores de pies de foto con IA de 2026! XIX.AI ha elaborado una lista de las herramientas más valoradas y potentes que no te puedes perder para redactar rápidamente publicaciones en redes sociales específicas para cada plataforma. Estas herramientas se someten a rigurosas pruebas en condiciones reales y ofrecen comparativas entre versiones gratuitas y de pago, así como clasificaciones claras, para ayudarte a encontrar la mejor opción que impulse tu productividad y te permita sacar el máximo partido a la IA. ¡Échales un vistazo ahora!
11 herramientas
xix.ai
Salud y bienestar
Las mejores herramientas de coaching del sueño basadas en IA para trabajadores por turnos, la recuperación del jet lag y la mejora de las rutinas
¡Las mejores herramientas de 2026 basadas en IA para el entrenamiento del sueño, destinadas a trabajadores por turnos, la recuperación del jet lag y la mejora de las rutinas! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que se someten a pruebas en el mundo real para ofrecer una orientación precisa. Encontrarás información detallada que compara las versiones gratuitas con las de pago y podrás ver cómo estas soluciones imprescindibles ayudan a mejorar la calidad del sueño, acelerar la recuperación del jet lag y crear rutinas más saludables. ¡Explora ahora mismo y descubre tu herramienta perfecta!
7 herramientas
xix.ai

 comentario (0)
0/500
Tongyi Qianwen (Qwen) ha agradecido recientemente y de forma pública al equipo de Unsloth por lanzar la versión cuantificada Qwen3.8-27B GGUF, elogiándola por ser «más pequeña y más inteligente». Este intercambio ha suscitado un amplio debate en la comunidad de código abierto, lo que pone de relieve cómo se están reduciendo progresivamente las barreras para la implementación local de modelos de gran tamaño.
Interacción oficial: Tongyi Qianwen da las gracias a Unsloth
En su comunicado oficial, Tongyi Qianwen expresó su sincero agradecimiento por el trabajo de Unsloth, calificándolo de excelente noticia para la comunidad y animando a los usuarios a probar esta versión «más pequeña y más inteligente» de Qwen3.8-27B. Esta iniciativa pone de relieve la creciente sinergia entre los desarrolladores de modelos de código abierto y los proveedores de optimización de cuantificación.
Actualización importante de la cuantificación Dynamic V3 de Unsloth
La última solución de cuantificación Dynamic V3 (v3.0) de Unsloth está optimizada específicamente para Qwen3.8-27B. Según datos oficiales, este enfoque aumenta la precisión en más de un 10 % en comparación con otros métodos de cuantificación habituales con el mismo tamaño de archivo, lo que ofrece un rendimiento excepcional en pruebas de referencia clave como Div-300 y KLD (divergencia KL).
Esta actualización va más allá de la simple compresión. Al aprovechar técnicas mejoradas de cuantificación posteriores al entrenamiento, conserva mejor la calidad de salida del modelo original, acercándose mucho al rendimiento de precisión completa en tareas de codificación de agentes inteligentes, diálogo y multilingüismo. Los archivos GGUF correspondientes ya están disponibles en Hugging Face y son compatibles con herramientas de inferencia habituales, como llama.cpp y Unsloth Desktop.
Versión de cuantificación de 1 bit: funciona con 8 GB de memoria
Cabe destacar que Unsloth también ha lanzado una versión con cuantificación de 1 bit. Esta variante conserva aproximadamente un 77 % de precisión al tiempo que reduce drásticamente los requisitos de recursos, lo que permite su funcionamiento en dispositivos con tan solo 8 GB de memoria. Algunas variantes ultracomprimidas (como UD-IQ1_S, de unos 6,2 GB) reducen el tamaño del archivo en aproximadamente un 89 % en comparación con la precisión completa, al tiempo que siguen ofreciendo un rendimiento aceptable.
Anteriormente, ejecutar un Qwen3.8-27B cuantificado a 4 bits solía requerir entre 16 y 19 GB de VRAM o memoria del sistema. Ahora, estas opciones de bajo número de bits permiten que los portátiles estándar y los dispositivos de consumo puedan experimentar con este modelo multimodal de 27 000 millones de parámetros.
Importancia para el ecosistema local de IA
Qwen3.8-27B es compatible de forma nativa con capacidades multimodales, cuenta con una ventana de contexto de 262 000 (ampliable a aproximadamente 1 millón de tokens) y destaca en escenarios de programación y flujos de trabajo de oficina. Con licencia Apache 2.0, se integra a la perfección con la cuantificación Dynamic V3 de Unsloth, lo que permite a los desarrolladores realizar inferencias y ajustes finos de forma local con mayor facilidad y una menor dependencia de la infraestructura en la nube.
AIbase considera que la colaboración positiva entre Tongyi Qianwen y Unsloth, junto con los dobles avances en precisión y eficiencia que ofrece Dynamic V3, marcan una nueva era en la localización de grandes modelos de código abierto. Los desarrolladores interesados pueden descargar los últimos archivos GGUF desde Hugging Face y consultar la documentación oficial de Unsloth para obtener guías de configuración.








 OpenAI lanza GPT-6 Astra, lo que supone un gran paso hacia la inteligencia artificial general
OpenAI ha presentado oficialmente su nuevo modelo lingüístico de gran escala insignia, el GPT-6Astra. Durante una rueda de prensa, el presidente de la empresa, Greg Brockman, elogió enormemente el mod
 Wayve lanza una oferta pública de adquisición para sus empleados por valor de 85 millones de dólares, con una valoración de 8.5 mil millones de dólares
Wayve, una startup de tecnología de conducción autónoma con sede en el Reino Unido, está permitiendo a sus empleados vender una parte de sus acciones consolidadas a través de una oferta pública de adq
 Sam Altman advierte de que no se debe afirmar que Claude es consciente
Mustafa Suleyman, director de IA de Microsoft, calificó recientemente de «muy peligrosa» la hipótesis de Anthropic de que su modelo de lenguaje a gran escala, Claude, posee conciencia, durante su inte
¡Ya están aquí, en XIX.AI, los mejores generadores de sincronización labial con IA mejor valorados de 2026 para escenas de diálogo! Esta selección incluye potentes herramientas revolucionarias que ofrecen movimientos labiales sincronizados a la perfección para cualquier guion, lo que aumenta considerablemente la eficiencia en la edición de vídeo. Disfruta de una comparación entre las opciones gratuitas y de pago, junto con pruebas reales y clasificaciones actualizadas semanalmente, que te ayudarán a encontrar la opción perfecta que no te puedes perder. ¡Explora ahora mismo y descubre tu ventaja con la IA!
8 herramientas
xix.ai
¡Los mejores optimizadores de prompts de IA de 2026, seleccionados para ofrecer la máxima calidad de resultados! XIX.AI ofrece potentes soluciones revolucionarias que te ayudan a perfeccionar las instrucciones sin esfuerzo, aumentar la eficiencia en la redacción y obtener resultados de mayor calidad en todo momento. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente. ¡Explora ahora para descubrir tu herramienta perfecta y sacar el máximo partido a tu IA!
16 herramientas
xix.ai
2026 Últimas Mejores Herramientas de Movimiento de IA para Pasarela Opciones destacadas seleccionadas y poderosas que cambian las reglas del juego para crear storyboards publicitarios, escenas de personajes y prototipos visuales mediante pruebas en el mundo real. Clasificaciones comparativas semanales actualizadas entre versiones gratuitas y de pago. Ayúdanos a aumentar significativamente la productividad. Explora ahora
9 herramientas
xix.ai
¡Las mejores herramientas de 2026 para descubrir conjuntos de datos de IA mejor valoradas para proyectos académicos! XIX.AI ha seleccionado una colección de opciones potentes y revolucionarias, todas ellas altamente fiables, sometidas a rigurosas pruebas en el mundo real y actualizadas semanalmente. Encontrarás información detallada que compara las versiones gratuitas con las de pago para ayudarte a elegir la herramienta perfecta que potencie la eficiencia de tu investigación y ofrezca resultados de máxima calidad. ¡Explora ahora mismo y descubre tu ventaja en IA!
16 herramientas
xix.ai
¡Página con los mejores generadores de pies de foto con IA de 2026! XIX.AI ha elaborado una lista de las herramientas más valoradas y potentes que no te puedes perder para redactar rápidamente publicaciones en redes sociales específicas para cada plataforma. Estas herramientas se someten a rigurosas pruebas en condiciones reales y ofrecen comparativas entre versiones gratuitas y de pago, así como clasificaciones claras, para ayudarte a encontrar la mejor opción que impulse tu productividad y te permita sacar el máximo partido a la IA. ¡Échales un vistazo ahora!
11 herramientas
xix.ai

¡Las mejores herramientas de 2026 basadas en IA para el entrenamiento del sueño, destinadas a trabajadores por turnos, la recuperación del jet lag y la mejora de las rutinas! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que se someten a pruebas en el mundo real para ofrecer una orientación precisa. Encontrarás información detallada que compara las versiones gratuitas con las de pago y podrás ver cómo estas soluciones imprescindibles ayudan a mejorar la calidad del sueño, acelerar la recuperación del jet lag y crear rutinas más saludables. ¡Explora ahora mismo y descubre tu herramienta perfecta!
7 herramientas
xix.ai












