


 Lar
O suporte oficial ao Tongyi Qianwen chega com o Unsloth Dynamic V3 reduzindo o Qwen3.8-27B a uma versão de 1 bit rodando em 8 GB de memória
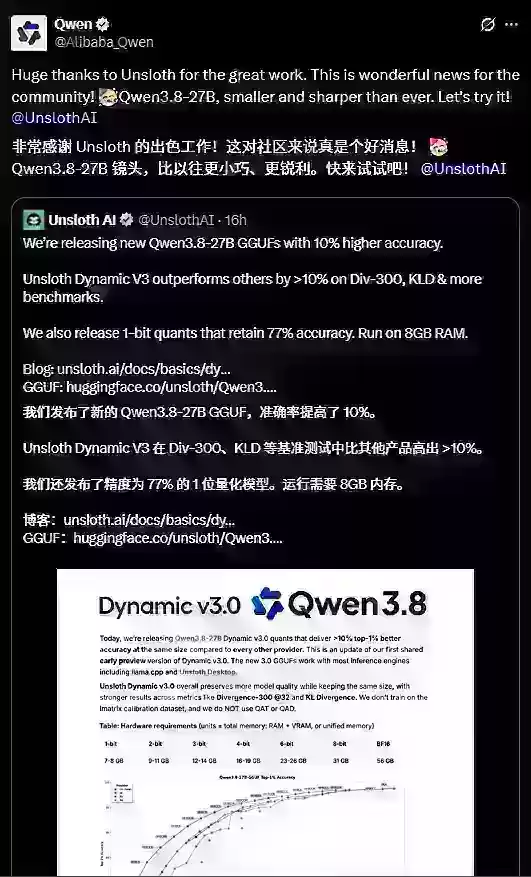
Tongyi Qianwen (Qwen) recentemente agradeceu publicamente à equipe do Unsloth pelo lançamento da versão quantizada Qwen3.8-27B GGUF, elogiando-a como “menor e mais inteligente”. Essa troca de mensagens gerou uma ampla discussão na comunidade de código aberto, destacando a redução constante das barreiras para a implantação local de grandes modelos.
Interação oficial: Tongyi Qianwen agradece à Unsloth
Em seu comunicado oficial, a Tongyi Qianwen expressou sincero agradecimento pelo trabalho da Unsloth, classificando-o como uma excelente notícia para a comunidade e incentivando os usuários a experimentarem essa versão “menor e mais inteligente” do Qwen3.8-27B. Essa iniciativa destaca a crescente sinergia entre desenvolvedores de modelos de código aberto e provedores de otimização de quantização.
Grande atualização da quantização Dynamic V3 da Unsloth
A mais recente solução de quantização Dynamic V3 (v3.0) da Unsloth foi otimizada especificamente para o Qwen3.8-27B. De acordo com dados oficiais, essa abordagem aumenta a precisão em mais de 10% em comparação com outros métodos de quantização convencionais com o mesmo tamanho de arquivo, proporcionando desempenho excepcional em benchmarks importantes, como Div-300 e KLD (KL Divergence).
Essa atualização vai além da simples compressão. Ao aproveitar técnicas aprimoradas de quantização pós-treinamento, ela preserva melhor a qualidade de saída do modelo original, aproximando-se do desempenho de precisão total em tarefas de codificação de agentes inteligentes, diálogo e multilínguas. Os arquivos GGUF correspondentes já estão disponíveis no Hugging Face e são compatíveis com ferramentas de inferência convencionais, como llama.cpp e Unsloth Desktop.
Versão com quantização de 1 bit: roda com 8 GB de memória
Notavelmente, a Unsloth também lançou uma versão com quantização de 1 bit. Essa variante mantém aproximadamente 77% da precisão ao mesmo tempo em que reduz drasticamente as demandas de recursos, permitindo a operação em dispositivos com apenas 8 GB de memória. Algumas variantes ultracomprimidas (como o UD-IQ1_S, com cerca de 6,2 GB) reduzem o tamanho do arquivo em aproximadamente 89% em comparação com a precisão total, sem deixar de oferecer desempenho utilizável.
Anteriormente, a execução de um Qwen3.8-27B quantizado a 4 bits normalmente exigia de 16 a 19 GB de VRAM ou memória do sistema. Agora, essas opções de baixo número de bits tornam possível que laptops comuns e dispositivos de consumo experimentem esse modelo multimodal de 27 bilhões de parâmetros.
Importância para o ecossistema local de IA
O Qwen3.8-27B oferece suporte nativo a recursos multimodais, possui uma janela de contexto de 262 mil (expansível para aproximadamente 1 milhão de tokens) e se destaca em cenários de programação e fluxos de trabalho de escritório. Licenciado sob a licença Apache 2.0, ele se integra perfeitamente à quantização Dynamic V3 da Unsloth, permitindo que desenvolvedores realizem inferência e ajuste fino localmente com maior facilidade e menor dependência da infraestrutura em nuvem.
A AIbase considera que a colaboração positiva entre a Tongyi Qianwen e a Unsloth, juntamente com os avanços duplos em precisão e eficiência oferecidos pelo Dynamic V3, marcam uma nova era na localização de grandes modelos de código aberto. Desenvolvedores interessados podem baixar os arquivos GGUF mais recentes no Hugging Face e consultar a documentação oficial da Unsloth para obter guias de configuração.
Artigo relacionado
 A OpenAI lança o GPT-6 Astra, marcando um grande passo em direção à inteligência artificial geral
A OpenAI apresentou oficialmente seu mais novo modelo de linguagem de grande porte, o GPT-6Astra. Durante uma coletiva de imprensa, o presidente da empresa, Greg Brockman, elogiou amplamente o modelo,
A Wayve lança uma oferta pública de aquisição de ações dos funcionários no valor de US$ 85 milhões, com uma avaliação de US$ 8,5 bilhões
A Wayve, uma startup de tecnologia de direção autônoma sediada no Reino Unido, está permitindo que seus funcionários vendam uma parte de suas ações adquiridas por meio de uma oferta pública de aquisiç
Sam Altman adverte contra a ideia de que Claude seja consciente
Mustafa Suleyman, diretor de IA da Microsoft, classificou recentemente como “altamente perigosa” a especulação da Anthropic de que seu modelo de linguagem de grande escala, o Claude, possuiria consciê
Recomendações de tópicos especiais relacionados
Criação de Animação
 Os melhores geradores de sincronização labial com IA para cenas de diálogo
Os melhores e mais bem avaliados geradores de sincronização labial com IA para cenas de diálogo de 2026 já estão disponíveis no XIX.AI! Esta coleção cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que proporcionam movimentos labiais sincronizados de forma impecável para qualquer roteiro, aumentando significativamente a eficiência da sua edição de vídeo. Aproveite uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a opção perfeita que você não pode deixar de experimentar. Explore agora para descobrir sua vantagem com a IA!
 8 ferramentas
 xix.ai
Incitar
Otimizadores de prompts de IA: refine as instruções para obter uma melhor qualidade de saída
Os melhores otimizadores de prompts de IA de 2026, com as melhores avaliações, selecionados para garantir a máxima qualidade de saída! A XIX.AI oferece soluções poderosas e revolucionárias que ajudam você a refinar instruções sem esforço, aumentar a eficiência na redação e obter resultados de maior qualidade sempre. Veja uma comparação entre as versões gratuita e paga, além de testes práticos e rankings atualizados semanalmente. Explore agora para descobrir sua ferramenta perfeita e aproveitar ao máximo sua vantagem com a IA!
16 ferramentas
xix.ai
Criação de Animação
Ferramentas de Movimento do Runway AI para Storyboards de Anúncios, Cenas de Personagens e Protótipos Visuais
2026 Últimas Melhores Ferramentas de Movimento por IA para Passarela Opções poderosas e transformadoras, cuidadosamente selecionadas e de alta avaliação, para criar storyboards de anúncios, cenas de personagens e protótipos visuais por meio de testes do mundo real. Rankings semanais atualizados comparando opções gratuitas e pagas. Ajude você a aumentar significativamente a produtividade. Explore agora.
9 ferramentas
xix.ai
Pesquisa Acadêmica
Ferramentas de descoberta de conjuntos de dados de IA para projetos acadêmicos
As melhores e mais bem avaliadas ferramentas de 2026 para descoberta de conjuntos de dados de IA em projetos acadêmicos! A XIX.AI selecionou uma coleção poderosa e revolucionária de opções altamente confiáveis, todas submetidas a rigorosos testes práticos e atualizadas semanalmente. Você pode encontrar informações detalhadas comparativas entre versões gratuitas e pagas para ajudá-lo a escolher a ferramenta perfeita que aumentará a eficiência de sua pesquisa e proporcionará resultados da mais alta qualidade. Explore agora para descobrir sua vantagem em IA!
16 ferramentas
xix.ai
Mídias Sociais
Os melhores geradores de legendas com IA: crie rapidamente publicações nas redes sociais específicas para cada plataforma
Página com os melhores geradores de legendas com IA de 2026! A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas e poderosas que você não pode deixar de experimentar para escrever rapidamente publicações em redes sociais específicas para cada plataforma. Essas ferramentas passam por testes rigorosos em condições reais, oferecendo comparações entre versões gratuitas e pagas, além de classificações claras para ajudar você a encontrar a melhor opção que aumente sua produtividade e aproveite ao máximo as vantagens da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
As melhores ferramentas de orientação para o sono com IA para trabalhadores em turnos, recuperação do jet lag e rotinas mais saudáveis
As melhores e mais recentes ferramentas de coaching de sono com IA de 2026 para trabalhadores em turnos, recuperação do jet lag e rotinas mais saudáveis! A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas e revolucionárias, que passam por testes na prática para oferecer orientações precisas. Você pode encontrar informações detalhadas comparando as versões gratuitas e pagas e ver como essas soluções imperdíveis ajudam a melhorar a qualidade do sono, acelerar a recuperação do jet lag e criar rotinas mais saudáveis. Explore agora para descobrir a ferramenta perfeita para você!
7 ferramentas
xix.ai

 Comentários (0)
Tongyi Qianwen (Qwen) recentemente agradeceu publicamente à equipe do Unsloth pelo lançamento da versão quantizada Qwen3.8-27B GGUF, elogiando-a como “menor e mais inteligente”. Essa troca de mensagens gerou uma ampla discussão na comunidade de código aberto, destacando a redução constante das barreiras para a implantação local de grandes modelos.
Interação oficial: Tongyi Qianwen agradece à Unsloth
Em seu comunicado oficial, a Tongyi Qianwen expressou sincero agradecimento pelo trabalho da Unsloth, classificando-o como uma excelente notícia para a comunidade e incentivando os usuários a experimentarem essa versão “menor e mais inteligente” do Qwen3.8-27B. Essa iniciativa destaca a crescente sinergia entre desenvolvedores de modelos de código aberto e provedores de otimização de quantização.
Grande atualização da quantização Dynamic V3 da Unsloth
A mais recente solução de quantização Dynamic V3 (v3.0) da Unsloth foi otimizada especificamente para o Qwen3.8-27B. De acordo com dados oficiais, essa abordagem aumenta a precisão em mais de 10% em comparação com outros métodos de quantização convencionais com o mesmo tamanho de arquivo, proporcionando desempenho excepcional em benchmarks importantes, como Div-300 e KLD (KL Divergence).
Essa atualização vai além da simples compressão. Ao aproveitar técnicas aprimoradas de quantização pós-treinamento, ela preserva melhor a qualidade de saída do modelo original, aproximando-se do desempenho de precisão total em tarefas de codificação de agentes inteligentes, diálogo e multilínguas. Os arquivos GGUF correspondentes já estão disponíveis no Hugging Face e são compatíveis com ferramentas de inferência convencionais, como llama.cpp e Unsloth Desktop.
Versão com quantização de 1 bit: roda com 8 GB de memória
Notavelmente, a Unsloth também lançou uma versão com quantização de 1 bit. Essa variante mantém aproximadamente 77% da precisão ao mesmo tempo em que reduz drasticamente as demandas de recursos, permitindo a operação em dispositivos com apenas 8 GB de memória. Algumas variantes ultracomprimidas (como o UD-IQ1_S, com cerca de 6,2 GB) reduzem o tamanho do arquivo em aproximadamente 89% em comparação com a precisão total, sem deixar de oferecer desempenho utilizável.
Anteriormente, a execução de um Qwen3.8-27B quantizado a 4 bits normalmente exigia de 16 a 19 GB de VRAM ou memória do sistema. Agora, essas opções de baixo número de bits tornam possível que laptops comuns e dispositivos de consumo experimentem esse modelo multimodal de 27 bilhões de parâmetros.
Importância para o ecossistema local de IA
O Qwen3.8-27B oferece suporte nativo a recursos multimodais, possui uma janela de contexto de 262 mil (expansível para aproximadamente 1 milhão de tokens) e se destaca em cenários de programação e fluxos de trabalho de escritório. Licenciado sob a licença Apache 2.0, ele se integra perfeitamente à quantização Dynamic V3 da Unsloth, permitindo que desenvolvedores realizem inferência e ajuste fino localmente com maior facilidade e menor dependência da infraestrutura em nuvem.
A AIbase considera que a colaboração positiva entre a Tongyi Qianwen e a Unsloth, juntamente com os avanços duplos em precisão e eficiência oferecidos pelo Dynamic V3, marcam uma nova era na localização de grandes modelos de código aberto. Desenvolvedores interessados podem baixar os arquivos GGUF mais recentes no Hugging Face e consultar a documentação oficial da Unsloth para obter guias de configuração.








 A OpenAI lança o GPT-6 Astra, marcando um grande passo em direção à inteligência artificial geral
A OpenAI apresentou oficialmente seu mais novo modelo de linguagem de grande porte, o GPT-6Astra. Durante uma coletiva de imprensa, o presidente da empresa, Greg Brockman, elogiou amplamente o modelo,
 A Wayve lança uma oferta pública de aquisição de ações dos funcionários no valor de US$ 85 milhões, com uma avaliação de US$ 8,5 bilhões
A Wayve, uma startup de tecnologia de direção autônoma sediada no Reino Unido, está permitindo que seus funcionários vendam uma parte de suas ações adquiridas por meio de uma oferta pública de aquisiç
 Sam Altman adverte contra a ideia de que Claude seja consciente
Mustafa Suleyman, diretor de IA da Microsoft, classificou recentemente como “altamente perigosa” a especulação da Anthropic de que seu modelo de linguagem de grande escala, o Claude, possuiria consciê
Os melhores e mais bem avaliados geradores de sincronização labial com IA para cenas de diálogo de 2026 já estão disponíveis no XIX.AI! Esta coleção cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que proporcionam movimentos labiais sincronizados de forma impecável para qualquer roteiro, aumentando significativamente a eficiência da sua edição de vídeo. Aproveite uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a opção perfeita que você não pode deixar de experimentar. Explore agora para descobrir sua vantagem com a IA!
8 ferramentas
xix.ai
Os melhores otimizadores de prompts de IA de 2026, com as melhores avaliações, selecionados para garantir a máxima qualidade de saída! A XIX.AI oferece soluções poderosas e revolucionárias que ajudam você a refinar instruções sem esforço, aumentar a eficiência na redação e obter resultados de maior qualidade sempre. Veja uma comparação entre as versões gratuita e paga, além de testes práticos e rankings atualizados semanalmente. Explore agora para descobrir sua ferramenta perfeita e aproveitar ao máximo sua vantagem com a IA!
16 ferramentas
xix.ai
2026 Últimas Melhores Ferramentas de Movimento por IA para Passarela Opções poderosas e transformadoras, cuidadosamente selecionadas e de alta avaliação, para criar storyboards de anúncios, cenas de personagens e protótipos visuais por meio de testes do mundo real. Rankings semanais atualizados comparando opções gratuitas e pagas. Ajude você a aumentar significativamente a produtividade. Explore agora.
9 ferramentas
xix.ai
As melhores e mais bem avaliadas ferramentas de 2026 para descoberta de conjuntos de dados de IA em projetos acadêmicos! A XIX.AI selecionou uma coleção poderosa e revolucionária de opções altamente confiáveis, todas submetidas a rigorosos testes práticos e atualizadas semanalmente. Você pode encontrar informações detalhadas comparativas entre versões gratuitas e pagas para ajudá-lo a escolher a ferramenta perfeita que aumentará a eficiência de sua pesquisa e proporcionará resultados da mais alta qualidade. Explore agora para descobrir sua vantagem em IA!
16 ferramentas
xix.ai
Página com os melhores geradores de legendas com IA de 2026! A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas e poderosas que você não pode deixar de experimentar para escrever rapidamente publicações em redes sociais específicas para cada plataforma. Essas ferramentas passam por testes rigorosos em condições reais, oferecendo comparações entre versões gratuitas e pagas, além de classificações claras para ajudar você a encontrar a melhor opção que aumente sua produtividade e aproveite ao máximo as vantagens da IA. Explore agora!
11 ferramentas
xix.ai

As melhores e mais recentes ferramentas de coaching de sono com IA de 2026 para trabalhadores em turnos, recuperação do jet lag e rotinas mais saudáveis! A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas e revolucionárias, que passam por testes na prática para oferecer orientações precisas. Você pode encontrar informações detalhadas comparando as versões gratuitas e pagas e ver como essas soluções imperdíveis ajudam a melhorar a qualidade do sono, acelerar a recuperação do jet lag e criar rotinas mais saudáveis. Explore agora para descobrir a ferramenta perfeita para você!
7 ferramentas
xix.ai












