


 Heim
Offizielle Unterstützung für Tongyi Qianwen: Unsloth Dynamic V3 verkleinert Qwen3.8-27B und lässt eine 1-Bit-Version auf 8 GB Arbeitsspeicher laufen
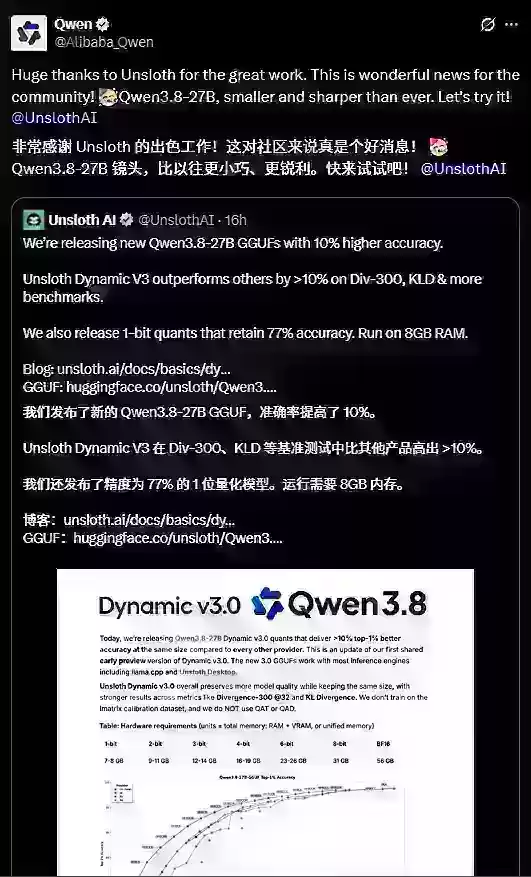
Tongyi Qianwen (Qwen) hat kürzlich dem Unsloth-Team öffentlich für die Veröffentlichung der quantisierten Version „Qwen3.8-27B GGUF“ gedankt und diese als „kleiner und intelligenter“ gelobt. Dieser Austausch hat in der Open-Source-Community eine breite Diskussion ausgelöst und unterstreicht, dass die Hürden für den lokalen Einsatz großer Modelle stetig sinken.
Offizieller Austausch: Tongyi Qianwen dankt Unsloth
In seiner offiziellen Stellungnahme drückte Tongyi Qianwen seine aufrichtige Wertschätzung für die Arbeit von Unsloth aus, bezeichnete dies als hervorragende Nachricht für die Community und ermutigte die Nutzer, diese „kleinere und intelligentere“ Qwen3.8-27B-Version auszuprobieren. Dieser Schritt unterstreicht die wachsende Synergie zwischen Open-Source-Modellentwicklern und Anbietern von Quantisierungsoptimierungen.
Unsloth Dynamic V3: Umfassendes Upgrade der Quantisierungslösung
Die neueste „Dynamic V3“ (v3.0)-Quantisierungslösung von Unsloth ist speziell für Qwen3.8-27B optimiert. Offiziellen Angaben zufolge steigert dieser Ansatz die Genauigkeit um über 10 % im Vergleich zu anderen gängigen Quantisierungsmethoden bei gleicher Dateigröße und liefert außergewöhnliche Leistung bei wichtigen Benchmarks wie Div-300 und KLD (KL-Divergenz).
Dieses Upgrade geht über eine einfache Komprimierung hinaus. Durch den Einsatz verbesserter Quantisierungstechniken nach dem Training bewahrt es die Ausgabequalität des ursprünglichen Modells besser und kommt der Leistung bei voller Präzision in den Bereichen intelligente Agentenprogrammierung, Dialogführung und mehrsprachige Aufgaben sehr nahe. Die entsprechenden GGUF-Dateien sind ab sofort auf Hugging Face verfügbar und unterstützen gängige Inferenz-Tools wie llama.cpp und Unsloth Desktop.
1-Bit-Quantisierungsversion: Läuft mit 8 GB Arbeitsspeicher
Bemerkenswert ist, dass Unsloth auch eine 1-Bit-Quantisierungsversion veröffentlicht hat. Diese Variante behält etwa 77 % der Genauigkeit bei und senkt gleichzeitig den Ressourcenbedarf drastisch, sodass der Betrieb auf Geräten mit nur 8 GB Arbeitsspeicher möglich ist. Einige extrem komprimierte Varianten (wie UD-IQ1_S, ca. 6,2 GB) reduzieren die Dateigröße im Vergleich zur Vollpräzision um rund 89 % und liefern dennoch eine brauchbare Leistung.
Bisher waren für die Ausführung eines 4-Bit-quantisierten Qwen3.8-27B in der Regel 16–19 GB VRAM oder Systemspeicher erforderlich. Dank dieser Low-Bit-Optionen ist es nun auch mit handelsüblichen Laptops und Endgeräten möglich, mit diesem multimodalen Modell mit 27 Milliarden Parametern zu experimentieren.
Bedeutung für das lokale KI-Ökosystem
Qwen3.8-27B unterstützt von Haus aus multimodale Funktionen, verfügt über ein Kontextfenster von 262.000 Token (erweiterbar auf etwa 1 Million Token) und zeichnet sich in Szenarien des Programmierens und im Büro-Workflow aus. Es steht unter der Apache-2.0-Lizenz und lässt sich nahtlos mit der „Dynamic V3“-Quantisierung von Unsloth kombinieren, wodurch Entwickler Inferenz und Feinabstimmung lokaler durchführen können – und zwar mit größerer Leichtigkeit und geringerer Abhängigkeit von der Cloud-Infrastruktur.
AIbase betrachtet die positive Zusammenarbeit zwischen Tongyi Qianwen und Unsloth sowie die doppelten Durchbrüche bei Genauigkeit und Effizienz, die Dynamic V3 bietet, als Meilenstein für eine neue Ära bei der Lokalisierung von Open-Source-Großmodellen. Interessierte Entwickler können die neuesten GGUF-Dateien von Hugging Face herunterladen und in der offiziellen Dokumentation von Unsloth nach Anleitungen zur Einrichtung suchen.
Verwandter Artikel
 OpenAI bringt GPT-6 Astra auf den Markt und macht damit einen großen Schritt in Richtung allgemeiner künstlicher Intelligenz
OpenAI hat offiziell sein neuestes Flaggschiff unter den großen Sprachmodellen vorgestellt: GPT-6Astra. Bei einer Pressekonferenz lobte Unternehmenspräsident Greg Brockman das Modell in den höchsten T
Wayve startet ein Übernahmeangebot für Mitarbeiter im Wert von 85 Millionen US-Dollar bei einer Unternehmensbewertung von 8,5 Milliarden US-Dollar
Wayve, ein in Großbritannien ansässiges Start-up für autonome Fahrtechnologie, ermöglicht es seinen Mitarbeitern, einen Teil ihrer unverfallbaren Anteile im Rahmen eines Rückkaufangebots in Höhe von 8
Sam Altman warnt davor, zu behaupten, Claude sei bei Bewusstsein
Mustafa Suleyman, der KI-Chef von Microsoft, bezeichnete kürzlich in einer Folge des „Decoder“-Podcasts die Spekulation von Anthropic, dass dessen großes Sprachmodell „Claude“ über Bewusstsein verfüge
Empfehlungen zu verwandten Spezialthemen
Animationserstellung
 Die besten KI-Generatoren für Lippensynchronisation in Dialogszenen
Die neuesten und am besten bewerteten KI-Generatoren für Lippensynchronisation in Dialogszenen des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die für jedes Drehbuch makellos synchronisierte Lippenbewegungen liefern und so die Effizienz Ihrer Videobearbeitung erheblich steigern. Profitieren Sie von einem Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie von Praxistests und wöchentlich aktualisierten Rankings, die Ihnen helfen, das perfekte Tool zu finden, das Sie unbedingt ausprobieren sollten. Entdecken Sie es jetzt und sichern Sie sich Ihren KI-Vorteil!
 8 Tools
 xix.ai
Prompt
KI-Prompt-Optimierer: Anweisungen verfeinern für eine bessere Ausgabequalität
2026: Die neuesten, besten und am besten bewerteten KI-Prompt-Optimierer – sorgfältig ausgewählt für maximale Ausgabequalität! XIX.AI bietet leistungsstarke, bahnbrechende Lösungen, mit denen Sie Anweisungen mühelos verfeinern, Ihre Schreibeffizienz steigern und jedes Mal qualitativ hochwertigere Ergebnisse erzielen können. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Tests aus der Praxis und wöchentlich aktualisierte Rankings. Entdecken Sie jetzt Ihr perfektes Tool und nutzen Sie Ihren KI-Vorteil!
16 Tools
xix.ai
Animationserstellung
Runway KI-Bewegungstools für Werbegeschichten, Charakter-Szenen und visuelle Prototypen
2026 Neueste Beste KI-Bewegungstools für Laufsteg Top-bewertete kuratierte leistungsstarke, bahnbrechende Optionen zur Erstellung von Storyboards für Werbegeschichten, Charakter szenen und visuelle Prototypen durch reale Tests. Wöchentlich aktualisierte kostenlose vs. kostenpflichtige Vergleichsrankings. Helfen Sie, die Produktivität erheblich zu steigern. Jetzt erkunden.
9 Tools
xix.ai
Akademische Forschung
Tools zur Suche nach KI-Datensätzen für akademische Projekte
Die besten und am besten bewerteten Tools zur Suche nach KI-Datensätzen für akademische Projekte im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung äußerst zuverlässiger Optionen zusammengestellt, die alle strengen Praxistests unterzogen und wöchentlich aktualisiert werden. Hier finden Sie detaillierte Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten, die Ihnen helfen, das perfekte Tool auszuwählen, das Ihre Forschungseffizienz steigert und Ergebnisse von höchster Qualität liefert. Entdecken Sie die Auswahl jetzt und sichern Sie sich Ihren KI-Vorteil!
16 Tools
xix.ai
Soziale Medien
Die besten KI-Generatoren für Bildunterschriften: Plattformspezifische Social-Media-Beiträge schnell verfassen
Seite mit den besten KI-Bildunterschriften-Generatoren 2026! XIX.AI hat eine Liste der besten Tools zusammengestellt, die Sie unbedingt ausprobieren sollten, um plattformspezifische Social-Media-Beiträge schnell zu verfassen. Diese Tools durchlaufen strenge Praxistests und bieten einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie klare Ranglisten, damit Sie die beste Option finden, die Ihre Produktivität steigert und Ihren KI-Vorteil voll ausschöpft. Entdecken Sie sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
Die besten KI-basierten Schlafcoaching-Tools für Schichtarbeiter, zur Erholung nach Jetlag und für bessere Routinen
Die besten KI-Tools für Schlafcoaching im Jahr 2026: Für Schichtarbeiter, zur Bewältigung von Jetlag und für bessere Routinen! XIX.AI hat eine Liste der besten Tools zusammengestellt, die bahnbrechend sind und in der Praxis getestet wurden, um präzise Anleitungen zu liefern. Hier finden Sie detaillierte Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten und erfahren, wie diese unverzichtbaren Lösungen dazu beitragen, die Schlafqualität zu verbessern, die Erholung vom Jetlag zu beschleunigen und gesündere Routinen zu etablieren. Entdecken Sie jetzt das perfekte Tool für sich!
7 Tools
xix.ai

 Kommentare (0)
Tongyi Qianwen (Qwen) hat kürzlich dem Unsloth-Team öffentlich für die Veröffentlichung der quantisierten Version „Qwen3.8-27B GGUF“ gedankt und diese als „kleiner und intelligenter“ gelobt. Dieser Austausch hat in der Open-Source-Community eine breite Diskussion ausgelöst und unterstreicht, dass die Hürden für den lokalen Einsatz großer Modelle stetig sinken.
Offizieller Austausch: Tongyi Qianwen dankt Unsloth
In seiner offiziellen Stellungnahme drückte Tongyi Qianwen seine aufrichtige Wertschätzung für die Arbeit von Unsloth aus, bezeichnete dies als hervorragende Nachricht für die Community und ermutigte die Nutzer, diese „kleinere und intelligentere“ Qwen3.8-27B-Version auszuprobieren. Dieser Schritt unterstreicht die wachsende Synergie zwischen Open-Source-Modellentwicklern und Anbietern von Quantisierungsoptimierungen.
Unsloth Dynamic V3: Umfassendes Upgrade der Quantisierungslösung
Die neueste „Dynamic V3“ (v3.0)-Quantisierungslösung von Unsloth ist speziell für Qwen3.8-27B optimiert. Offiziellen Angaben zufolge steigert dieser Ansatz die Genauigkeit um über 10 % im Vergleich zu anderen gängigen Quantisierungsmethoden bei gleicher Dateigröße und liefert außergewöhnliche Leistung bei wichtigen Benchmarks wie Div-300 und KLD (KL-Divergenz).
Dieses Upgrade geht über eine einfache Komprimierung hinaus. Durch den Einsatz verbesserter Quantisierungstechniken nach dem Training bewahrt es die Ausgabequalität des ursprünglichen Modells besser und kommt der Leistung bei voller Präzision in den Bereichen intelligente Agentenprogrammierung, Dialogführung und mehrsprachige Aufgaben sehr nahe. Die entsprechenden GGUF-Dateien sind ab sofort auf Hugging Face verfügbar und unterstützen gängige Inferenz-Tools wie llama.cpp und Unsloth Desktop.
1-Bit-Quantisierungsversion: Läuft mit 8 GB Arbeitsspeicher
Bemerkenswert ist, dass Unsloth auch eine 1-Bit-Quantisierungsversion veröffentlicht hat. Diese Variante behält etwa 77 % der Genauigkeit bei und senkt gleichzeitig den Ressourcenbedarf drastisch, sodass der Betrieb auf Geräten mit nur 8 GB Arbeitsspeicher möglich ist. Einige extrem komprimierte Varianten (wie UD-IQ1_S, ca. 6,2 GB) reduzieren die Dateigröße im Vergleich zur Vollpräzision um rund 89 % und liefern dennoch eine brauchbare Leistung.
Bisher waren für die Ausführung eines 4-Bit-quantisierten Qwen3.8-27B in der Regel 16–19 GB VRAM oder Systemspeicher erforderlich. Dank dieser Low-Bit-Optionen ist es nun auch mit handelsüblichen Laptops und Endgeräten möglich, mit diesem multimodalen Modell mit 27 Milliarden Parametern zu experimentieren.
Bedeutung für das lokale KI-Ökosystem
Qwen3.8-27B unterstützt von Haus aus multimodale Funktionen, verfügt über ein Kontextfenster von 262.000 Token (erweiterbar auf etwa 1 Million Token) und zeichnet sich in Szenarien des Programmierens und im Büro-Workflow aus. Es steht unter der Apache-2.0-Lizenz und lässt sich nahtlos mit der „Dynamic V3“-Quantisierung von Unsloth kombinieren, wodurch Entwickler Inferenz und Feinabstimmung lokaler durchführen können – und zwar mit größerer Leichtigkeit und geringerer Abhängigkeit von der Cloud-Infrastruktur.
AIbase betrachtet die positive Zusammenarbeit zwischen Tongyi Qianwen und Unsloth sowie die doppelten Durchbrüche bei Genauigkeit und Effizienz, die Dynamic V3 bietet, als Meilenstein für eine neue Ära bei der Lokalisierung von Open-Source-Großmodellen. Interessierte Entwickler können die neuesten GGUF-Dateien von Hugging Face herunterladen und in der offiziellen Dokumentation von Unsloth nach Anleitungen zur Einrichtung suchen.








 OpenAI bringt GPT-6 Astra auf den Markt und macht damit einen großen Schritt in Richtung allgemeiner künstlicher Intelligenz
OpenAI hat offiziell sein neuestes Flaggschiff unter den großen Sprachmodellen vorgestellt: GPT-6Astra. Bei einer Pressekonferenz lobte Unternehmenspräsident Greg Brockman das Modell in den höchsten T
 Wayve startet ein Übernahmeangebot für Mitarbeiter im Wert von 85 Millionen US-Dollar bei einer Unternehmensbewertung von 8,5 Milliarden US-Dollar
Wayve, ein in Großbritannien ansässiges Start-up für autonome Fahrtechnologie, ermöglicht es seinen Mitarbeitern, einen Teil ihrer unverfallbaren Anteile im Rahmen eines Rückkaufangebots in Höhe von 8
 Sam Altman warnt davor, zu behaupten, Claude sei bei Bewusstsein
Mustafa Suleyman, der KI-Chef von Microsoft, bezeichnete kürzlich in einer Folge des „Decoder“-Podcasts die Spekulation von Anthropic, dass dessen großes Sprachmodell „Claude“ über Bewusstsein verfüge
Die neuesten und am besten bewerteten KI-Generatoren für Lippensynchronisation in Dialogszenen des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die für jedes Drehbuch makellos synchronisierte Lippenbewegungen liefern und so die Effizienz Ihrer Videobearbeitung erheblich steigern. Profitieren Sie von einem Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie von Praxistests und wöchentlich aktualisierten Rankings, die Ihnen helfen, das perfekte Tool zu finden, das Sie unbedingt ausprobieren sollten. Entdecken Sie es jetzt und sichern Sie sich Ihren KI-Vorteil!
8 Tools
xix.ai
2026: Die neuesten, besten und am besten bewerteten KI-Prompt-Optimierer – sorgfältig ausgewählt für maximale Ausgabequalität! XIX.AI bietet leistungsstarke, bahnbrechende Lösungen, mit denen Sie Anweisungen mühelos verfeinern, Ihre Schreibeffizienz steigern und jedes Mal qualitativ hochwertigere Ergebnisse erzielen können. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Tests aus der Praxis und wöchentlich aktualisierte Rankings. Entdecken Sie jetzt Ihr perfektes Tool und nutzen Sie Ihren KI-Vorteil!
16 Tools
xix.ai
2026 Neueste Beste KI-Bewegungstools für Laufsteg Top-bewertete kuratierte leistungsstarke, bahnbrechende Optionen zur Erstellung von Storyboards für Werbegeschichten, Charakter szenen und visuelle Prototypen durch reale Tests. Wöchentlich aktualisierte kostenlose vs. kostenpflichtige Vergleichsrankings. Helfen Sie, die Produktivität erheblich zu steigern. Jetzt erkunden.
9 Tools
xix.ai
Die besten und am besten bewerteten Tools zur Suche nach KI-Datensätzen für akademische Projekte im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung äußerst zuverlässiger Optionen zusammengestellt, die alle strengen Praxistests unterzogen und wöchentlich aktualisiert werden. Hier finden Sie detaillierte Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten, die Ihnen helfen, das perfekte Tool auszuwählen, das Ihre Forschungseffizienz steigert und Ergebnisse von höchster Qualität liefert. Entdecken Sie die Auswahl jetzt und sichern Sie sich Ihren KI-Vorteil!
16 Tools
xix.ai
Seite mit den besten KI-Bildunterschriften-Generatoren 2026! XIX.AI hat eine Liste der besten Tools zusammengestellt, die Sie unbedingt ausprobieren sollten, um plattformspezifische Social-Media-Beiträge schnell zu verfassen. Diese Tools durchlaufen strenge Praxistests und bieten einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie klare Ranglisten, damit Sie die beste Option finden, die Ihre Produktivität steigert und Ihren KI-Vorteil voll ausschöpft. Entdecken Sie sie jetzt!
11 Tools
xix.ai

Die besten KI-Tools für Schlafcoaching im Jahr 2026: Für Schichtarbeiter, zur Bewältigung von Jetlag und für bessere Routinen! XIX.AI hat eine Liste der besten Tools zusammengestellt, die bahnbrechend sind und in der Praxis getestet wurden, um präzise Anleitungen zu liefern. Hier finden Sie detaillierte Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten und erfahren, wie diese unverzichtbaren Lösungen dazu beitragen, die Schlafqualität zu verbessern, die Erholung vom Jetlag zu beschleunigen und gesündere Routinen zu etablieren. Entdecken Sie jetzt das perfekte Tool für sich!
7 Tools
xix.ai












