


 Heim
OpenAI verbessert seine Transkriptions- und Sprach-generierende KI-Modelle
OpenAI führt neue KI-Modelle für Transkription und Sprachgenerierung über seine API ein und verspricht erhebliche Verbesserungen gegenüber den früheren Versionen. Diese Updates sind Teil der umfassenderen „agentischen“ Vision von OpenAI, die darauf abzielt, autonome Systeme zu schaffen, die Aufgaben unabhängig für Nutzer ausführen können. Während der Begriff „Agent“ diskutiert werden kann, sieht Olivier Godement, Leiter der Produktabteilung bei OpenAI, ihn als Chatbot, der mit den Kunden eines Unternehmens interagieren kann.
„Wir werden in den kommenden Monaten immer mehr Agenten sehen“, teilte Godement TechCrunch während eines Briefings mit. „Das übergeordnete Ziel ist es, Kunden und Entwicklern zu helfen, Agenten zu nutzen, die nützlich, zugänglich und präzise sind.“
Das neueste Text-to-Speech-Modell von OpenAI, genannt „gpt-4o-mini-tts“, zielt nicht nur darauf ab, lebensechtere und nuanciertere Sprache zu erzeugen, sondern ist auch anpassungsfähiger als seine Vorgänger. Entwickler können das Modell nun mit natürlichen Sprachbefehlen steuern, wie z. B. „sprich wie ein verrückter Wissenschaftler“ oder „verwende eine ruhige Stimme, wie ein Achtsamkeitslehrer“. Dieses Maß an Kontrolle ermöglicht eine personalisiertere Spracherfahrung.
Hier ist ein Beispiel für eine „True-Crime-Stil“-Stimme, die verwittert klingt:
Und hier ist ein Beispiel für eine weibliche „professionelle“ Stimme:
Jeff Harris, Mitglied des Produktteams von OpenAI, betonte gegenüber TechCrunch, dass das Ziel darin besteht, Entwicklern die Anpassung sowohl der Sprach-„Erfahrung“ als auch des „Kontexts“ zu ermöglichen. „In verschiedenen Szenarien möchte man keine monotone Stimme“, erklärte Harris. „Zum Beispiel in einer Kundensupport-Situation, in der die Stimme reumütig klingen soll, wenn ein Fehler passiert ist, kann man diese Emotion in die Stimme einfließen lassen. Wir sind fest davon überzeugt, dass Entwickler und Nutzer nicht nur den Inhalt, sondern auch die Art der Sprache kontrollieren möchten.“
In Bezug auf die neuen Speech-to-Text-Angebote von OpenAI, „gpt-4o-transcribe“ und „gpt-4o-mini-transcribe“, sollen diese Modelle das veraltete Whisper-Transkriptionsmodell ersetzen. Sie wurden mit einer vielfältigen Auswahl an hochwertigen Audiodaten trainiert und sollen akzentuierte und abwechslungsreiche Sprache besser verarbeiten, selbst in lauten Umgebungen. Zudem sind diese Modelle weniger anfällig für „Halluzinationen“, ein Problem, bei dem Whisper manchmal Wörter oder ganze Passagen erfand und Ungenauigkeiten wie rassistische Kommentare oder fiktive medizinische Behandlungen in Transkripte einfügte.
„Diese Modelle zeigen in dieser Hinsicht deutliche Verbesserungen gegenüber Whisper“, bemerkte Harris. „Die Genauigkeit des Modells ist entscheidend für eine zuverlässige Spracherfahrung, und mit Genauigkeit meinen wir, dass die Modelle die gesprochenen Wörter korrekt erfassen, ohne nicht gesprochene Inhalte hinzuzufügen.“
Die Leistung kann jedoch je nach Sprache variieren. Interne Benchmarks von OpenAI zeigen, dass gpt-4o-transcribe, das präzisere der beiden Modelle, eine „Wortfehlerrate“ von fast 30 % für indische und dravidische Sprachen wie Tamil, Telugu, Malayalam und Kannada aufweist. Dies deutet darauf hin, dass etwa drei von zehn Wörtern in diesen Sprachen von einer menschlichen Transkription abweichen könnten.
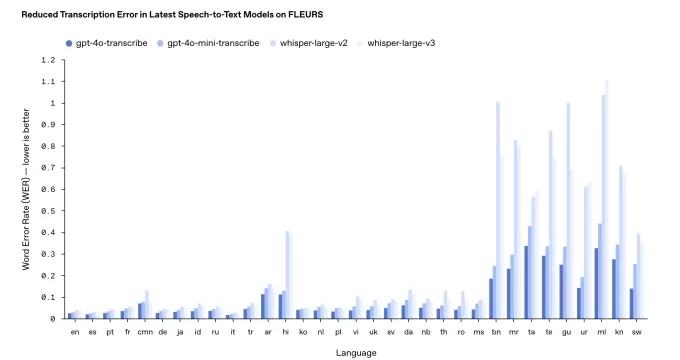
Die Ergebnisse aus dem OpenAI Transkriptions-Benchmarking. Bildnachweis: OpenAI Entgegen ihrer üblichen Praxis wird OpenAI diese neuen Transkriptionsmodelle nicht kostenlos zur Verfügung stellen. Historisch gesehen wurden neue Whisper-Versionen unter einer MIT-Lizenz für kommerzielle Nutzung freigegeben. Harris wies darauf hin, dass gpt-4o-transcribe und gpt-4o-mini-transcribe deutlich größer als Whisper sind, was sie für eine offene Freigabe ungeeignet macht.
„Diese Modelle sind zu groß, um auf einem typischen Laptop wie Whisper ausgeführt zu werden“, fügte Harris hinzu. „Wenn wir Modelle offen freigeben, wollen wir dies durchdacht tun und sicherstellen, dass sie für spezifische Bedürfnisse zugeschnitten sind. Wir sehen Endnutzergeräte als einen Hauptanwendungsbereich für Open-Source-Modelle.“
Aktualisiert am 20. März 2025, 11:54 Uhr PT, um die Formulierung zur Wortfehlerrate zu präzisieren und das Benchmark-Ergebnisdiagramm mit einer neueren Version zu aktualisieren.
Verwandter Artikel
 OpenAI bringt eine sicherere Version von ChatGPT für Jugendliche auf den Markt, Jahre nachdem diese begonnen hatten, die Plattform zu nutzen
Nach einer Reihe von Gerichtsverfahren wegen fehlender Sicherheitsvorkehrungen bei KI-Chatbots – die zu Selbstmorden unter Jugendlichen und anderen psychischen Krisen beigetragen hatten – stellte Open
Frontier AI Labs weigert sich, Eindämmungsstrategien für außer Kontrolle geratene Modelle offenzulegen
Jüngste Untersuchungen zeigen, dass nur sehr wenige führende KI-Forschungslabore Maßnahmenpläne zur Eindämmung veröffentlicht oder vorgeführt haben. Ein solcher Eindämmungsplan legt die Vorgehensweise
NEAs Tiffany Luck: Unternehmen kämpfen weiterhin mit der ROI von KI
Laden des Players…Anfang dieses Jahres dominierte „Tokenmaxxing“ das Silicon Valley, wobei CEOs ihre Mitarbeiter aufforderten, die Nutzung von KI zu maximieren. Diese Begeisterung stieß jedoch schnell auf die Realität. Berichten zufolge hat Uber sei
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
 8 Tools
 xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

 Kommentare (33)
![LeviKing]()
음성 생성 모델 향상이라... 이게 결국 콜센터 직원 대체 같은 데 쓰이면 실업률 걱정이네요. 기술 좋지만 사회적 영향도 고민해야 할 문제 같아요.
![FrankMartínez]()
The new OpenAI models sound like a game-changer for voice tech! Can't wait to see how devs use this to make apps talk smoother than ever. 😎
![BenHernández]()
Wow, OpenAI's new transcription and voice models sound like a game-changer! I'm curious how these 'agentic' systems will stack up against real-world tasks. Could they finally nail natural-sounding convos? 🤔
![GeorgeTaylor]()
Os novos modelos de transcrição e geração de voz da OpenAI são um divisor de águas! Estou usando no meu podcast e as melhorias são impressionantes. O único ponto negativo? São um pouco caros, mas se você puder pagar, vale cada centavo! 🎙️💸
![GregoryAllen]()
OpenAI's new transcription and voice models are a game changer! I've been using them for my podcast and the improvements are night and day. The only downside? They're a bit pricey, but if you can swing it, they're worth every penny! 🎙️💸
![StevenAllen]()
OpenAI의 새로운 음성 인식 및 음성 생성 모델은 정말 혁신적이에요! 제 팟캐스트에서 사용 중인데, 개선이 눈에 띄어요. 단점은 조금 비싸다는 건데, 감당할 수 있다면 그만한 가치가 있어요! 🎙️💸
OpenAI führt neue KI-Modelle für Transkription und Sprachgenerierung über seine API ein und verspricht erhebliche Verbesserungen gegenüber den früheren Versionen. Diese Updates sind Teil der umfassenderen „agentischen“ Vision von OpenAI, die darauf abzielt, autonome Systeme zu schaffen, die Aufgaben unabhängig für Nutzer ausführen können. Während der Begriff „Agent“ diskutiert werden kann, sieht Olivier Godement, Leiter der Produktabteilung bei OpenAI, ihn als Chatbot, der mit den Kunden eines Unternehmens interagieren kann.
„Wir werden in den kommenden Monaten immer mehr Agenten sehen“, teilte Godement TechCrunch während eines Briefings mit. „Das übergeordnete Ziel ist es, Kunden und Entwicklern zu helfen, Agenten zu nutzen, die nützlich, zugänglich und präzise sind.“
Das neueste Text-to-Speech-Modell von OpenAI, genannt „gpt-4o-mini-tts“, zielt nicht nur darauf ab, lebensechtere und nuanciertere Sprache zu erzeugen, sondern ist auch anpassungsfähiger als seine Vorgänger. Entwickler können das Modell nun mit natürlichen Sprachbefehlen steuern, wie z. B. „sprich wie ein verrückter Wissenschaftler“ oder „verwende eine ruhige Stimme, wie ein Achtsamkeitslehrer“. Dieses Maß an Kontrolle ermöglicht eine personalisiertere Spracherfahrung.
Hier ist ein Beispiel für eine „True-Crime-Stil“-Stimme, die verwittert klingt:
Und hier ist ein Beispiel für eine weibliche „professionelle“ Stimme:
Jeff Harris, Mitglied des Produktteams von OpenAI, betonte gegenüber TechCrunch, dass das Ziel darin besteht, Entwicklern die Anpassung sowohl der Sprach-„Erfahrung“ als auch des „Kontexts“ zu ermöglichen. „In verschiedenen Szenarien möchte man keine monotone Stimme“, erklärte Harris. „Zum Beispiel in einer Kundensupport-Situation, in der die Stimme reumütig klingen soll, wenn ein Fehler passiert ist, kann man diese Emotion in die Stimme einfließen lassen. Wir sind fest davon überzeugt, dass Entwickler und Nutzer nicht nur den Inhalt, sondern auch die Art der Sprache kontrollieren möchten.“
In Bezug auf die neuen Speech-to-Text-Angebote von OpenAI, „gpt-4o-transcribe“ und „gpt-4o-mini-transcribe“, sollen diese Modelle das veraltete Whisper-Transkriptionsmodell ersetzen. Sie wurden mit einer vielfältigen Auswahl an hochwertigen Audiodaten trainiert und sollen akzentuierte und abwechslungsreiche Sprache besser verarbeiten, selbst in lauten Umgebungen. Zudem sind diese Modelle weniger anfällig für „Halluzinationen“, ein Problem, bei dem Whisper manchmal Wörter oder ganze Passagen erfand und Ungenauigkeiten wie rassistische Kommentare oder fiktive medizinische Behandlungen in Transkripte einfügte.
„Diese Modelle zeigen in dieser Hinsicht deutliche Verbesserungen gegenüber Whisper“, bemerkte Harris. „Die Genauigkeit des Modells ist entscheidend für eine zuverlässige Spracherfahrung, und mit Genauigkeit meinen wir, dass die Modelle die gesprochenen Wörter korrekt erfassen, ohne nicht gesprochene Inhalte hinzuzufügen.“
Die Leistung kann jedoch je nach Sprache variieren. Interne Benchmarks von OpenAI zeigen, dass gpt-4o-transcribe, das präzisere der beiden Modelle, eine „Wortfehlerrate“ von fast 30 % für indische und dravidische Sprachen wie Tamil, Telugu, Malayalam und Kannada aufweist. Dies deutet darauf hin, dass etwa drei von zehn Wörtern in diesen Sprachen von einer menschlichen Transkription abweichen könnten.
Entgegen ihrer üblichen Praxis wird OpenAI diese neuen Transkriptionsmodelle nicht kostenlos zur Verfügung stellen. Historisch gesehen wurden neue Whisper-Versionen unter einer MIT-Lizenz für kommerzielle Nutzung freigegeben. Harris wies darauf hin, dass gpt-4o-transcribe und gpt-4o-mini-transcribe deutlich größer als Whisper sind, was sie für eine offene Freigabe ungeeignet macht.
„Diese Modelle sind zu groß, um auf einem typischen Laptop wie Whisper ausgeführt zu werden“, fügte Harris hinzu. „Wenn wir Modelle offen freigeben, wollen wir dies durchdacht tun und sicherstellen, dass sie für spezifische Bedürfnisse zugeschnitten sind. Wir sehen Endnutzergeräte als einen Hauptanwendungsbereich für Open-Source-Modelle.“
Aktualisiert am 20. März 2025, 11:54 Uhr PT, um die Formulierung zur Wortfehlerrate zu präzisieren und das Benchmark-Ergebnisdiagramm mit einer neueren Version zu aktualisieren.








 OpenAI bringt eine sicherere Version von ChatGPT für Jugendliche auf den Markt, Jahre nachdem diese begonnen hatten, die Plattform zu nutzen
Nach einer Reihe von Gerichtsverfahren wegen fehlender Sicherheitsvorkehrungen bei KI-Chatbots – die zu Selbstmorden unter Jugendlichen und anderen psychischen Krisen beigetragen hatten – stellte Open
 Frontier AI Labs weigert sich, Eindämmungsstrategien für außer Kontrolle geratene Modelle offenzulegen
Jüngste Untersuchungen zeigen, dass nur sehr wenige führende KI-Forschungslabore Maßnahmenpläne zur Eindämmung veröffentlicht oder vorgeführt haben. Ein solcher Eindämmungsplan legt die Vorgehensweise
 NEAs Tiffany Luck: Unternehmen kämpfen weiterhin mit der ROI von KI
Laden des Players…Anfang dieses Jahres dominierte „Tokenmaxxing“ das Silicon Valley, wobei CEOs ihre Mitarbeiter aufforderten, die Nutzung von KI zu maximieren. Diese Begeisterung stieß jedoch schnell auf die Realität. Berichten zufolge hat Uber sei

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

음성 생성 모델 향상이라... 이게 결국 콜센터 직원 대체 같은 데 쓰이면 실업률 걱정이네요. 기술 좋지만 사회적 영향도 고민해야 할 문제 같아요.
The new OpenAI models sound like a game-changer for voice tech! Can't wait to see how devs use this to make apps talk smoother than ever. 😎
Wow, OpenAI's new transcription and voice models sound like a game-changer! I'm curious how these 'agentic' systems will stack up against real-world tasks. Could they finally nail natural-sounding convos? 🤔
Os novos modelos de transcrição e geração de voz da OpenAI são um divisor de águas! Estou usando no meu podcast e as melhorias são impressionantes. O único ponto negativo? São um pouco caros, mas se você puder pagar, vale cada centavo! 🎙️💸
OpenAI's new transcription and voice models are a game changer! I've been using them for my podcast and the improvements are night and day. The only downside? They're a bit pricey, but if you can swing it, they're worth every penny! 🎙️💸
OpenAI의 새로운 음성 인식 및 음성 생성 모델은 정말 혁신적이에요! 제 팟캐스트에서 사용 중인데, 개선이 눈에 띄어요. 단점은 조금 비싸다는 건데, 감당할 수 있다면 그만한 가치가 있어요! 🎙️💸












