


 首页
Swiftlet 打包 80B Qwen 进入 Mac,内存占用 4.3GB;iPhone 17 将原生运行 35B 模型
一个名为 Swiftlet 的 Swift + Metal 运行时正在重新定义“大模型可以在哪里运行”。它专门针对 Qwen3-Next 和 Qwen3.5/3.6 系列的 MoE(混合专家)模型进行了定制。其核心思路非常巧妙:模型的小型密集核心部分保留在内存中,而大型部分——即路由专家权重——通常存储在 SSD 上,并在需要时流式加载。
从数据中可以清楚地看到结果。在 M5 Mac 上,Qwen3.6-35B-A3B 的 4 位版本在磁盘上占用 18GB,但内存峰值仅为 2.6GB,解码速度为每秒 7 到 11 个 token;更令人印象深刻的是 Qwen3-Next-80B-A3B 的 4 位版本,它在磁盘上需要 42GB,但内存峰值仅为 4.3GB,速度为每秒 4.5 到 5 个 token。35B 版本现在可以在 iPhone 17 上运行,内存约为 2.5GB,速度约为每秒 1 个 token——据开发者称,这是此类模型首次在手机上原生运行而无需接触服务器。
该项目完全端到端可用,两个模型都能产生经过验证的正确输出。开发者也承认这是一种权衡:每个 token 实际上激活了约 30 亿参数,因此这些模型在对话和写作时表现得像大模型,但在事实记忆方面仍表现得像小模型。
其工作原理在于细粒度的调度。每一层将每个 token 路由到 512 个专家中的 10 个(对于 80B 版本)或 256 个专家中的 8 个(对于 35B 版本)。Swiftlet 将密集权重——注意力机制、DeltaNet 投影、路由器、共享专家和嵌入向量——牢牢保留在内存中,4 位量化下分别占用约 1.3GB(35B)或 2.5GB(80B)。数千个路由专家被重新打包为固定步长的数据块,存储在 .qpack 容器中。获取一个专家只需要对 SSD 进行一次 pread 操作,无需 mmap,也不会干扰页面缓存。热门专家使用 LFU 加上最近性策略的淘汰机制缓存在有限的池中;命中率在 43% 到 70% 之间,缓存大小对速度几乎没有影响,因为 Apple 的 SSD 可以处理未命中的开销。
整个前向传播过程使用运行时编译的着色器在 Metal 上运行,因此构建期间不需要 Metal 工具链,相同的代码可以直接部署到 iOS。更有趣的是,75% 的层使用具有固定大小循环状态的 Gated DeltaNet 线性注意力,这意味着无论上下文长度如何,它都不会产生扩展的 KV 缓存——长文本对话的隐藏负担被悄然卸载。
Swiftlet 不仅仅是一个命令行玩具。它有四个专为自身设计的身份。作为库,SwiftletCore 可以嵌入到任何 macOS 或 iOS 应用中,提供带有流式增量输出和对话缓存的聊天功能;作为命令行工具,swiftlet chat 和 swiftlet generate 处理本地执行和基准测试,而 swiftlet-repack 直接从 MLX 检查点构建容器,并支持从 Hugging Face 恢复下载。作为服务器,swiftlet-server 在回环地址上提供与 OpenAI 兼容的 chat-completions 接口,允许任何与 OpenAI 兼容的聊天界面连接到本地模型;作为应用程序,iOS 版本的 Priv AI 将 SwiftletCore 嵌入为流式模型引擎,允许普通用户只需下载即可开始聊天。
关于正确性,每一层的前向传播都与 mlx-lm 参考实现逐层进行比较,涵盖 f32 和 int4 量化形式。增量解码也与完整序列结果进行了比较,Metal 内核经过反复验证,与精确的 CPU 参考一致。容器还可以对源检查点执行字节级验证——无论专家是从缓存还是磁盘读取,答案完全相同。
其灵感路径解释得很清楚:TurboFieldfare 首先验证了在 Mac 上对 Gemma 进行专家流式传输的可行性,Swiftlet 从中借鉴了一些公开的设计经验,例如使用 pread 将专家流式传输到有界槽池中,使用 LFU 加上最近性进行淘汰,以及使用固定步长打包使得一次读取等于一次获取。然而,其余部分都是从头编写的,包含约 10,000 行 Swift 和 Metal 代码,解决了完全不同的 Qwen 混合架构:Gated DeltaNet 线性注意力、门控 GQA 和高稀疏 MoE 带有共享专家。它甚至在 Metal 中实现了 MLX 风格的 int4/int8 组量化计算,使用字节寻址内核和 64 位偏移量来支持千兆字节的分片。
相关文章
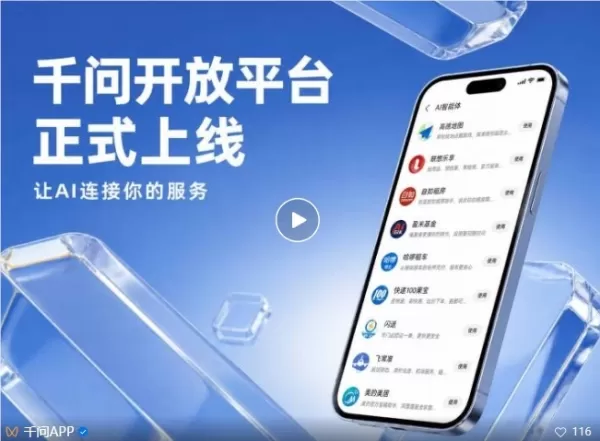
 通义千问开放平台正式上线,将对话即服务带入日常生活
通义千问开放平台已正式上线,为开发者提供覆盖手机、电脑及AI眼镜等多终端的服务接入能力。用户无需在多个应用间切换,即可在对话中直接完成各类日常服务操作。该平台目前涵盖物流、租房、家政及理财等十余个领域。用户可通过@顺丰速运追踪和寄送包裹,根据位置和预算通过@自如租房匹配房源并进行虚拟看房;也可通过@天鹅到家预约保洁服务并核验合同,同时@盈米基金的秋谷可根据风险偏好提供理财分析。此外,@彩云天气可推荐适合遛狗的时间,@闪送支持在对话中修改配送地址,@美滴可监测家庭水质并识别家电故障。所有服务均在对
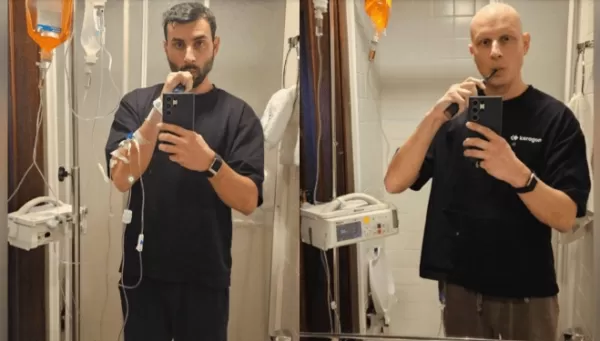
患癌创始人部署人工智能进行反击
康诺·克里斯托(Conno Christou)拒绝将健康交给运气。他通过 Whoop 手环监测睡眠,将数据与 Oura 戒指进行交叉比对,每年接受近 100 项生物标志物检测。连续四年,他遵循彼得·阿提亚(Peter Attia)和朗达·帕特里克(Rhonda Patrick)等长寿专家的血检方案,优化补充剂、昼夜节律和蛋白质摄入。35 岁时,在创办第二家公司的同时,他与周围人一样密切关注最新的健康研究。他 2025 年的体检结果全线飘绿。“这是我多年来最好的检查结果,”他回忆道。然而,在一次锻
Encore AI 获得 3000 万美元融资,用于开发基于客户来电的 AI 客服机器人
Encore AI 是一家初创公司,致力于分析企业客户互动数据,以此训练并部署能够与客服和销售团队协作或独立运作的人工智能语音客服。该公司已获得由 Team8 领投的 3000 万美元 A 轮融资。该公司由首席执行官德维尔·金兹伯格(Dvir Ginzburg)于2022年以“Insait IO”之名创立,最初开发面向理财顾问和客户经理的推荐软件。如今,这家公司已更名为Encore AI,并将该系
相关专题推荐
音乐创作
 用于曲目原型的最佳 AI 人声演示工具
2026 年最新最佳顶级 AI 人声演示工具,适用于曲目原型,现已在 XIX.AI 上线!本精选列表包含经过实际测试、确保卓越表现的强大且具颠覆性的工具。您将看到免费与付费版本的对比、详细排名以及值得尝试的选项,完美助力提升创意效率,助您释放 AI 优势。立即探索,发现最适合您的工具!
 10 个工具
 xix.ai
软件开发
用于前端与后端协作的 AI API 模拟工具
2026年最新、最受欢迎的前端-后端协作AI API模拟工具榜单现已登陆XIX.AI!这份精心筛选的清单汇集了功能强大、具有颠覆性的解决方案,通过实际测试和严格排名,帮助团队优化工作流程、提升工作效率,并更快地开发出高质量的应用程序。 获取免费版与付费版的对比指南,找到最适合您需求的必试选项。立即探索,释放您的AI优势!
12 个工具
xix.ai
设计与艺术
适用于角色概念设计、海报和广告视觉设计的 Midjourney 风格参考工具
2026年最新、最受欢迎、评分最高的中途风格参考工具,适用于角色概念设计、海报和广告视觉设计!XIX.AI 精心整理了一套功能强大、颠覆性的工具合集,并每周进行实际应用测试以持续更新。 您可在此查阅免费版与付费版的详细对比分析及权威排名,助您挑选出必试的工具,从而大幅激发创造力并显著提升工作效率。立即探索,发现满足您所有视觉设计需求的完美工具。
11 个工具
xix.ai
音乐创作
AI 人声生成工具:创建演示人声与和声层
2026 年最新、最佳、最受好评的 AI 人声生成工具,用于创建演示人声和和声层,现已在 XIX.AI 上线。本精选合集收录了多款强大且具颠覆性的解决方案,均已通过严格的真实世界测试。我们每周更新免费与付费版本的对比,并提供详细排名,助您找到提升创造力与生产力的完美工具。立即探索,释放您的 AI 优势。
12 个工具
xix.ai
生产率
最佳 AI 专注助手:减少任务切换,保持专注
2026年最新精选高评分AI专注助手,专为减少任务切换、助您全天保持高效而精心挑选。这些强大的工具均经过严格的实际测试,提供免费版与付费版对比,并每周更新排行榜。快来发现最适合您的工具,提升写作效率、激发创意灵感,并在无干扰的环境中保持专注。 立即访问 XIX.AI,释放您的 AI 优势。
9 个工具
xix.ai
写作
打造清晰商务文稿的最佳AI编辑工具
2026年最新、最受欢迎、评价最高的人工智能编辑工具,助您撰写清晰明了的商务文稿,尽在XIX.AI!这份精心筛选的清单汇集了功能强大、具有颠覆性的解决方案,这些工具经过实际测试和严格排名,可帮助您显著提升写作效率。您还将看到免费版与付费版的对比,助您选择最适合自己的工具。 立即探索,释放您的AI优势!
10 个工具
xix.ai

 评论 (0)
0/500
一个名为 Swiftlet 的 Swift + Metal 运行时正在重新定义“大模型可以在哪里运行”。它专门针对 Qwen3-Next 和 Qwen3.5/3.6 系列的 MoE(混合专家)模型进行了定制。其核心思路非常巧妙:模型的小型密集核心部分保留在内存中,而大型部分——即路由专家权重——通常存储在 SSD 上,并在需要时流式加载。
从数据中可以清楚地看到结果。在 M5 Mac 上,Qwen3.6-35B-A3B 的 4 位版本在磁盘上占用 18GB,但内存峰值仅为 2.6GB,解码速度为每秒 7 到 11 个 token;更令人印象深刻的是 Qwen3-Next-80B-A3B 的 4 位版本,它在磁盘上需要 42GB,但内存峰值仅为 4.3GB,速度为每秒 4.5 到 5 个 token。35B 版本现在可以在 iPhone 17 上运行,内存约为 2.5GB,速度约为每秒 1 个 token——据开发者称,这是此类模型首次在手机上原生运行而无需接触服务器。
该项目完全端到端可用,两个模型都能产生经过验证的正确输出。开发者也承认这是一种权衡:每个 token 实际上激活了约 30 亿参数,因此这些模型在对话和写作时表现得像大模型,但在事实记忆方面仍表现得像小模型。
其工作原理在于细粒度的调度。每一层将每个 token 路由到 512 个专家中的 10 个(对于 80B 版本)或 256 个专家中的 8 个(对于 35B 版本)。Swiftlet 将密集权重——注意力机制、DeltaNet 投影、路由器、共享专家和嵌入向量——牢牢保留在内存中,4 位量化下分别占用约 1.3GB(35B)或 2.5GB(80B)。数千个路由专家被重新打包为固定步长的数据块,存储在 .qpack 容器中。获取一个专家只需要对 SSD 进行一次 pread 操作,无需 mmap,也不会干扰页面缓存。热门专家使用 LFU 加上最近性策略的淘汰机制缓存在有限的池中;命中率在 43% 到 70% 之间,缓存大小对速度几乎没有影响,因为 Apple 的 SSD 可以处理未命中的开销。
整个前向传播过程使用运行时编译的着色器在 Metal 上运行,因此构建期间不需要 Metal 工具链,相同的代码可以直接部署到 iOS。更有趣的是,75% 的层使用具有固定大小循环状态的 Gated DeltaNet 线性注意力,这意味着无论上下文长度如何,它都不会产生扩展的 KV 缓存——长文本对话的隐藏负担被悄然卸载。
Swiftlet 不仅仅是一个命令行玩具。它有四个专为自身设计的身份。作为库,SwiftletCore 可以嵌入到任何 macOS 或 iOS 应用中,提供带有流式增量输出和对话缓存的聊天功能;作为命令行工具,swiftlet chat 和 swiftlet generate 处理本地执行和基准测试,而 swiftlet-repack 直接从 MLX 检查点构建容器,并支持从 Hugging Face 恢复下载。作为服务器,swiftlet-server 在回环地址上提供与 OpenAI 兼容的 chat-completions 接口,允许任何与 OpenAI 兼容的聊天界面连接到本地模型;作为应用程序,iOS 版本的 Priv AI 将 SwiftletCore 嵌入为流式模型引擎,允许普通用户只需下载即可开始聊天。
关于正确性,每一层的前向传播都与 mlx-lm 参考实现逐层进行比较,涵盖 f32 和 int4 量化形式。增量解码也与完整序列结果进行了比较,Metal 内核经过反复验证,与精确的 CPU 参考一致。容器还可以对源检查点执行字节级验证——无论专家是从缓存还是磁盘读取,答案完全相同。
其灵感路径解释得很清楚:TurboFieldfare 首先验证了在 Mac 上对 Gemma 进行专家流式传输的可行性,Swiftlet 从中借鉴了一些公开的设计经验,例如使用 pread 将专家流式传输到有界槽池中,使用 LFU 加上最近性进行淘汰,以及使用固定步长打包使得一次读取等于一次获取。然而,其余部分都是从头编写的,包含约 10,000 行 Swift 和 Metal 代码,解决了完全不同的 Qwen 混合架构:Gated DeltaNet 线性注意力、门控 GQA 和高稀疏 MoE 带有共享专家。它甚至在 Metal 中实现了 MLX 风格的 int4/int8 组量化计算,使用字节寻址内核和 64 位偏移量来支持千兆字节的分片。








 通义千问开放平台正式上线,将对话即服务带入日常生活
通义千问开放平台已正式上线,为开发者提供覆盖手机、电脑及AI眼镜等多终端的服务接入能力。用户无需在多个应用间切换,即可在对话中直接完成各类日常服务操作。该平台目前涵盖物流、租房、家政及理财等十余个领域。用户可通过@顺丰速运追踪和寄送包裹,根据位置和预算通过@自如租房匹配房源并进行虚拟看房;也可通过@天鹅到家预约保洁服务并核验合同,同时@盈米基金的秋谷可根据风险偏好提供理财分析。此外,@彩云天气可推荐适合遛狗的时间,@闪送支持在对话中修改配送地址,@美滴可监测家庭水质并识别家电故障。所有服务均在对
 患癌创始人部署人工智能进行反击
康诺·克里斯托(Conno Christou)拒绝将健康交给运气。他通过 Whoop 手环监测睡眠,将数据与 Oura 戒指进行交叉比对,每年接受近 100 项生物标志物检测。连续四年,他遵循彼得·阿提亚(Peter Attia)和朗达·帕特里克(Rhonda Patrick)等长寿专家的血检方案,优化补充剂、昼夜节律和蛋白质摄入。35 岁时,在创办第二家公司的同时,他与周围人一样密切关注最新的健康研究。他 2025 年的体检结果全线飘绿。“这是我多年来最好的检查结果,”他回忆道。然而,在一次锻
 Encore AI 获得 3000 万美元融资,用于开发基于客户来电的 AI 客服机器人
Encore AI 是一家初创公司,致力于分析企业客户互动数据,以此训练并部署能够与客服和销售团队协作或独立运作的人工智能语音客服。该公司已获得由 Team8 领投的 3000 万美元 A 轮融资。该公司由首席执行官德维尔·金兹伯格(Dvir Ginzburg)于2022年以“Insait IO”之名创立,最初开发面向理财顾问和客户经理的推荐软件。如今,这家公司已更名为Encore AI,并将该系
2026 年最新最佳顶级 AI 人声演示工具,适用于曲目原型,现已在 XIX.AI 上线!本精选列表包含经过实际测试、确保卓越表现的强大且具颠覆性的工具。您将看到免费与付费版本的对比、详细排名以及值得尝试的选项,完美助力提升创意效率,助您释放 AI 优势。立即探索,发现最适合您的工具!
10 个工具
xix.ai
2026年最新、最受欢迎的前端-后端协作AI API模拟工具榜单现已登陆XIX.AI!这份精心筛选的清单汇集了功能强大、具有颠覆性的解决方案,通过实际测试和严格排名,帮助团队优化工作流程、提升工作效率,并更快地开发出高质量的应用程序。 获取免费版与付费版的对比指南,找到最适合您需求的必试选项。立即探索,释放您的AI优势!
12 个工具
xix.ai
2026年最新、最受欢迎、评分最高的中途风格参考工具,适用于角色概念设计、海报和广告视觉设计!XIX.AI 精心整理了一套功能强大、颠覆性的工具合集,并每周进行实际应用测试以持续更新。 您可在此查阅免费版与付费版的详细对比分析及权威排名,助您挑选出必试的工具,从而大幅激发创造力并显著提升工作效率。立即探索,发现满足您所有视觉设计需求的完美工具。
11 个工具
xix.ai
2026 年最新、最佳、最受好评的 AI 人声生成工具,用于创建演示人声和和声层,现已在 XIX.AI 上线。本精选合集收录了多款强大且具颠覆性的解决方案,均已通过严格的真实世界测试。我们每周更新免费与付费版本的对比,并提供详细排名,助您找到提升创造力与生产力的完美工具。立即探索,释放您的 AI 优势。
12 个工具
xix.ai
2026年最新精选高评分AI专注助手,专为减少任务切换、助您全天保持高效而精心挑选。这些强大的工具均经过严格的实际测试,提供免费版与付费版对比,并每周更新排行榜。快来发现最适合您的工具,提升写作效率、激发创意灵感,并在无干扰的环境中保持专注。 立即访问 XIX.AI,释放您的 AI 优势。
9 个工具
xix.ai
2026年最新、最受欢迎、评价最高的人工智能编辑工具,助您撰写清晰明了的商务文稿,尽在XIX.AI!这份精心筛选的清单汇集了功能强大、具有颠覆性的解决方案,这些工具经过实际测试和严格排名,可帮助您显著提升写作效率。您还将看到免费版与付费版的对比,助您选择最适合自己的工具。 立即探索,释放您的AI优势!
10 个工具
xix.ai












