


 首頁
Swiftlet 打包 80B Qwen 進入 Mac,記憶體佔用 4.3GB;iPhone 17 將原生執行 35B 模型
一個名為 Swiftlet 的 Swift + Metal 執行時正在重新定義“大模型可以在哪裡執行”。它專門針對 Qwen3-Next 和 Qwen3.5/3.6 系列的 MoE(混合專家)模型進行了定製。其核心思路非常巧妙:模型的小型密集核心部分保留在記憶體中,而大型部分——即路由專家權重——通常儲存在 SSD 上,並在需要時流式載入。
從資料中可以清楚地看到結果。在 M5 Mac 上,Qwen3.6-35B-A3B 的 4 位版本在磁碟上佔用 18GB,但記憶體峰值僅為 2.6GB,解碼速度為每秒 7 到 11 個 token;更令人印象深刻的是 Qwen3-Next-80B-A3B 的 4 位版本,它在磁碟上需要 42GB,但記憶體峰值僅為 4.3GB,速度為每秒 4.5 到 5 個 token。35B 版本現在可以在 iPhone 17 上執行,記憶體約為 2.5GB,速度約為每秒 1 個 token——據開發者稱,這是此類模型首次在手機上原生執行而無需接觸伺服器。
該專案完全端到端可用,兩個模型都能產生經過驗證的正確輸出。開發者也承認這是一種權衡:每個 token 實際上啟用了約 30 億引數,因此這些模型在對話和寫作時表現得像大模型,但在事實記憶方面仍表現得像小模型。
其工作原理在於細粒度的排程。每一層將每個 token 路由到 512 個專家中的 10 個(對於 80B 版本)或 256 個專家中的 8 個(對於 35B 版本)。Swiftlet 將密集權重——注意力機制、DeltaNet 投影、路由器、共享專家和嵌入向量——牢牢保留在記憶體中,4 位量化下分別佔用約 1.3GB(35B)或 2.5GB(80B)。數千個路由專家被重新打包為固定步長的資料塊,儲存在 .qpack 容器中。獲取一個專家只需要對 SSD 進行一次 pread 操作,無需 mmap,也不會干擾頁面快取。熱門專家使用 LFU 加上最近性策略的淘汰機制快取在有限的池中;命中率在 43% 到 70% 之間,快取大小對速度幾乎沒有影響,因為 Apple 的 SSD 可以處理未命中的開銷。
整個前向傳播過程使用執行時編譯的著色器在 Metal 上執行,因此構建期間不需要 Metal 工具鏈,相同的程式碼可以直接部署到 iOS。更有趣的是,75% 的層使用具有固定大小迴圈狀態的 Gated DeltaNet 線性注意力,這意味著無論上下文長度如何,它都不會產生擴充套件的 KV 快取——長文字對話的隱藏負擔被悄然解除安裝。
Swiftlet 不僅僅是一個命令列玩具。它有四個專為自身設計的身份。作為庫,SwiftletCore 可以嵌入到任何 macOS 或 iOS 應用中,提供帶有流式增量輸出和對話快取的聊天功能;作為命令列工具,swiftlet chat 和 swiftlet generate 處理本地執行和基準測試,而 swiftlet-repack 直接從 MLX 檢查點構建容器,並支援從 Hugging Face 恢復下載。作為伺服器,swiftlet-server 在迴環地址上提供與 OpenAI 相容的 chat-completions 介面,允許任何與 OpenAI 相容的聊天介面連線到本地模型;作為應用程式,iOS 版本的 Priv AI 將 SwiftletCore 嵌入為流式模型引擎,允許普通使用者只需下載即可開始聊天。
關於正確性,每一層的前向傳播都與 mlx-lm 參考實現逐層進行比較,涵蓋 f32 和 int4 量化形式。增量解碼也與完整序列結果進行了比較,Metal 核心經過反覆驗證,與精確的 CPU 參考一致。容器還可以對源檢查點執行位元組級驗證——無論專家是從快取還是磁碟讀取,答案完全相同。
其靈感路徑解釋得很清楚:TurboFieldfare 首先驗證了在 Mac 上對 Gemma 進行專家流式傳輸的可行性,Swiftlet 從中借鑑了一些公開的設計經驗,例如使用 pread 將專家流式傳輸到有界槽池中,使用 LFU 加上最近性進行淘汰,以及使用固定步長打包使得一次讀取等於一次獲取。然而,其餘部分都是從頭編寫的,包含約 10,000 行 Swift 和 Metal 程式碼,解決了完全不同的 Qwen 混合架構:Gated DeltaNet 線性注意力、門控 GQA 和高稀疏 MoE 帶有共享專家。它甚至在 Metal 中實現了 MLX 風格的 int4/int8 組量化計算,使用位元組定址核心和 64 位偏移量來支援千兆位元組的分片。
相關文章
 騰訊重組大模型團隊,姚順宇負責基礎模型
騰訊混元多模態團隊近期完成了重大重組與戰略轉型。此前負責xAI多模態理解工作的陸旭東已加入混元團隊,負責領導多模態內容生成演算法。這一調整伴隨著關鍵人事變動,包括前多模態理解負責人胡漢離職創業,以及前OpenAI研究員田永隆的加入。這些舉措標誌著騰訊在多模態大模型開發策略上的重大重新定位。騰訊混元的多模態演進主要圍繞幾款核心產品展開。2024年底,該團隊推出了HunyuanVideo,這是目前最大的開源文字生成影片模型;隨後在2025年擴充套件至影象生成影片、自定義生成及數字人動畫領域。影象生成能力
通義千問開放平臺正式上線,將對話即服務帶入日常生活
通義千問開放平臺已正式上線,為開發者提供覆蓋手機、電腦及AI眼鏡等多終端的服務接入能力。使用者無需在多個應用間切換,即可在對話中直接完成各類日常服務操作。該平臺目前涵蓋物流、租房、家政及理財等十餘個領域。使用者可透過@順豐速運追蹤和寄送包裹,根據位置和預算透過@自如租房匹配房源並進行虛擬看房;也可透過@天鵝到家預約保潔服務並核驗合同,同時@盈米基金的秋谷可根據風險偏好提供理財分析。此外,@彩雲天氣可推薦適合遛狗的時間,@閃送支援在對話中修改配送地址,@美滴可監測家庭水質並識別家電故障。所有服務均在對
患癌創始人部署人工智慧進行反擊
康諾·克里斯托(Conno Christou)拒絕將健康交給運氣。他透過 Whoop 手環監測睡眠,將資料與 Oura 戒指進行交叉比對,每年接受近 100 項生物標誌物檢測。連續四年,他遵循彼得·阿提亞(Peter Attia)和朗達·帕特里克(Rhonda Patrick)等長壽專家的血檢方案,最佳化補充劑、晝夜節律和蛋白質攝入。35 歲時,在創辦第二家公司的同時,他與周圍人一樣密切關注最新的健康研究。他 2025 年的體檢結果全線飄綠。“這是我多年來最好的檢查結果,”他回憶道。然而,在一次鍛
相關專題推薦
音樂創作
 用於曲目原型的最佳 AI 人聲演示工具
2026 年最新最佳頂級 AI 人聲演示工具,適用於曲目原型,現已在 XIX.AI 上線!本精選列表包含經過實際測試、確保卓越表現的強大且具顛覆性的工具。您將看到免費與付費版本的對比、詳細排名以及值得嘗試的選項,完美助力提升創意效率,助您釋放 AI 優勢。立即探索,發現最適合您的工具!
 10 個工具
 xix.ai
軟件開發
用於前端與後端協作的 AI API 模擬工具
2026 年最新、最受好評的前端與後端協作 AI API 模擬工具,盡在 XIX.AI!這份精心挑選的清單收錄了強大且具顛覆性的解決方案,透過實際測試與嚴格評比,協助團隊簡化工作流程、提升生產力,並更快打造高品質的應用程式。 透過免費版與付費版的比較,找出最符合您需求的必試選項。立即探索,釋放您的 AI 競爭優勢!
12 個工具
xix.ai
設計與藝術
適用於角色概念、海報及廣告視覺設計的 Midjourney 風格參考工具
2026 年最新、最受好評的 Midjourney 風格參考工具,適用於角色概念設計、海報及廣告視覺設計!XIX.AI 精心彙整了一套強大且顛覆業界的工具合集,並每週進行實際應用測試以確保內容最新。 您可在此找到詳盡的免費與付費版本對比分析,以及可靠的排名資訊,助您挑選必試的選項,大幅提升創意並顯著加快工作流程。立即探索,為您所有的視覺設計需求發現最完美的工具。
11 個工具
xix.ai
音樂創作
AI 人聲生成工具:建立演示人聲與和聲層
2026 年最新、最佳、最受好評的 AI 人聲生成工具,用於建立演示人聲和和聲層,現已在 XIX.AI 上線。本精選合集收錄了多款強大且具顛覆性的解決方案,均已透過嚴格的真實世界測試。我們每週更新免費與付費版本的對比,並提供詳細排名,助您找到提升創造力與生產力的完美工具。立即探索,釋放您的 AI 優勢。
12 個工具
xix.ai
生產率
最佳 AI 專注助理:減少任務切換,保持專注
2026 年最新精選、評價最高的 AI 專注輔助工具,專為大幅減少切換工作情境的次數,並讓您全天保持高效而精心挑選。這些強大的工具均經過嚴謹的實際環境測試,提供免費版與付費版的比較,並每週更新排行榜。立即探索最適合您的工具,提升寫作效率、激發創意靈感,並在無干擾的狀態下保持專注。 立即前往 XIX.AI 探索,釋放您的 AI 優勢。
9 個工具
xix.ai
寫作
最佳 AI 編輯工具,助您撰寫清晰明瞭的商務文書
2026 年最新、最受好評的 AI 編輯工具,助您撰寫清晰明瞭的商務文案,盡在 XIX.AI!這份精心精選的清單收錄了強大且具顛覆性的解決方案,這些工具經過實際測試與嚴格評比,能助您大幅提升寫作效率。您還可參考免費版與付費版的比較,以挑選最適合您的工具。 立即探索,釋放您的 AI 優勢!
10 個工具
xix.ai

 評論 (0)
0/500
一個名為 Swiftlet 的 Swift + Metal 執行時正在重新定義“大模型可以在哪裡執行”。它專門針對 Qwen3-Next 和 Qwen3.5/3.6 系列的 MoE(混合專家)模型進行了定製。其核心思路非常巧妙:模型的小型密集核心部分保留在記憶體中,而大型部分——即路由專家權重——通常儲存在 SSD 上,並在需要時流式載入。
從資料中可以清楚地看到結果。在 M5 Mac 上,Qwen3.6-35B-A3B 的 4 位版本在磁碟上佔用 18GB,但記憶體峰值僅為 2.6GB,解碼速度為每秒 7 到 11 個 token;更令人印象深刻的是 Qwen3-Next-80B-A3B 的 4 位版本,它在磁碟上需要 42GB,但記憶體峰值僅為 4.3GB,速度為每秒 4.5 到 5 個 token。35B 版本現在可以在 iPhone 17 上執行,記憶體約為 2.5GB,速度約為每秒 1 個 token——據開發者稱,這是此類模型首次在手機上原生執行而無需接觸伺服器。
該專案完全端到端可用,兩個模型都能產生經過驗證的正確輸出。開發者也承認這是一種權衡:每個 token 實際上啟用了約 30 億引數,因此這些模型在對話和寫作時表現得像大模型,但在事實記憶方面仍表現得像小模型。
其工作原理在於細粒度的排程。每一層將每個 token 路由到 512 個專家中的 10 個(對於 80B 版本)或 256 個專家中的 8 個(對於 35B 版本)。Swiftlet 將密集權重——注意力機制、DeltaNet 投影、路由器、共享專家和嵌入向量——牢牢保留在記憶體中,4 位量化下分別佔用約 1.3GB(35B)或 2.5GB(80B)。數千個路由專家被重新打包為固定步長的資料塊,儲存在 .qpack 容器中。獲取一個專家只需要對 SSD 進行一次 pread 操作,無需 mmap,也不會干擾頁面快取。熱門專家使用 LFU 加上最近性策略的淘汰機制快取在有限的池中;命中率在 43% 到 70% 之間,快取大小對速度幾乎沒有影響,因為 Apple 的 SSD 可以處理未命中的開銷。
整個前向傳播過程使用執行時編譯的著色器在 Metal 上執行,因此構建期間不需要 Metal 工具鏈,相同的程式碼可以直接部署到 iOS。更有趣的是,75% 的層使用具有固定大小迴圈狀態的 Gated DeltaNet 線性注意力,這意味著無論上下文長度如何,它都不會產生擴充套件的 KV 快取——長文字對話的隱藏負擔被悄然解除安裝。
Swiftlet 不僅僅是一個命令列玩具。它有四個專為自身設計的身份。作為庫,SwiftletCore 可以嵌入到任何 macOS 或 iOS 應用中,提供帶有流式增量輸出和對話快取的聊天功能;作為命令列工具,swiftlet chat 和 swiftlet generate 處理本地執行和基準測試,而 swiftlet-repack 直接從 MLX 檢查點構建容器,並支援從 Hugging Face 恢復下載。作為伺服器,swiftlet-server 在迴環地址上提供與 OpenAI 相容的 chat-completions 介面,允許任何與 OpenAI 相容的聊天介面連線到本地模型;作為應用程式,iOS 版本的 Priv AI 將 SwiftletCore 嵌入為流式模型引擎,允許普通使用者只需下載即可開始聊天。
關於正確性,每一層的前向傳播都與 mlx-lm 參考實現逐層進行比較,涵蓋 f32 和 int4 量化形式。增量解碼也與完整序列結果進行了比較,Metal 核心經過反覆驗證,與精確的 CPU 參考一致。容器還可以對源檢查點執行位元組級驗證——無論專家是從快取還是磁碟讀取,答案完全相同。
其靈感路徑解釋得很清楚:TurboFieldfare 首先驗證了在 Mac 上對 Gemma 進行專家流式傳輸的可行性,Swiftlet 從中借鑑了一些公開的設計經驗,例如使用 pread 將專家流式傳輸到有界槽池中,使用 LFU 加上最近性進行淘汰,以及使用固定步長打包使得一次讀取等於一次獲取。然而,其餘部分都是從頭編寫的,包含約 10,000 行 Swift 和 Metal 程式碼,解決了完全不同的 Qwen 混合架構:Gated DeltaNet 線性注意力、門控 GQA 和高稀疏 MoE 帶有共享專家。它甚至在 Metal 中實現了 MLX 風格的 int4/int8 組量化計算,使用位元組定址核心和 64 位偏移量來支援千兆位元組的分片。








 騰訊重組大模型團隊,姚順宇負責基礎模型
騰訊混元多模態團隊近期完成了重大重組與戰略轉型。此前負責xAI多模態理解工作的陸旭東已加入混元團隊,負責領導多模態內容生成演算法。這一調整伴隨著關鍵人事變動,包括前多模態理解負責人胡漢離職創業,以及前OpenAI研究員田永隆的加入。這些舉措標誌著騰訊在多模態大模型開發策略上的重大重新定位。騰訊混元的多模態演進主要圍繞幾款核心產品展開。2024年底,該團隊推出了HunyuanVideo,這是目前最大的開源文字生成影片模型;隨後在2025年擴充套件至影象生成影片、自定義生成及數字人動畫領域。影象生成能力
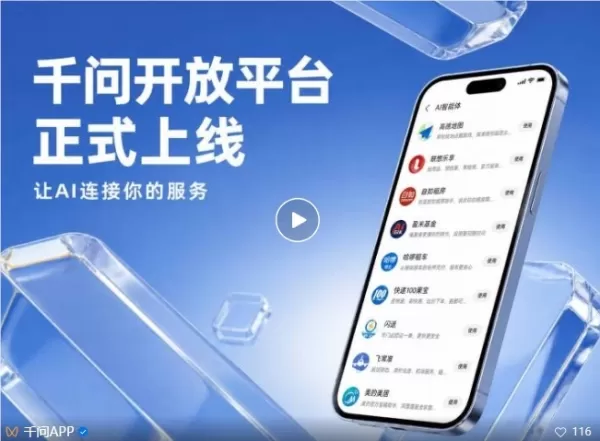 通義千問開放平臺正式上線,將對話即服務帶入日常生活
通義千問開放平臺已正式上線,為開發者提供覆蓋手機、電腦及AI眼鏡等多終端的服務接入能力。使用者無需在多個應用間切換,即可在對話中直接完成各類日常服務操作。該平臺目前涵蓋物流、租房、家政及理財等十餘個領域。使用者可透過@順豐速運追蹤和寄送包裹,根據位置和預算透過@自如租房匹配房源並進行虛擬看房;也可透過@天鵝到家預約保潔服務並核驗合同,同時@盈米基金的秋谷可根據風險偏好提供理財分析。此外,@彩雲天氣可推薦適合遛狗的時間,@閃送支援在對話中修改配送地址,@美滴可監測家庭水質並識別家電故障。所有服務均在對
 患癌創始人部署人工智慧進行反擊
康諾·克里斯托(Conno Christou)拒絕將健康交給運氣。他透過 Whoop 手環監測睡眠,將資料與 Oura 戒指進行交叉比對,每年接受近 100 項生物標誌物檢測。連續四年,他遵循彼得·阿提亞(Peter Attia)和朗達·帕特里克(Rhonda Patrick)等長壽專家的血檢方案,最佳化補充劑、晝夜節律和蛋白質攝入。35 歲時,在創辦第二家公司的同時,他與周圍人一樣密切關注最新的健康研究。他 2025 年的體檢結果全線飄綠。“這是我多年來最好的檢查結果,”他回憶道。然而,在一次鍛
2026 年最新最佳頂級 AI 人聲演示工具,適用於曲目原型,現已在 XIX.AI 上線!本精選列表包含經過實際測試、確保卓越表現的強大且具顛覆性的工具。您將看到免費與付費版本的對比、詳細排名以及值得嘗試的選項,完美助力提升創意效率,助您釋放 AI 優勢。立即探索,發現最適合您的工具!
10 個工具
xix.ai
2026 年最新、最受好評的前端與後端協作 AI API 模擬工具,盡在 XIX.AI!這份精心挑選的清單收錄了強大且具顛覆性的解決方案,透過實際測試與嚴格評比,協助團隊簡化工作流程、提升生產力,並更快打造高品質的應用程式。 透過免費版與付費版的比較,找出最符合您需求的必試選項。立即探索,釋放您的 AI 競爭優勢!
12 個工具
xix.ai
2026 年最新、最受好評的 Midjourney 風格參考工具,適用於角色概念設計、海報及廣告視覺設計!XIX.AI 精心彙整了一套強大且顛覆業界的工具合集,並每週進行實際應用測試以確保內容最新。 您可在此找到詳盡的免費與付費版本對比分析,以及可靠的排名資訊,助您挑選必試的選項,大幅提升創意並顯著加快工作流程。立即探索,為您所有的視覺設計需求發現最完美的工具。
11 個工具
xix.ai
2026 年最新、最佳、最受好評的 AI 人聲生成工具,用於建立演示人聲和和聲層,現已在 XIX.AI 上線。本精選合集收錄了多款強大且具顛覆性的解決方案,均已透過嚴格的真實世界測試。我們每週更新免費與付費版本的對比,並提供詳細排名,助您找到提升創造力與生產力的完美工具。立即探索,釋放您的 AI 優勢。
12 個工具
xix.ai

2026 年最新精選、評價最高的 AI 專注輔助工具,專為大幅減少切換工作情境的次數,並讓您全天保持高效而精心挑選。這些強大的工具均經過嚴謹的實際環境測試,提供免費版與付費版的比較,並每週更新排行榜。立即探索最適合您的工具,提升寫作效率、激發創意靈感,並在無干擾的狀態下保持專注。 立即前往 XIX.AI 探索,釋放您的 AI 優勢。
9 個工具
xix.ai

2026 年最新、最受好評的 AI 編輯工具,助您撰寫清晰明瞭的商務文案,盡在 XIX.AI!這份精心精選的清單收錄了強大且具顛覆性的解決方案,這些工具經過實際測試與嚴格評比,能助您大幅提升寫作效率。您還可參考免費版與付費版的比較,以挑選最適合您的工具。 立即探索,釋放您的 AI 優勢!
10 個工具
xix.ai












