


 Heim
Swiftlet-Packs 80B Qwen in Mac mit 4,3 GB Speicher; iPhone 17 soll 35B nativ ausführen
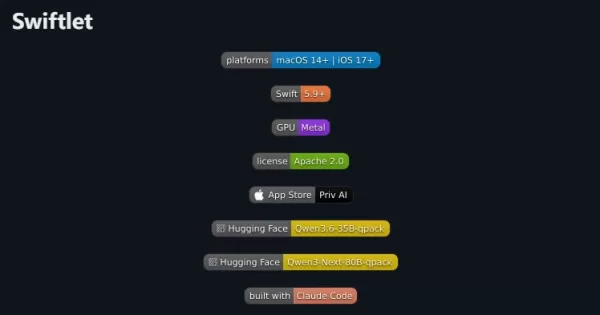
Ein zur Laufzeit kompiliertes Swift- und Metal-Laufzeitsystem namens Swiftlet definiert neu, „wo große Modelle ausgeführt werden können“. Es ist speziell auf die Familie der MoE-Modelle (Mixture of Experts) Qwen3-Next und Qwen3.5/3.6 zugeschnitten. Die Kernidee ist recht clever: Nur der kleine, dichte Kern des Modells verbleibt im Speicher, während der große Teil – die Routing-Expertengewichte – normalerweise auf der SSD gespeichert und bei Bedarf gestreamt wird.
Die Ergebnisse sind aus den Zahlen klar ersichtlich. Auf einem M5-Mac belegt die 4-Bit-Version von Qwen3.6-35B-A3B 18 GB auf der Festplatte, nutzt jedoch nur maximal 2,6 GB Speicher und decodiert mit 7 bis 11 Tok/s; noch beeindruckender ist die 4-Bit-Version von Qwen3-Next-80B-A3B, die 42 GB auf der Festplatte benötigt, aber nur maximal 4,3 GB Speicher beansprucht, mit einer Geschwindigkeit von 4,5 bis 5 Tok/s. Die 35B-Version kann nun auf einem iPhone 17 ausgeführt werden, mit etwa 2,5 GB Speicher und einer Geschwindigkeit von ca. 1 Tok/s – laut den Entwicklern ist dies das erste Mal, dass ein solches Modell nativ auf einem Telefon ausgeführt wird, ohne einen Server zu kontaktieren.
Das Projekt ist vollständig end-to-end nutzbar, und beide Modelle können verifizierte, korrekte Ausgaben erzeugen. Der Entwickler räumt auch einen Kompromiss ein: Jedes Token aktiviert tatsächlich etwa 3 Milliarden Parameter, daher verhalten sich diese Modelle während von Unterhaltungen und Schreibprozessen wie große Modelle, bleiben aber in Bezug auf faktisches Gedächtnis klein.
Sein Funktionsprinzip liegt in der feingranularen Planung. Jede Schicht leitet jedes Token an 10 von 512 Experten weiter (für die 80B-Version) oder an 8 von 256 Experten (für die 35B-Version). Swiftlet hält die dichten Gewichte – Aufmerksamkeit, DeltaNet-Projektionen, Router, gemeinsame Experten und Einbettungsvektoren – fest im Speicher, was etwa 1,3 GB (für 35B) oder 2,5 GB (für 80B) in 4-Bit-Darstellung belegt. Tausende von Routing-Experten werden in Datenblöcke mit festen Schritten umgepackt und in .qpack-Containern gespeichert. Um einen Experten abzurufen, ist nur eine pread-Operation auf der SSD erforderlich, kein mmap, und es wird der Seitencache nicht gestört. Beliebte Experten werden in einem begrenzten Pool unter Verwendung einer LFU-Strategie plus Aktualität zur Verdrängung zwischengespeichert; die Trefferquote liegt zwischen 43 % und 70 %, und die Cache-Größe hat fast keinen Einfluss auf die Geschwindigkeit, da Apples SSD die Überlastung durch Fehltritte bewältigen kann.
Der gesamte Vorwärtsdurchlauf läuft auf Metal unter Verwendung zur Laufzeit kompilierter Shader ab, sodass während des Baus keine Metal-Toolchain benötigt wird und derselbe Code direkt auf iOS bereitgestellt werden kann. Noch interessanter ist, dass 75 % der Schichten Gated DeltaNet-Linearaufmerksamkeit mit einem zyklischen Zustand fester Größe verwenden, was bedeutet, dass sich unabhängig von der Kontextlänge niemals ein erweiternder KV-Cache aufbaut – die versteckte Last langer Textunterhaltungen wird stillschweigend abgewälzt.
Swiftlet ist nicht nur ein Kommandozeilen-Spielzeug. Es hat vier Identitäten, die für sich selbst konzipiert wurden. Als Bibliothek kann SwiftletCore in jede macOS- oder iOS-App eingebettet werden und bietet Chat-Funktionen mit Streaming-Ausgabe inkrementeller Ergebnisse und Gesprächscaching; als Kommandozeilen-Tool behandeln swiftlet chat und swiftlet generate die lokale Ausführung und Benchmarking, während swiftlet-repack Container direkt aus MLX-Checkpoints erstellt und das Fortsetzen von Downloads von Hugging Face unterstützt. Als Server bietet swiftlet-server OpenAI-kompatible chat-completions-Schnittstellen auf einer Loopback-Adresse an, sodass jede OpenAI-kompatible Chat-Schnittstelle eine Verbindung zum lokalen Modell herstellen kann; als Anwendung integriert die iOS-Version von Priv AI SwiftletCore als Streaming-Modell-Engine und ermöglicht es normalen Nutzern, einfach durch Herunterladen des Programms mit dem Chat zu beginnen.
In Bezug auf die Korrektheit wird der Vorwärtsdurchlauf jeder Schicht schichtweise gegen die Referenzimplementierung von mlx-lm verglichen, wobei f32- und int4-Quantisierungsformen abgedeckt werden. Das inkrementelle Decodieren wird ebenfalls mit den Ergebnissen der vollständigen Sequenz verglichen, und die Metal-Kernel wurden wiederholt gegen präzise CPU-Referenzen verifiziert. Der Container kann auch eine Byte-Level-Verifikation gegen den ursprünglichen Checkpoint durchführen – ob Experten aus dem Cache oder der Festplatte gelesen werden, die Antworten sind exakt dieselben.
Sein Inspirationspfad ist klar erklärt: TurboFieldfare hat zunächst die Machbarkeit des Streamings von Experten für Gemma auf dem Mac validiert, und Swiftlet hat einige öffentlich verfügbare Design-Erfahrungen daraus übernommen, wie die Verwendung von pread zum Streamen von Experten in begrenzte Slot-Pools, die Nutzung von LFU plus Aktualität zur Verdrängung und die Verwendung einer paketweisen Aufteilung mit festen Schritten, sodass ein Lesevorgang einem Abruf entspricht. Der Rest wurde jedoch von Grund auf neu geschrieben, mit etwa 10.000 Zeilen Swift- und Metal-Code, die sich mit der völlig anderen Qwen-Mischarchitektur auseinandersetzen: Gated DeltaNet-Linearaufmerksamkeit, gated GQA und hoch-sparse MoE mit gemeinsamen Experten. Es implementiert sogar MLX-ähnliche int4/int8-Gruppenquantisierungsberechnungen in Metal, unter Verwendung byte-adressierbarer Kernel und 64-Bit-Offsets, um Gigabyte an Shards zu unterstützen.
Verwandter Artikel
 Tencent schüttelt das Large-Model-Team um, während Yao Shunyu die Verantwortung für das Basismodell übernimmt
Das multimodale Team von Tencent Hunyuan hat kürzlich eine bedeutende Umstrukturierung und strategische Neuausrichtung abgeschlossen. Lu Xudong, der zuvor die multimodalen Verständnisarbeiten bei xAI geleitet hatte, ist zu Hunyuan gewechselt, um die
Tongyi Qianwen Open Platform wird gestartet und bringt Conversational-as-a-Service in den Alltag.
Die Tongyi Qianwen Open Platform ist offiziell gestartet und bietet Entwicklern Zugriff auf Dienste über mobile Geräte, PCs und KI-Brillen. Nutzer müssen nicht mehr zwischen Apps wechseln; sie können verschiedene tägliche Serviceoperationen direkt in
Krebskranker Gründer setzt KI im Gegenangriff ein
Conno Christou überlässt seine Gesundheit nicht dem Zufall. Er überwacht seinen Schlaf mit einem Whoop-Armband, kreuzreferenziert die Daten mit einem Oura-Ring und unterzieht sich jährlich fast 100 Biomarker-Tests. Vier Jahre lang folgte er den Blutt
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 Die besten KI-Stimm-Demo-Tools für Track-Prototypen
2026 Neueste Besten Top-bewertete KI-Stimm-Demo-Tools für Track-Prototypen sind jetzt auf XIX.AI verfügbar! Diese kuratierte Liste enthält leistungsstarke, bahnbrechende Tools, die realen Tests unterzogen wurden, um höchste Leistungsfähigkeit zu gewährleisten. Sie finden einen kostenlosen vs. kostenpflichtigen Vergleich, detaillierte Ranglisten und empfehlenswerte Optionen, die perfekt geeignet sind, um die kreative Effizienz zu steigern und Ihnen zu helfen, Ihren KI-Vorteil freizuschalten. Entdecken Sie jetzt Ihr perfektes Tool!
 10 Tools
 xix.ai
Softwareentwicklung
AI-API-Mocking-Tools für die Zusammenarbeit zwischen Frontend und Backend
Die besten und am besten bewerteten AI-API-Mocking-Tools für die Zusammenarbeit zwischen Frontend und Backend im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die Teams dabei helfen, Arbeitsabläufe zu optimieren, die Produktivität zu steigern und durch praxisnahe Tests und strenge Bewertungen schneller hochwertige Apps zu entwickeln. Nutzen Sie den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die für Ihre Anforderungen am besten geeignete Option zu finden. Entdecken Sie die Liste jetzt und sichern Sie sich Ihren KI-Vorteil!
12 Tools
xix.ai
Design & Kunst
Midjourney-Stilvorlagen für Charakterentwürfe, Poster und Werbegrafiken
Die besten und am besten bewerteten Midjourney-Referenz-Tools für Charakterkonzepte, Poster und Werbegrafiken – Stand 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die wöchentlich in Praxistests überprüft wird. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie zuverlässige Rankings, die Ihnen helfen, die beste Option zu finden, die Ihre Kreativität beflügelt und Ihren Arbeitsablauf erheblich beschleunigt. Entdecken Sie jetzt das perfekte Tool für all Ihre Anforderungen im Bereich des visuellen Designs.
11 Tools
xix.ai
Musikkomposition
KI-Tools zur Stimmgenerierung: Erstellen Sie Demo-Stimmen und Harmonie-Spuren
Die besten und am besten bewerteten KI-Tools zur Stimmgenerierung für die Erstellung von Demo-Gesangsparts und Harmonie-Layern des Jahres 2026 finden Sie hier auf XIX.AI. Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Lösungen, die strenge Praxistests bestanden haben. Wir bieten einen wöchentlich aktualisierten Vergleich zwischen kostenlosen und kostenpflichtigen Tools sowie detaillierte Rankings, damit Sie das perfekte Tool finden, um Ihre Kreativität und Produktivität zu steigern. Entdecken Sie jetzt die Möglichkeiten und nutzen Sie Ihren KI-Vorteil.
12 Tools
xix.ai
Produktivität
Die besten KI-assistierten Fokus-Tools: Reduzieren Sie Kontextwechsel und behalten Sie den Überblick
Die besten und am besten bewerteten KI-Assistenten des Jahres 2026 – sorgfältig ausgewählt, um Kontextwechsel zu minimieren und Ihre Produktivität den ganzen Tag über aufrechtzuerhalten. Diese leistungsstarken Tools werden strengen Praxistests unterzogen und bieten einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie wöchentlich aktualisierte Ranglisten. Entdecken Sie das perfekte Tool, um Ihre Schreibeffizienz zu steigern, kreative Ideen zu entwickeln und ohne Ablenkung konzentriert zu bleiben. Entdecken Sie jetzt bei XIX.AI, wie Sie Ihren KI-Vorteil nutzen können.
9 Tools
xix.ai
Schreiben
Die besten KI-Editierwerkzeuge für klare Geschäftsberichte
Die neuesten, besten und am höchsten bewerteten AI-Bearbeitungstools für klare Geschäftsberichte aus dem Jahr 2026 sind jetzt auf XIX.AI verfügbar! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke Lösungen, die sich durch praktische Tests sowie strenge Bewertungskriterien als wirklich innovativ erwiesen haben und Ihnen dabei helfen, Ihre Schreibeffizienz erheblich zu steigern. Sie finden dort außerdem einen Vergleich zwischen kostenloser und kostenpflichtiger Variante, um die für Sie beste Option auszuwählen. Entdecken Sie sie jetzt und sichern Sie sich einen Wettbewerbsvorteil durch KI!
10 Tools
xix.ai

 Kommentare (0)
Ein zur Laufzeit kompiliertes Swift- und Metal-Laufzeitsystem namens Swiftlet definiert neu, „wo große Modelle ausgeführt werden können“. Es ist speziell auf die Familie der MoE-Modelle (Mixture of Experts) Qwen3-Next und Qwen3.5/3.6 zugeschnitten. Die Kernidee ist recht clever: Nur der kleine, dichte Kern des Modells verbleibt im Speicher, während der große Teil – die Routing-Expertengewichte – normalerweise auf der SSD gespeichert und bei Bedarf gestreamt wird.
Die Ergebnisse sind aus den Zahlen klar ersichtlich. Auf einem M5-Mac belegt die 4-Bit-Version von Qwen3.6-35B-A3B 18 GB auf der Festplatte, nutzt jedoch nur maximal 2,6 GB Speicher und decodiert mit 7 bis 11 Tok/s; noch beeindruckender ist die 4-Bit-Version von Qwen3-Next-80B-A3B, die 42 GB auf der Festplatte benötigt, aber nur maximal 4,3 GB Speicher beansprucht, mit einer Geschwindigkeit von 4,5 bis 5 Tok/s. Die 35B-Version kann nun auf einem iPhone 17 ausgeführt werden, mit etwa 2,5 GB Speicher und einer Geschwindigkeit von ca. 1 Tok/s – laut den Entwicklern ist dies das erste Mal, dass ein solches Modell nativ auf einem Telefon ausgeführt wird, ohne einen Server zu kontaktieren.
Das Projekt ist vollständig end-to-end nutzbar, und beide Modelle können verifizierte, korrekte Ausgaben erzeugen. Der Entwickler räumt auch einen Kompromiss ein: Jedes Token aktiviert tatsächlich etwa 3 Milliarden Parameter, daher verhalten sich diese Modelle während von Unterhaltungen und Schreibprozessen wie große Modelle, bleiben aber in Bezug auf faktisches Gedächtnis klein.
Sein Funktionsprinzip liegt in der feingranularen Planung. Jede Schicht leitet jedes Token an 10 von 512 Experten weiter (für die 80B-Version) oder an 8 von 256 Experten (für die 35B-Version). Swiftlet hält die dichten Gewichte – Aufmerksamkeit, DeltaNet-Projektionen, Router, gemeinsame Experten und Einbettungsvektoren – fest im Speicher, was etwa 1,3 GB (für 35B) oder 2,5 GB (für 80B) in 4-Bit-Darstellung belegt. Tausende von Routing-Experten werden in Datenblöcke mit festen Schritten umgepackt und in .qpack-Containern gespeichert. Um einen Experten abzurufen, ist nur eine pread-Operation auf der SSD erforderlich, kein mmap, und es wird der Seitencache nicht gestört. Beliebte Experten werden in einem begrenzten Pool unter Verwendung einer LFU-Strategie plus Aktualität zur Verdrängung zwischengespeichert; die Trefferquote liegt zwischen 43 % und 70 %, und die Cache-Größe hat fast keinen Einfluss auf die Geschwindigkeit, da Apples SSD die Überlastung durch Fehltritte bewältigen kann.
Der gesamte Vorwärtsdurchlauf läuft auf Metal unter Verwendung zur Laufzeit kompilierter Shader ab, sodass während des Baus keine Metal-Toolchain benötigt wird und derselbe Code direkt auf iOS bereitgestellt werden kann. Noch interessanter ist, dass 75 % der Schichten Gated DeltaNet-Linearaufmerksamkeit mit einem zyklischen Zustand fester Größe verwenden, was bedeutet, dass sich unabhängig von der Kontextlänge niemals ein erweiternder KV-Cache aufbaut – die versteckte Last langer Textunterhaltungen wird stillschweigend abgewälzt.
Swiftlet ist nicht nur ein Kommandozeilen-Spielzeug. Es hat vier Identitäten, die für sich selbst konzipiert wurden. Als Bibliothek kann SwiftletCore in jede macOS- oder iOS-App eingebettet werden und bietet Chat-Funktionen mit Streaming-Ausgabe inkrementeller Ergebnisse und Gesprächscaching; als Kommandozeilen-Tool behandeln swiftlet chat und swiftlet generate die lokale Ausführung und Benchmarking, während swiftlet-repack Container direkt aus MLX-Checkpoints erstellt und das Fortsetzen von Downloads von Hugging Face unterstützt. Als Server bietet swiftlet-server OpenAI-kompatible chat-completions-Schnittstellen auf einer Loopback-Adresse an, sodass jede OpenAI-kompatible Chat-Schnittstelle eine Verbindung zum lokalen Modell herstellen kann; als Anwendung integriert die iOS-Version von Priv AI SwiftletCore als Streaming-Modell-Engine und ermöglicht es normalen Nutzern, einfach durch Herunterladen des Programms mit dem Chat zu beginnen.
In Bezug auf die Korrektheit wird der Vorwärtsdurchlauf jeder Schicht schichtweise gegen die Referenzimplementierung von mlx-lm verglichen, wobei f32- und int4-Quantisierungsformen abgedeckt werden. Das inkrementelle Decodieren wird ebenfalls mit den Ergebnissen der vollständigen Sequenz verglichen, und die Metal-Kernel wurden wiederholt gegen präzise CPU-Referenzen verifiziert. Der Container kann auch eine Byte-Level-Verifikation gegen den ursprünglichen Checkpoint durchführen – ob Experten aus dem Cache oder der Festplatte gelesen werden, die Antworten sind exakt dieselben.
Sein Inspirationspfad ist klar erklärt: TurboFieldfare hat zunächst die Machbarkeit des Streamings von Experten für Gemma auf dem Mac validiert, und Swiftlet hat einige öffentlich verfügbare Design-Erfahrungen daraus übernommen, wie die Verwendung von pread zum Streamen von Experten in begrenzte Slot-Pools, die Nutzung von LFU plus Aktualität zur Verdrängung und die Verwendung einer paketweisen Aufteilung mit festen Schritten, sodass ein Lesevorgang einem Abruf entspricht. Der Rest wurde jedoch von Grund auf neu geschrieben, mit etwa 10.000 Zeilen Swift- und Metal-Code, die sich mit der völlig anderen Qwen-Mischarchitektur auseinandersetzen: Gated DeltaNet-Linearaufmerksamkeit, gated GQA und hoch-sparse MoE mit gemeinsamen Experten. Es implementiert sogar MLX-ähnliche int4/int8-Gruppenquantisierungsberechnungen in Metal, unter Verwendung byte-adressierbarer Kernel und 64-Bit-Offsets, um Gigabyte an Shards zu unterstützen.








 Tencent schüttelt das Large-Model-Team um, während Yao Shunyu die Verantwortung für das Basismodell übernimmt
Das multimodale Team von Tencent Hunyuan hat kürzlich eine bedeutende Umstrukturierung und strategische Neuausrichtung abgeschlossen. Lu Xudong, der zuvor die multimodalen Verständnisarbeiten bei xAI geleitet hatte, ist zu Hunyuan gewechselt, um die
 Tongyi Qianwen Open Platform wird gestartet und bringt Conversational-as-a-Service in den Alltag.
Die Tongyi Qianwen Open Platform ist offiziell gestartet und bietet Entwicklern Zugriff auf Dienste über mobile Geräte, PCs und KI-Brillen. Nutzer müssen nicht mehr zwischen Apps wechseln; sie können verschiedene tägliche Serviceoperationen direkt in
 Krebskranker Gründer setzt KI im Gegenangriff ein
Conno Christou überlässt seine Gesundheit nicht dem Zufall. Er überwacht seinen Schlaf mit einem Whoop-Armband, kreuzreferenziert die Daten mit einem Oura-Ring und unterzieht sich jährlich fast 100 Biomarker-Tests. Vier Jahre lang folgte er den Blutt
2026 Neueste Besten Top-bewertete KI-Stimm-Demo-Tools für Track-Prototypen sind jetzt auf XIX.AI verfügbar! Diese kuratierte Liste enthält leistungsstarke, bahnbrechende Tools, die realen Tests unterzogen wurden, um höchste Leistungsfähigkeit zu gewährleisten. Sie finden einen kostenlosen vs. kostenpflichtigen Vergleich, detaillierte Ranglisten und empfehlenswerte Optionen, die perfekt geeignet sind, um die kreative Effizienz zu steigern und Ihnen zu helfen, Ihren KI-Vorteil freizuschalten. Entdecken Sie jetzt Ihr perfektes Tool!
10 Tools
xix.ai
Die besten und am besten bewerteten AI-API-Mocking-Tools für die Zusammenarbeit zwischen Frontend und Backend im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die Teams dabei helfen, Arbeitsabläufe zu optimieren, die Produktivität zu steigern und durch praxisnahe Tests und strenge Bewertungen schneller hochwertige Apps zu entwickeln. Nutzen Sie den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um die für Ihre Anforderungen am besten geeignete Option zu finden. Entdecken Sie die Liste jetzt und sichern Sie sich Ihren KI-Vorteil!
12 Tools
xix.ai
Die besten und am besten bewerteten Midjourney-Referenz-Tools für Charakterkonzepte, Poster und Werbegrafiken – Stand 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung zusammengestellt, die wöchentlich in Praxistests überprüft wird. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie zuverlässige Rankings, die Ihnen helfen, die beste Option zu finden, die Ihre Kreativität beflügelt und Ihren Arbeitsablauf erheblich beschleunigt. Entdecken Sie jetzt das perfekte Tool für all Ihre Anforderungen im Bereich des visuellen Designs.
11 Tools
xix.ai
Die besten und am besten bewerteten KI-Tools zur Stimmgenerierung für die Erstellung von Demo-Gesangsparts und Harmonie-Layern des Jahres 2026 finden Sie hier auf XIX.AI. Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Lösungen, die strenge Praxistests bestanden haben. Wir bieten einen wöchentlich aktualisierten Vergleich zwischen kostenlosen und kostenpflichtigen Tools sowie detaillierte Rankings, damit Sie das perfekte Tool finden, um Ihre Kreativität und Produktivität zu steigern. Entdecken Sie jetzt die Möglichkeiten und nutzen Sie Ihren KI-Vorteil.
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Assistenten des Jahres 2026 – sorgfältig ausgewählt, um Kontextwechsel zu minimieren und Ihre Produktivität den ganzen Tag über aufrechtzuerhalten. Diese leistungsstarken Tools werden strengen Praxistests unterzogen und bieten einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie wöchentlich aktualisierte Ranglisten. Entdecken Sie das perfekte Tool, um Ihre Schreibeffizienz zu steigern, kreative Ideen zu entwickeln und ohne Ablenkung konzentriert zu bleiben. Entdecken Sie jetzt bei XIX.AI, wie Sie Ihren KI-Vorteil nutzen können.
9 Tools
xix.ai

Die neuesten, besten und am höchsten bewerteten AI-Bearbeitungstools für klare Geschäftsberichte aus dem Jahr 2026 sind jetzt auf XIX.AI verfügbar! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke Lösungen, die sich durch praktische Tests sowie strenge Bewertungskriterien als wirklich innovativ erwiesen haben und Ihnen dabei helfen, Ihre Schreibeffizienz erheblich zu steigern. Sie finden dort außerdem einen Vergleich zwischen kostenloser und kostenpflichtiger Variante, um die für Sie beste Option auszuwählen. Entdecken Sie sie jetzt und sichern Sie sich einen Wettbewerbsvorteil durch KI!
10 Tools
xix.ai












