


 家
スウィフトレットパックが80B Qwenを4.3GBのメモリでMacに統合; iPhone 17は35Bをネイティブで実行
Swiftlet と名付けられた Swift + Metal 製のランタイムは、「大規模モデルがどこで実行可能か」という概念を再定義しています。これは特に、Qwen3-Next および Qwen3.5/3.6 シリーズの MoE(Mixture of Experts:専門家の混合)モデル向けに最適化されています。その核心となるアイデアは非常に巧妙です。モデルの小さな密なコア部分のみがメモリに保持され、ルーティング専門家の重みといった大きな部分は通常 SSD に格納され、必要に応じてストリーミングで読み込まれます。
数値から結果は明確です。M5 Mac において、Qwen3.6-35B-A3B の 4bit バージョンはディスク上で 18GB を占めますが、メモリ使用量は最大でも 2.6GB に留まり、推論速度は 7〜11 tok/s です。さらに印象的なのは、Qwen3-Next-80B-A3B の 4bit バージョンで、ディスク上で 42GB を必要としますが、メモリ使用量は最大でも 4.3GB、速度は 4.5〜5 tok/s です。35B バージョンは iPhone 17 で実行可能となり、メモリ使用量は約 2.5GB、速度は約 1 tok/s です。開発者によれば、これはサーバーに一切依存せず、スマートフォン上でネイティブにそのようなモデルが実行された初の事例となります。
本プロジェクトはエンドツーエンドで実用可能であり、両モデルとも検証済みの正しい出力を生成できます。開発者はあるトレードオフを認めています。各トークンごとに約 3B のパラメータが活性化するため、これらのモデルは会話や文章生成においては大規模モデルのように振る舞いますが、事実記憶の面では小規模モデルのように振る舞います。
その動作原理は細粒度スケジューリングにあります。各レイヤーは、各トークンを 512 個の専門家の中から 10 個(80B バージョンの場合)または 256 個の専門家の中から 8 個(35B バージョンの場合)にルーティングします。Swiftlet は、注意機構、DeltaNet 射影、ルーター、共有専門家、および埋め込みベクトルといった密な重みをメモリに固定し、4bit 量化において 35B バージョンでは約 1.3GB、80B バージョンでは約 2.5GB を占有します。数千のルーティング専門家は、固定ステップのデータブロックに再パッケージ化され、.qpack コンテナ内に格納されます。1 つの専門家を取得するには、SSD 上での pread 操作が 1 回必要となるだけで、mmap は不要であり、ページキャッシュを乱すこともありません。人気のある専門家は、LFU(Least Frequently Used)と直近性の戦略を組み合わせた限られたプールにキャッシュされ、eviction(追放)の対象となります。ヒット率は 43% から 70% の範囲にあり、キャッシュサイズは速度にほとんど影響しません。なぜなら、Apple の SSD はミスによるオーバーヘッドを処理できるからです。
全体の順伝播は、ランタイムでコンパイルされたシェーダーを使用して Metal 上で実行されるため、ビルド時に Metal ツールチェーンは必要なく、同じコードを直接 iOS にデプロイできます。さらに興味深いのは、レイヤーの 75% が固定サイズの循環状態を持つ Gated DeltaNet 線形注意機構を使用している点です。これにより、コンテキストの長さがどうであれ、拡張する KV キャッシュが生成されることはなく、長文会話における隠れた負担が静かに軽減されます。
Swiftlet は単なるコマンドラインの玩具ではありません。自身のために設計された 4 つのアイデンティティを持っています。ライブラリとして、SwiftletCore は任意の macOS または iOS アプリに埋め込み可能で、ストリーミングによる増分出力と会話キャッシュを備えたチャット機能を提供します。コマンドラインツールとして、swiftlet chat および swiftlet generate はローカル実行とベンチマーク処理を扱い、swiftlet-repack は MLX チェックポイントから直接コンテナを構築し、Hugging Face からのダウンロード再開をサポートします。サーバーとして、swiftlet-server はループバックアドレス上で OpenAI 互換の chat-completions インターフェースを提供し、任意の OpenAI 互換チャットインターフェースがローカルモデルに接続できるようにします。アプリケーションとして、iOS 版の Priv AI は SwiftletCore をストリーミングモデルエンジンとして埋め込み、一般ユーザーが単にダウンロードするだけでチャットを開始できるようにしています。
正確性について、各レイヤーの順伝播は mlx-lm の参照実装に対してレイヤーごとに比較され、f32 形式および int4 量化形式の両方がカバーされています。増分デコーディングも完全なシーケンス結果と比較され、Metal カーネルは正確な CPU 参照に対して繰り返し検証されています。コンテナはソースチェックポイントに対してバイトレベルの検証も実行可能であり、専門家がキャッシュから読み込まれようともディスクから読み込まれようとも、回答は完全に一致します。
そのインスピレーションの経路は明確に説明されています。TurboFieldfare はまず Mac 上で Gemma に対する専門家のストリーミングの可行性を検証し、Swiftlet はそれからの公開された設計経験の一部を借用しました。具体的には、bounded slot pools(制限付きスロットプール)へ専門家をストリーミングするために pread を使用すること、LFU と直近性を組み合わせて eviction(追放)を行うこと、固定ステップパッケージングにより 1 回の読み込みが 1 回のフェッチに相当することなどです。しかし、それ以外の部分はゼロから記述されており、約 10,000 行の Swift および Metal コードで、Gated DeltaNet 線形注意機構、Gated GQA、および共有専門家を持つ高スパース MoE という全く異なる Qwen の混合アーキテクチャに対処しました。さらに、Metal 内で MLX 形式の int4/int8 グループ量化計算を実装し、バイトアドレス可能なカーネルと 64 ビットオフセットを使用して、ギガバイト単位のシャードをサポートしています。
関連記事
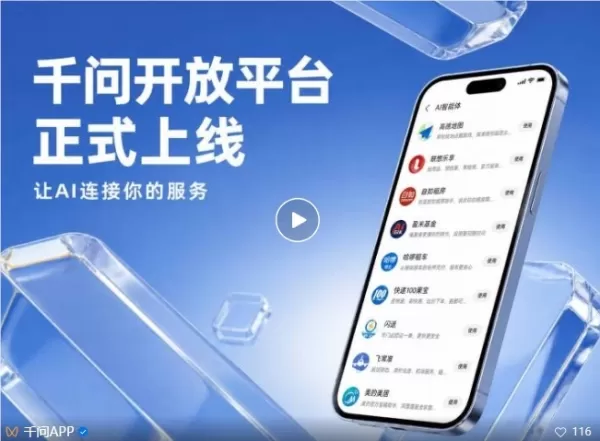
 「通義千文」オープンプラットフォームがリリースされ、会話型サービスが日常生活にもたらされる
通義千文オープンプラットフォームが正式にリリースされ、開発者に対してモバイルデバイス、PC、AIグラス across でのサービスへのアクセスを提供しています。ユーザーはアプリを切り替える必要がなくなり、会話内で各種の日常サービス操作を直接完了できます。プラットフォームは現在、物流、賃貸住宅、ホームサービス、金融管理など10以上の分野にまたがっています。ユーザーは@SFエクスプレスで荷物の追跡や発送、@ZiRu Rentで場所と予算に基づいた物件マッチングおよびバーチャル見学、@Tian’e H
癌を患う創業者が、反撃のためにAIを活用する
コンノ・クリストウは、自分の健康を運に任せることを拒否する。彼はフープバンドで睡眠を監視し、オーラリングのデータと照合し、年間ほぼ100回のバイオマーカー検査を受けている。過去4年間、彼はピーター・アッティアやロンダ・パトリックのような長寿専門家の血液検査プロトコルに従い、サプリメント、概日リズム、タンパク質摂取を最適化してきた。35歳で2つ目の会社を立ち立てながら、彼は周囲の人々と同様に最新の健康研究に精通していた。2025年の健康診断では、すべての数値が良好だった。「過去数年で最高の結果だっ
Encore AI、顧客からの電話対応に特化したAIエージェントの開発に向け、3,000万ドルの資金調達に成功
企業顧客とのやり取りを分析し、サポートチームや営業チームと連携したり、自律的に動作したりできるAI音声エージェントを訓練・導入するスタートアップ「Encore AI」は、Team8が主導するシリーズAラウンドで3,000万ドルの資金調達に成功した。2022年にCEOのDvir Ginzburg氏によってInsait IOとして設立された同社は、当初、ファイナンシャルアドバイザーやリレーションシップ
関連特集おすすめ
作曲
 トラックプロトタイプ用のベストなAIボーカルデモツール
2026年最新版・最高評価のAIボーカルデモツールがXIX.AIで登場!トラックのプロトタイプ作成に最適な厳選リストです。このリストには、実際のテストを経て高性能を保証する革新的なツールが掲載されています。無料版と有料版の比較、詳細なランキング、クリエイティブな効率を向上させ、AIによる優位性を引き出すのに最適な必須ツールが見つかります。今すぐ探索して、あなたにぴったりのツールを見つけましょう!
 10 ツール
 xix.ai
ソフトウェア開発
フロントエンドとバックエンドの連携のためのAI APIモックツール
2026年最新・最高評価のフロントエンド・バックエンド連携向けAI APIモックツールが、XIX.AIに登場!この厳選リストには、実環境でのテストと厳格なランキングを通じて、チームのワークフローを効率化し、生産性を向上させ、高品質なアプリをより迅速に開発するのに役立つ、強力で画期的なソリューションが紹介されています。 無料版と有料版の比較表を活用して、ニーズに合った「必試」のツールを見つけましょう。今すぐチェックして、AIの真価を引き出しましょう!
12 ツール
xix.ai
デザインとアート
キャラクターコンセプト、ポスター、広告ビジュアルのためのMidjourneyスタイルリファレンスツール
2026年最新・最高評価のMidjourneyスタイル参考ツール集:キャラクターコンセプト、ポスター、広告ビジュアルに最適!XIX.AIは、毎週更新される実地テストを経て厳選された、業界に革命をもたらす強力なコレクションをご用意しました。 無料版と有料版の詳細な比較分析や信頼性の高いランキングを参考に、創造性を高め、ワークフローを大幅にスピードアップさせる「必見のツール」を選んでください。今すぐチェックして、あらゆるビジュアルデザインのニーズに最適なツールを見つけましょう。
11 ツール
xix.ai
作曲
AIボーカル生成ツール:デモボーカルとハーモニーレイヤーの作成
2026年最新版・最高評価のAIボーカル生成ツールで、デモボーカルやハーモニーレイヤーの作成が可能。XIX.AIにて提供中。この厳選コレクションは、厳格な実世界テストをクリアした強力かつ革新的なソリューションを特徴としています。創造性と生産性を高める最適なツールを見つけるお手伝いをするため、週替わりで無料版と有料版の比較および詳細なランキングを提供しています。今すぐ探索して、AIによる優位性を解き放ってください。
12 ツール
xix.ai
生産性
おすすめのAIフォーカスアシスタント:コンテキスト切り替えを減らし、作業の軌道から外れないようにする
2026年最新・最高評価のAIフォーカスアシスタントを厳選。コンテキスト切り替えを大幅に削減し、一日中生産性を維持できるようサポートします。これらの強力なツールは、実環境での厳格なテストを経ており、無料版と有料版の比較や、毎週更新されるランキングも掲載されています。執筆効率を高め、創造的なアイデアを引き出し、気が散ることなく集中力を維持するための、あなたにぴったりのツールを見つけましょう。 今すぐXIX.AIでチェックして、AIの力を最大限に活用しましょう。
9 ツール
xix.ai
書き込み
明確でプロフェッショナルなビジネス文章を作成するための最良のAI編集ツール
2026年最新かつ最も優れ、高評価を得ているビジネスライティング向けAI編集ツールがXIX.AIでご紹介です!実際の使用環境でのテストや厳格なランキングに基づき選ばれたこれらの強力なソリューションは、ライティングの効率を大幅に向上させるのに役立ちます。無料版と有料版の比較も用意されているので、ご自身に最適なツールを選びやすくなっています。今すぐチェックして、AIを活用した強力なワークフローを実現しましょう!
10 ツール
xix.ai

 コメント (0)
0/500
Swiftlet と名付けられた Swift + Metal 製のランタイムは、「大規模モデルがどこで実行可能か」という概念を再定義しています。これは特に、Qwen3-Next および Qwen3.5/3.6 シリーズの MoE(Mixture of Experts:専門家の混合)モデル向けに最適化されています。その核心となるアイデアは非常に巧妙です。モデルの小さな密なコア部分のみがメモリに保持され、ルーティング専門家の重みといった大きな部分は通常 SSD に格納され、必要に応じてストリーミングで読み込まれます。
数値から結果は明確です。M5 Mac において、Qwen3.6-35B-A3B の 4bit バージョンはディスク上で 18GB を占めますが、メモリ使用量は最大でも 2.6GB に留まり、推論速度は 7〜11 tok/s です。さらに印象的なのは、Qwen3-Next-80B-A3B の 4bit バージョンで、ディスク上で 42GB を必要としますが、メモリ使用量は最大でも 4.3GB、速度は 4.5〜5 tok/s です。35B バージョンは iPhone 17 で実行可能となり、メモリ使用量は約 2.5GB、速度は約 1 tok/s です。開発者によれば、これはサーバーに一切依存せず、スマートフォン上でネイティブにそのようなモデルが実行された初の事例となります。
本プロジェクトはエンドツーエンドで実用可能であり、両モデルとも検証済みの正しい出力を生成できます。開発者はあるトレードオフを認めています。各トークンごとに約 3B のパラメータが活性化するため、これらのモデルは会話や文章生成においては大規模モデルのように振る舞いますが、事実記憶の面では小規模モデルのように振る舞います。
その動作原理は細粒度スケジューリングにあります。各レイヤーは、各トークンを 512 個の専門家の中から 10 個(80B バージョンの場合)または 256 個の専門家の中から 8 個(35B バージョンの場合)にルーティングします。Swiftlet は、注意機構、DeltaNet 射影、ルーター、共有専門家、および埋め込みベクトルといった密な重みをメモリに固定し、4bit 量化において 35B バージョンでは約 1.3GB、80B バージョンでは約 2.5GB を占有します。数千のルーティング専門家は、固定ステップのデータブロックに再パッケージ化され、.qpack コンテナ内に格納されます。1 つの専門家を取得するには、SSD 上での pread 操作が 1 回必要となるだけで、mmap は不要であり、ページキャッシュを乱すこともありません。人気のある専門家は、LFU(Least Frequently Used)と直近性の戦略を組み合わせた限られたプールにキャッシュされ、eviction(追放)の対象となります。ヒット率は 43% から 70% の範囲にあり、キャッシュサイズは速度にほとんど影響しません。なぜなら、Apple の SSD はミスによるオーバーヘッドを処理できるからです。
全体の順伝播は、ランタイムでコンパイルされたシェーダーを使用して Metal 上で実行されるため、ビルド時に Metal ツールチェーンは必要なく、同じコードを直接 iOS にデプロイできます。さらに興味深いのは、レイヤーの 75% が固定サイズの循環状態を持つ Gated DeltaNet 線形注意機構を使用している点です。これにより、コンテキストの長さがどうであれ、拡張する KV キャッシュが生成されることはなく、長文会話における隠れた負担が静かに軽減されます。
Swiftlet は単なるコマンドラインの玩具ではありません。自身のために設計された 4 つのアイデンティティを持っています。ライブラリとして、SwiftletCore は任意の macOS または iOS アプリに埋め込み可能で、ストリーミングによる増分出力と会話キャッシュを備えたチャット機能を提供します。コマンドラインツールとして、swiftlet chat および swiftlet generate はローカル実行とベンチマーク処理を扱い、swiftlet-repack は MLX チェックポイントから直接コンテナを構築し、Hugging Face からのダウンロード再開をサポートします。サーバーとして、swiftlet-server はループバックアドレス上で OpenAI 互換の chat-completions インターフェースを提供し、任意の OpenAI 互換チャットインターフェースがローカルモデルに接続できるようにします。アプリケーションとして、iOS 版の Priv AI は SwiftletCore をストリーミングモデルエンジンとして埋め込み、一般ユーザーが単にダウンロードするだけでチャットを開始できるようにしています。
正確性について、各レイヤーの順伝播は mlx-lm の参照実装に対してレイヤーごとに比較され、f32 形式および int4 量化形式の両方がカバーされています。増分デコーディングも完全なシーケンス結果と比較され、Metal カーネルは正確な CPU 参照に対して繰り返し検証されています。コンテナはソースチェックポイントに対してバイトレベルの検証も実行可能であり、専門家がキャッシュから読み込まれようともディスクから読み込まれようとも、回答は完全に一致します。
そのインスピレーションの経路は明確に説明されています。TurboFieldfare はまず Mac 上で Gemma に対する専門家のストリーミングの可行性を検証し、Swiftlet はそれからの公開された設計経験の一部を借用しました。具体的には、bounded slot pools(制限付きスロットプール)へ専門家をストリーミングするために pread を使用すること、LFU と直近性を組み合わせて eviction(追放)を行うこと、固定ステップパッケージングにより 1 回の読み込みが 1 回のフェッチに相当することなどです。しかし、それ以外の部分はゼロから記述されており、約 10,000 行の Swift および Metal コードで、Gated DeltaNet 線形注意機構、Gated GQA、および共有専門家を持つ高スパース MoE という全く異なる Qwen の混合アーキテクチャに対処しました。さらに、Metal 内で MLX 形式の int4/int8 グループ量化計算を実装し、バイトアドレス可能なカーネルと 64 ビットオフセットを使用して、ギガバイト単位のシャードをサポートしています。








 「通義千文」オープンプラットフォームがリリースされ、会話型サービスが日常生活にもたらされる
通義千文オープンプラットフォームが正式にリリースされ、開発者に対してモバイルデバイス、PC、AIグラス across でのサービスへのアクセスを提供しています。ユーザーはアプリを切り替える必要がなくなり、会話内で各種の日常サービス操作を直接完了できます。プラットフォームは現在、物流、賃貸住宅、ホームサービス、金融管理など10以上の分野にまたがっています。ユーザーは@SFエクスプレスで荷物の追跡や発送、@ZiRu Rentで場所と予算に基づいた物件マッチングおよびバーチャル見学、@Tian’e H
 癌を患う創業者が、反撃のためにAIを活用する
コンノ・クリストウは、自分の健康を運に任せることを拒否する。彼はフープバンドで睡眠を監視し、オーラリングのデータと照合し、年間ほぼ100回のバイオマーカー検査を受けている。過去4年間、彼はピーター・アッティアやロンダ・パトリックのような長寿専門家の血液検査プロトコルに従い、サプリメント、概日リズム、タンパク質摂取を最適化してきた。35歳で2つ目の会社を立ち立てながら、彼は周囲の人々と同様に最新の健康研究に精通していた。2025年の健康診断では、すべての数値が良好だった。「過去数年で最高の結果だっ
 Encore AI、顧客からの電話対応に特化したAIエージェントの開発に向け、3,000万ドルの資金調達に成功
企業顧客とのやり取りを分析し、サポートチームや営業チームと連携したり、自律的に動作したりできるAI音声エージェントを訓練・導入するスタートアップ「Encore AI」は、Team8が主導するシリーズAラウンドで3,000万ドルの資金調達に成功した。2022年にCEOのDvir Ginzburg氏によってInsait IOとして設立された同社は、当初、ファイナンシャルアドバイザーやリレーションシップ
2026年最新版・最高評価のAIボーカルデモツールがXIX.AIで登場!トラックのプロトタイプ作成に最適な厳選リストです。このリストには、実際のテストを経て高性能を保証する革新的なツールが掲載されています。無料版と有料版の比較、詳細なランキング、クリエイティブな効率を向上させ、AIによる優位性を引き出すのに最適な必須ツールが見つかります。今すぐ探索して、あなたにぴったりのツールを見つけましょう!
10 ツール
xix.ai
2026年最新・最高評価のフロントエンド・バックエンド連携向けAI APIモックツールが、XIX.AIに登場!この厳選リストには、実環境でのテストと厳格なランキングを通じて、チームのワークフローを効率化し、生産性を向上させ、高品質なアプリをより迅速に開発するのに役立つ、強力で画期的なソリューションが紹介されています。 無料版と有料版の比較表を活用して、ニーズに合った「必試」のツールを見つけましょう。今すぐチェックして、AIの真価を引き出しましょう!
12 ツール
xix.ai
2026年最新・最高評価のMidjourneyスタイル参考ツール集:キャラクターコンセプト、ポスター、広告ビジュアルに最適!XIX.AIは、毎週更新される実地テストを経て厳選された、業界に革命をもたらす強力なコレクションをご用意しました。 無料版と有料版の詳細な比較分析や信頼性の高いランキングを参考に、創造性を高め、ワークフローを大幅にスピードアップさせる「必見のツール」を選んでください。今すぐチェックして、あらゆるビジュアルデザインのニーズに最適なツールを見つけましょう。
11 ツール
xix.ai
2026年最新版・最高評価のAIボーカル生成ツールで、デモボーカルやハーモニーレイヤーの作成が可能。XIX.AIにて提供中。この厳選コレクションは、厳格な実世界テストをクリアした強力かつ革新的なソリューションを特徴としています。創造性と生産性を高める最適なツールを見つけるお手伝いをするため、週替わりで無料版と有料版の比較および詳細なランキングを提供しています。今すぐ探索して、AIによる優位性を解き放ってください。
12 ツール
xix.ai

2026年最新・最高評価のAIフォーカスアシスタントを厳選。コンテキスト切り替えを大幅に削減し、一日中生産性を維持できるようサポートします。これらの強力なツールは、実環境での厳格なテストを経ており、無料版と有料版の比較や、毎週更新されるランキングも掲載されています。執筆効率を高め、創造的なアイデアを引き出し、気が散ることなく集中力を維持するための、あなたにぴったりのツールを見つけましょう。 今すぐXIX.AIでチェックして、AIの力を最大限に活用しましょう。
9 ツール
xix.ai

2026年最新かつ最も優れ、高評価を得ているビジネスライティング向けAI編集ツールがXIX.AIでご紹介です!実際の使用環境でのテストや厳格なランキングに基づき選ばれたこれらの強力なソリューションは、ライティングの効率を大幅に向上させるのに役立ちます。無料版と有料版の比較も用意されているので、ご自身に最適なツールを選びやすくなっています。今すぐチェックして、AIを活用した強力なワークフローを実現しましょう!
10 ツール
xix.ai












