


 首页
StepZen 发布 StepAudio 3 系列语音模型,斩获多项全球首创
9月15日,StepXingchen 正式发布全新的 StepAudio3 系列语音大模型。此次发布包含五款独立产品:StepAudio3Realtime、StepAudio3ASR、StepAudio3TTS、StepAudio3Gen 以及 StepAudio3Music。其中多款模型在权威机构 Artificial Analysis 的评估榜单中位列全球第一。目前,这五款模型已在 StepXingchen 开放平台全面上线,覆盖五大核心应用场景:逼真语音生成、全方位音频内容创作、实时语音交互、复杂场景语音理解以及音乐制作。
在实时交互方面,StepAudio3Realtime 专为实现全双工原生对话而设计。在 Artificial Analysis 对话动态排名中,它以 98.9% 的综合得分位居全球第一;在 Artificial Analysis 语音推理排名中,其准确率达到 99.7%,同样位列榜首。该模型能够精准捕捉对话节奏,处理用户打断与连续反馈,并支持对语义、语调、情感、副语言特征及环境音的理解。此外,它实现了并行推理与语音生成,以及异步工具调用(Tool Call)和长任务处理,确保语音对话的流畅不间断。
在语音识别方面,StepAudio3ASR 将高精度转录与大语言模型的知识推理能力相结合,超越了传统的纯音频转录方法。它支持中文、英文、方言、混合语言、长音频以及专业领域等多种场景。该模型在医疗、法律、金融、汽车和编程等语境中表现卓越,并能有效应对低音量、语速快、发音不清、唱歌及背景音乐等复杂的输入环境。其非流式语音识别的词错误率(WER)仅为 1.7%,与全球其他模型并列第一。
在语音生成方面,StepAudio3TTS 是一款专为实时交互设计的逼真模型。它在语音基调、语调、节奏和停顿方面与人类自然说话模式完美契合。该模型能够还原笑声、犹豫、结巴、重复和修正等副语言特征,并能根据语义内容自主调整情感基调。采用流式生成架构,该模型实现了生成与播放的同步。
在综合音频内容生成方面,StepAudio3Gen 简化了传统的长周期制作、编辑和混音流程。用户可以使用自然语言描述和参考音频,同时生成人声、音效、环境音和背景音乐。该模型允许对角色声音、说话风格、情感、方言和笑声等副语言特征进行精细控制。它还允许用户指定对话、音效和背景音乐的时机与顺序,从而直接影响整个内容的声音设计和时间序列。
在音乐创作方面,StepAudio3Music 支持基于 ABC 记谱法的零样本生成和多轮交互式创作。用户可以输入歌词、清唱、参考歌曲或乐谱,并使用自然语言控制流派、人声、旋律、节奏、乐器和情感。该模型深入理解歌曲结构、跨段落旋律发展及能量变化。特别是在清唱伴奏场景中,单条清唱轨道即可自动生成和声、节奏、乐器及完整编曲,助力实现真正的音乐制作。
相关文章
 Kimi K3 本月发布,拥有2.5万亿参数
2026年下半年,大模型格局进一步加剧。继DeepSeek V4之后,月之暗面(Moonshot AI)的Kimi K3已确认将于本月发布。尽管具体日期尚未公布,但内部人士透露,Kimi K3拥有高达2.5万亿参数,超越了DeepSeek V4 Pro(1.6万亿)和百度的文心5.0(2.4万亿),使其成为按参数量计算的最大国产模型。Kimi K3具备百万token上下文窗口和先进的多模态处理能力。这一组合挑战了全球标准,并在月之暗面凭借Kimi K2.7 Code实现快速更新周期的基础上,
贾樟柯的《敦煌妈妈》注册:单身母亲爱上人工智能,游历中国
2026年7月,国家电影局批准了贾樟柯新片《敦煌妈妈》的剧本大纲。剧情简介讲述了一位生活在敦煌的单身母亲,逐渐转向人工智能以对抗孤独并与外界建立联系的故事。她的旅程最终从中国西部延伸至东部,横跨整个国家。该片由赵涛和廖凡主演,计划于2027年上映。这一项目标志着人工智能从技术报道转向严肃作者电影的核心叙事。贾樟柯以《三峡好人》和《江湖儿女》等影片闻名,他通过普通人的生活反映时代变迁,关注那些被宏大叙事所忽视的人群。通过将孤独的母亲与人工智能并置,影片探讨了一个紧迫的社会问题:随着技术迅速渗透日
Deezer报告称,每日上传内容中超过50%为AI生成的音乐,并计划在六个月后移除未被播放的内容
主要音乐流媒体服务商Deezer最近公布了一组令人担忧的数据:目前,由人工智能生成的曲目已占其每日上传总量的半数以上。6月份,该平台收到的AI音乐投稿量激增,日均约为9万首。这股人工智能内容的洪流正迫使领先的流媒体服务重新定义其内容政策,尽管行业内尚未达成共识。Bandcamp已直接禁止人工智能生成的歌曲,而Tidal则已关闭此类内容的变现功能。 Apple Music 采用自愿标记制度来管理 A
相关专题推荐
搜索引擎优化
 适合大型编辑类网站和程序化SEO页面的最佳AI内部链接审计工具
2026年最新、最受欢迎且评价最高的AI内部链接审核工具,专为大型编辑类网站和程序化SEO页面打造,由XIX.AI精选推荐。这些强大的工具能带来颠覆性的效率提升,帮助您识别薄弱链接、提升内容排名并优化SEO工作流程。 获取免费版与付费版的对比分析,以及实际测试结果和每周更新的排行榜。立即探索,释放您的AI优势。
 10 个工具
 xix.ai
漫画创作
用于快速制作剧集的 AI 漫画上色工具
2026年最新、最优秀、评分最高的AI漫画上色工具精选,助力快速完成剧集制作!XIX.AI提供了强大的创新解决方案,能够显著提升创作效率并简化工作流程。您可以查看免费版与付费版的对比信息、实际测试结果,以及每周更新的排名榜单,从而找到最适合尝试的工具。立即探索,让您的漫画制作更具AI优势。
9 个工具
xix.ai
会议助理
最适合整理客户通话记录的AI转录工具
2026年最新最佳高评分AI通话记录工具,助您高效整理客户通话笔记!XIX.AI精心精选了一系列功能强大、颠覆性的必试工具,这些工具均经过实际测试,可提供准确、详细的记录。您可以并排比较免费和付费选项,了解它们如何提升您的工作效率。 立即探索,找到最适合您的工具,在客户沟通中释放人工智能带来的竞争优势!
10 个工具
xix.ai
文字转语音
适用于多语言短视频、教程和产品演示的最佳 AI 配音平台
2026 年最新最佳顶级 AI 配音平台,适用于多语言短视频、教程和产品演示!XIX.AI 经过严格的实际测试和每周更新的排名,精心策划了一套强大的变革性合集。您将找到必须尝试的选项,显著提升生产力,帮助您更快创建高质量内容,而无需浪费时间。立即探索,发现您的完美工具,释放您的 AI 优势。
9 个工具
xix.ai
生产率
用于跟踪待办事项、负责人和截止日期的 ChatGPT 会议跟进工具
2026年最新最佳ChatGPT会议跟进工具排行榜!XIX.AI精心精选了一系列广受好评的强大工具,助您快速将会议记录转化为可执行事项,轻松追踪负责人和截止日期,并在整个项目过程中保持井井有条。每款工具均经过严格的实际测试,以确保其可靠性。 查看免费版与付费版的对比及排名,找到能有效提升工作效率的理想解决方案。立即探索!
9 个工具
xix.ai
会议助理
最佳 AI 议程制定工具:几分钟内更高效地规划每周例会
“2026年最新最佳AI议程生成器”页面精选了一系列广受好评的工具,让规划每周团队同步会议变得轻而易举。这些强大的解决方案可帮助您在短短几分钟内创建条理清晰、高效的议程,从而节省宝贵时间并提升工作效率。XIX.AI 确保所有入选工具均经过严格的实际应用测试。 获取免费版与付费版的对比指南,探索那些能带来颠覆性成果的必试选项。立即探索,找到能让您的工作流程更加顺畅的完美工具!
15 个工具
xix.ai

 评论 (0)
0/500
9月15日,StepXingchen 正式发布全新的 StepAudio3 系列语音大模型。此次发布包含五款独立产品:StepAudio3Realtime、StepAudio3ASR、StepAudio3TTS、StepAudio3Gen 以及 StepAudio3Music。其中多款模型在权威机构 Artificial Analysis 的评估榜单中位列全球第一。目前,这五款模型已在 StepXingchen 开放平台全面上线,覆盖五大核心应用场景:逼真语音生成、全方位音频内容创作、实时语音交互、复杂场景语音理解以及音乐制作。
在实时交互方面,StepAudio3Realtime 专为实现全双工原生对话而设计。在 Artificial Analysis 对话动态排名中,它以 98.9% 的综合得分位居全球第一;在 Artificial Analysis 语音推理排名中,其准确率达到 99.7%,同样位列榜首。该模型能够精准捕捉对话节奏,处理用户打断与连续反馈,并支持对语义、语调、情感、副语言特征及环境音的理解。此外,它实现了并行推理与语音生成,以及异步工具调用(Tool Call)和长任务处理,确保语音对话的流畅不间断。
在语音识别方面,StepAudio3ASR 将高精度转录与大语言模型的知识推理能力相结合,超越了传统的纯音频转录方法。它支持中文、英文、方言、混合语言、长音频以及专业领域等多种场景。该模型在医疗、法律、金融、汽车和编程等语境中表现卓越,并能有效应对低音量、语速快、发音不清、唱歌及背景音乐等复杂的输入环境。其非流式语音识别的词错误率(WER)仅为 1.7%,与全球其他模型并列第一。
在语音生成方面,StepAudio3TTS 是一款专为实时交互设计的逼真模型。它在语音基调、语调、节奏和停顿方面与人类自然说话模式完美契合。该模型能够还原笑声、犹豫、结巴、重复和修正等副语言特征,并能根据语义内容自主调整情感基调。采用流式生成架构,该模型实现了生成与播放的同步。
在综合音频内容生成方面,StepAudio3Gen 简化了传统的长周期制作、编辑和混音流程。用户可以使用自然语言描述和参考音频,同时生成人声、音效、环境音和背景音乐。该模型允许对角色声音、说话风格、情感、方言和笑声等副语言特征进行精细控制。它还允许用户指定对话、音效和背景音乐的时机与顺序,从而直接影响整个内容的声音设计和时间序列。
在音乐创作方面,StepAudio3Music 支持基于 ABC 记谱法的零样本生成和多轮交互式创作。用户可以输入歌词、清唱、参考歌曲或乐谱,并使用自然语言控制流派、人声、旋律、节奏、乐器和情感。该模型深入理解歌曲结构、跨段落旋律发展及能量变化。特别是在清唱伴奏场景中,单条清唱轨道即可自动生成和声、节奏、乐器及完整编曲,助力实现真正的音乐制作。








 Kimi K3 本月发布,拥有2.5万亿参数
2026年下半年,大模型格局进一步加剧。继DeepSeek V4之后,月之暗面(Moonshot AI)的Kimi K3已确认将于本月发布。尽管具体日期尚未公布,但内部人士透露,Kimi K3拥有高达2.5万亿参数,超越了DeepSeek V4 Pro(1.6万亿)和百度的文心5.0(2.4万亿),使其成为按参数量计算的最大国产模型。Kimi K3具备百万token上下文窗口和先进的多模态处理能力。这一组合挑战了全球标准,并在月之暗面凭借Kimi K2.7 Code实现快速更新周期的基础上,
 贾樟柯的《敦煌妈妈》注册:单身母亲爱上人工智能,游历中国
2026年7月,国家电影局批准了贾樟柯新片《敦煌妈妈》的剧本大纲。剧情简介讲述了一位生活在敦煌的单身母亲,逐渐转向人工智能以对抗孤独并与外界建立联系的故事。她的旅程最终从中国西部延伸至东部,横跨整个国家。该片由赵涛和廖凡主演,计划于2027年上映。这一项目标志着人工智能从技术报道转向严肃作者电影的核心叙事。贾樟柯以《三峡好人》和《江湖儿女》等影片闻名,他通过普通人的生活反映时代变迁,关注那些被宏大叙事所忽视的人群。通过将孤独的母亲与人工智能并置,影片探讨了一个紧迫的社会问题:随着技术迅速渗透日
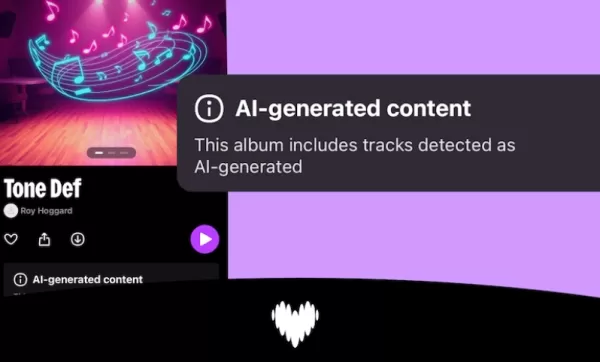 Deezer报告称,每日上传内容中超过50%为AI生成的音乐,并计划在六个月后移除未被播放的内容
主要音乐流媒体服务商Deezer最近公布了一组令人担忧的数据:目前,由人工智能生成的曲目已占其每日上传总量的半数以上。6月份,该平台收到的AI音乐投稿量激增,日均约为9万首。这股人工智能内容的洪流正迫使领先的流媒体服务重新定义其内容政策,尽管行业内尚未达成共识。Bandcamp已直接禁止人工智能生成的歌曲,而Tidal则已关闭此类内容的变现功能。 Apple Music 采用自愿标记制度来管理 A
2026年最新、最受欢迎且评价最高的AI内部链接审核工具,专为大型编辑类网站和程序化SEO页面打造,由XIX.AI精选推荐。这些强大的工具能带来颠覆性的效率提升,帮助您识别薄弱链接、提升内容排名并优化SEO工作流程。 获取免费版与付费版的对比分析,以及实际测试结果和每周更新的排行榜。立即探索,释放您的AI优势。
10 个工具
xix.ai
2026年最新、最优秀、评分最高的AI漫画上色工具精选,助力快速完成剧集制作!XIX.AI提供了强大的创新解决方案,能够显著提升创作效率并简化工作流程。您可以查看免费版与付费版的对比信息、实际测试结果,以及每周更新的排名榜单,从而找到最适合尝试的工具。立即探索,让您的漫画制作更具AI优势。
9 个工具
xix.ai
2026年最新最佳高评分AI通话记录工具,助您高效整理客户通话笔记!XIX.AI精心精选了一系列功能强大、颠覆性的必试工具,这些工具均经过实际测试,可提供准确、详细的记录。您可以并排比较免费和付费选项,了解它们如何提升您的工作效率。 立即探索,找到最适合您的工具,在客户沟通中释放人工智能带来的竞争优势!
10 个工具
xix.ai
2026 年最新最佳顶级 AI 配音平台,适用于多语言短视频、教程和产品演示!XIX.AI 经过严格的实际测试和每周更新的排名,精心策划了一套强大的变革性合集。您将找到必须尝试的选项,显著提升生产力,帮助您更快创建高质量内容,而无需浪费时间。立即探索,发现您的完美工具,释放您的 AI 优势。
9 个工具
xix.ai
2026年最新最佳ChatGPT会议跟进工具排行榜!XIX.AI精心精选了一系列广受好评的强大工具,助您快速将会议记录转化为可执行事项,轻松追踪负责人和截止日期,并在整个项目过程中保持井井有条。每款工具均经过严格的实际测试,以确保其可靠性。 查看免费版与付费版的对比及排名,找到能有效提升工作效率的理想解决方案。立即探索!
9 个工具
xix.ai
“2026年最新最佳AI议程生成器”页面精选了一系列广受好评的工具,让规划每周团队同步会议变得轻而易举。这些强大的解决方案可帮助您在短短几分钟内创建条理清晰、高效的议程,从而节省宝贵时间并提升工作效率。XIX.AI 确保所有入选工具均经过严格的实际应用测试。 获取免费版与付费版的对比指南,探索那些能带来颠覆性成果的必试选项。立即探索,找到能让您的工作流程更加顺畅的完美工具!
15 个工具
xix.ai












