


 家
StepZen、StepAudio 3 シリーズの音声モデルを発表し、複数のグローバル初を達成
9月15日、StepXingchenは新しいStepAudio3シリーズの音声大規模モデルを正式にリリースしました。このリリースには、StepAudio3Realtime、StepAudio3ASR、StepAudio3TTS、StepAudio3Gen、StepAudio3Musicの5つの異なる製品が含まれています。これらのモデルのうちいくつかは、権威あるArtificial Analysisの評価リストで世界トップの位置を確保しています。これら5つのモデルは現在、StepXingchenオープンプラットフォームで完全に利用可能であり、リアルな音声生成、包括的なオーディオコンテンツ作成、リアルタイム音声対話、複雑なシナリオでの音声理解、音楽制作という5つのコアアプリケーションシナリオに対応しています。
リアルタイム対話において、StepAudio3Realtimeはフルデュプレックスのネイティブな会話を提供するように設計されています。Artificial AnalysisのConversational Dynamicsランキングでは総合スコア98.9%で世界第1位を獲得し、Artificial AnalysisのSpeech Reasoningランキングでも99.7%の精度でトップの座を確保しました。このモデルは会話のリズムを正確に捉え、ユーザーの割り込みや継続的なフィードバックを処理し、意味、トーン、感情、パラランゲージ、環境音の理解をサポートします。さらに、並列推論と音声生成、非同期ツール呼び出し(Tool Call)、長時間タスクをサポートし、途切れることのない音声会話を可能にします。
音声認識に関しては、StepAudio3ASRは高精度な文字起こしと大規模言語モデルの知識推論能力を組み合わせ、従来の音声のみによる文字起こし手法を上回っています。中国語、英語、方言、混合言語、長時間の音声、専門分野を含む多様なシナリオをサポートしています。このモデルは医療、法律、金融、自動車、プログラミングの文脈で優れており、小声、高速発話、不明瞭な発音、歌唱、バックグラウンドミュージックといった複雑な入力環境を効果的に処理します。その非ストリーミング音声認識の単語誤り率(WER)はわずか1.7%で、世界で第1位と並んでいます。
音声生成において、StepAudio3TTSはリアルタイム対話用に設計されたリアルなモデルです。声の基調、イントネーション、リズム、休止について自然な人間の発話パターンと完全に一致しています。このモデルは笑い、ためらい、どもり、繰り返し、修正などのパラリンギスティック表現を再現し、意味的なコンテンツに基づいて感情のトーンを自律的に調整することができます。ストリーミング生成アーキテクチャを利用し、生成と再生を同期します。
包括的なオーディオコンテンツ生成において、StepAudio3Genは従来の長時間の制作、編集、ミキシングのプロセスを簡素化します。ユーザーは自然言語の説明と参照音声を使用して、ボーカル、効果音、環境音、バックグラウンドミュージックを同時に生成できます。このモデルは、キャラクターの声、話し方、感情、方言、笑いなどのパラリンギスティック機能の細かな制御を可能にします。また、ユーザーは対話、効果音、バックグラウンドミュージックのタイミングと順序を指定でき、全体のコンテンツのサウンドデザインとタイムシーケンスに直接影響を与えます。
音楽制作において、StepAudio3Musicはゼロショット生成とABC記法に基づく複数ラウンドのインタラクティブな作成をサポートしています。ユーザーは歌詞、アカペラ、参照曲、または楽譜を入力し、自然言語を使用してジャンル、ボーカル、メロディ、リズム、楽器、感情を制御できます。このモデルは曲の構造、段落間のメロディ展開、エネルギーの移行を深く理解しています。特にアカペラ伴奏シナリオでは、単一のアカペラトラックからハーモニー、リズム、楽器、完全なアレンジを自動的に生成し、真の音楽制作を可能にします。
関連記事
 今月発売予定のKimi K3セット、2.5兆パラメータを搭載
2026年後半、大規模モデルの情勢は激化している。DeepSeek V4に加え、Moonshot AIのKimi K3も今月中にリリースされることが確定した。具体的な日付は未だ非公表だが、関係者によると、Kimi K3は最大2.5兆パラメータを備えており、DeepSeek V4 Pro(1.6兆)や百度のWENXIN 5.0(2.4兆)を上回り、パラメータ数において国内最大のモデルとして位置づけられている。Kimi K3は100万トークンのコンテキストウィンドウと高度なマルチモーダル処理を特
賈樟柯の「敦煌ママ」登録:シングルマザーがAIに恋し、中国を旅する
2026年7月、国家映画管理局は賈樟柯監督の新作映画『敦煌ママ』の脚本アウトラインを承認した。あらすじは、孤独な母親が孤独感に対処し、外部世界とつながるために人工知能(AI)に徐々に依存していく、現代の敦煌を舞台とした物語を描いている。彼女の旅は最終的に中国西部から東部へと向かい、全国を横断する。趙濤と廖凡が主演を務める本作は、2027年の公開を予定している。このプロジェクトは、AIが技術的な報道から抜け出し、深刻な作者映画の核心となる物語へと移行する兆しを示している。「三峡好人」や「白銀の城
Deezer、1日のアップロードの50%以上がAI生成の楽曲であると報告、再生されていないコンテンツは6か月後に削除する方針
大手音楽ストリーミングサービス「Deezer」は最近、憂慮すべき統計を明らかにした。同サービスへの1日あたりのアップロード曲のうち、AI生成曲がすでに半数以上を占めているという。6月には、AI音楽の投稿が急増し、1日平均約9万曲が記録された。このAIコンテンツの氾濫により、主要なストリーミングサービス各社はコンテンツポリシーの見直しを迫られているが、業界全体での合意にはまだ至っていない。Bandc
関連特集おすすめ
SEO
 大規模な編集系サイトやプログラム型SEOページに最適なAI内部リンク監査ツール
XIX.AIが厳選した、大規模な編集サイトやプログラマティックSEOページ向けの2026年最新・最高評価のAI内部リンク監査ツール。これらの強力なツールは、脆弱なリンクを特定し、コンテンツのランキングを向上させ、SEOワークフローを効率化することで、画期的な生産性向上を実現します。 無料版と有料版の比較に加え、実地テストの結果や毎週更新されるランキングもご確認いただけます。今すぐチェックして、AIの力を最大限に活用しましょう。
 10 ツール
 xix.ai
漫画制作
エピソード制作を迅速に進めるためのAIコミック着色ツール
2026年最新かつ最高評価を誇るAIコミック着色ツールを厳選!エピソード制作のスピードアップに最適です。XIX.AIは創造性を高め、作業フローを大幅に効率化する強力で革新的なソリューションを提供します。無料版と有料版の比較情報や実際のテスト結果、そして毎週更新されるランキングを確認し、最適なツールを見つけ出しましょう。今すぐチェックして、コミック制作におけるAI活用の強みを手に入れてください。
9 ツール
xix.ai
ミーティングアシスタント
クライアントとの通話記録作成に最適なAI文字起こしツール
2026年版 クライアントとの通話記録に最適な、高評価のAI文字起こしツール!XIX.AIは、実環境でのテストを経て、正確かつ詳細な記録を作成できる、強力で画期的な「必試」ツールを厳選しました。無料版と有料版を並べて比較し、生産性がどのように向上するかをご確認ください。 今すぐチェックして、あなたにぴったりのツールを見つけ、クライアントとのコミュニケーションにおいてAIの力を最大限に活用しましょう!
10 ツール
xix.ai
テキスト読み上げ
多言語のショート動画、チュートリアル、製品ウォークスルーのための最高のAI吹き替えプラットフォーム
2026年最新版・最高評価のAI吹き替えプラットフォーム!多言語ショート動画、チュートリアル、製品デモ向けに厳選!XIX.AIは、厳格な実世界テストと毎週更新されるランキングに基づき、革新的な強力なコレクションを厳選しています。生産性を大幅に向上させ、時間を無駄にせずに高品質なコンテンツを迅速に作成できる必須のオプションが見つかります。今すぐ探索して、あなたの完璧なツールを見つけ、AIによる優位性を解き放ちましょう。
9 ツール
xix.ai
生産性
ChatGPTミーティングのフォローアップツール:アクションアイテム、担当者、期限の管理
2026年最新版!ChatGPTを活用した会議のフォローアップツールランキング!XIX.AIは、会議のメモを迅速に実行項目に変換し、担当者や期限を手間なく追跡し、プロジェクト全体を通じて整理整頓を維持するのに役立つ、高評価の強力なツールを厳選しました。すべてのツールは、信頼性を確保するために厳格な実地テストを経ています。 無料版と有料版の比較やランキングをチェックして、生産性を向上させる最適なソリューションを見つけてください。今すぐチェック!
9 ツール
xix.ai
ミーティングアシスタント
おすすめのAIアジェンダ作成ツール:数分でより効果的な週次打ち合わせを計画しよう
「2026年 最新のAIアジェンダ作成ツール」ページでは、毎週のチームミーティングの計画作成を簡単にする、高評価のツールを厳選して紹介しています。これらの強力なソリューションを使えば、わずか数分で整理された効率的なアジェンダを作成でき、貴重な時間を節約し、生産性を向上させることができます。XIX.AIでは、掲載前にすべてのツールを厳格な実地テストにかけることを徹底しています。 無料版と有料版の比較を確認し、画期的な成果をもたらす「必試」のオプションを発見してください。今すぐチェックして、ワークフローをよりスムーズにする最適なツールを見つけましょう!
15 ツール
xix.ai

 コメント (0)
0/500
9月15日、StepXingchenは新しいStepAudio3シリーズの音声大規模モデルを正式にリリースしました。このリリースには、StepAudio3Realtime、StepAudio3ASR、StepAudio3TTS、StepAudio3Gen、StepAudio3Musicの5つの異なる製品が含まれています。これらのモデルのうちいくつかは、権威あるArtificial Analysisの評価リストで世界トップの位置を確保しています。これら5つのモデルは現在、StepXingchenオープンプラットフォームで完全に利用可能であり、リアルな音声生成、包括的なオーディオコンテンツ作成、リアルタイム音声対話、複雑なシナリオでの音声理解、音楽制作という5つのコアアプリケーションシナリオに対応しています。
リアルタイム対話において、StepAudio3Realtimeはフルデュプレックスのネイティブな会話を提供するように設計されています。Artificial AnalysisのConversational Dynamicsランキングでは総合スコア98.9%で世界第1位を獲得し、Artificial AnalysisのSpeech Reasoningランキングでも99.7%の精度でトップの座を確保しました。このモデルは会話のリズムを正確に捉え、ユーザーの割り込みや継続的なフィードバックを処理し、意味、トーン、感情、パラランゲージ、環境音の理解をサポートします。さらに、並列推論と音声生成、非同期ツール呼び出し(Tool Call)、長時間タスクをサポートし、途切れることのない音声会話を可能にします。
音声認識に関しては、StepAudio3ASRは高精度な文字起こしと大規模言語モデルの知識推論能力を組み合わせ、従来の音声のみによる文字起こし手法を上回っています。中国語、英語、方言、混合言語、長時間の音声、専門分野を含む多様なシナリオをサポートしています。このモデルは医療、法律、金融、自動車、プログラミングの文脈で優れており、小声、高速発話、不明瞭な発音、歌唱、バックグラウンドミュージックといった複雑な入力環境を効果的に処理します。その非ストリーミング音声認識の単語誤り率(WER)はわずか1.7%で、世界で第1位と並んでいます。
音声生成において、StepAudio3TTSはリアルタイム対話用に設計されたリアルなモデルです。声の基調、イントネーション、リズム、休止について自然な人間の発話パターンと完全に一致しています。このモデルは笑い、ためらい、どもり、繰り返し、修正などのパラリンギスティック表現を再現し、意味的なコンテンツに基づいて感情のトーンを自律的に調整することができます。ストリーミング生成アーキテクチャを利用し、生成と再生を同期します。
包括的なオーディオコンテンツ生成において、StepAudio3Genは従来の長時間の制作、編集、ミキシングのプロセスを簡素化します。ユーザーは自然言語の説明と参照音声を使用して、ボーカル、効果音、環境音、バックグラウンドミュージックを同時に生成できます。このモデルは、キャラクターの声、話し方、感情、方言、笑いなどのパラリンギスティック機能の細かな制御を可能にします。また、ユーザーは対話、効果音、バックグラウンドミュージックのタイミングと順序を指定でき、全体のコンテンツのサウンドデザインとタイムシーケンスに直接影響を与えます。
音楽制作において、StepAudio3Musicはゼロショット生成とABC記法に基づく複数ラウンドのインタラクティブな作成をサポートしています。ユーザーは歌詞、アカペラ、参照曲、または楽譜を入力し、自然言語を使用してジャンル、ボーカル、メロディ、リズム、楽器、感情を制御できます。このモデルは曲の構造、段落間のメロディ展開、エネルギーの移行を深く理解しています。特にアカペラ伴奏シナリオでは、単一のアカペラトラックからハーモニー、リズム、楽器、完全なアレンジを自動的に生成し、真の音楽制作を可能にします。








 今月発売予定のKimi K3セット、2.5兆パラメータを搭載
2026年後半、大規模モデルの情勢は激化している。DeepSeek V4に加え、Moonshot AIのKimi K3も今月中にリリースされることが確定した。具体的な日付は未だ非公表だが、関係者によると、Kimi K3は最大2.5兆パラメータを備えており、DeepSeek V4 Pro(1.6兆)や百度のWENXIN 5.0(2.4兆)を上回り、パラメータ数において国内最大のモデルとして位置づけられている。Kimi K3は100万トークンのコンテキストウィンドウと高度なマルチモーダル処理を特
 賈樟柯の「敦煌ママ」登録:シングルマザーがAIに恋し、中国を旅する
2026年7月、国家映画管理局は賈樟柯監督の新作映画『敦煌ママ』の脚本アウトラインを承認した。あらすじは、孤独な母親が孤独感に対処し、外部世界とつながるために人工知能(AI)に徐々に依存していく、現代の敦煌を舞台とした物語を描いている。彼女の旅は最終的に中国西部から東部へと向かい、全国を横断する。趙濤と廖凡が主演を務める本作は、2027年の公開を予定している。このプロジェクトは、AIが技術的な報道から抜け出し、深刻な作者映画の核心となる物語へと移行する兆しを示している。「三峡好人」や「白銀の城
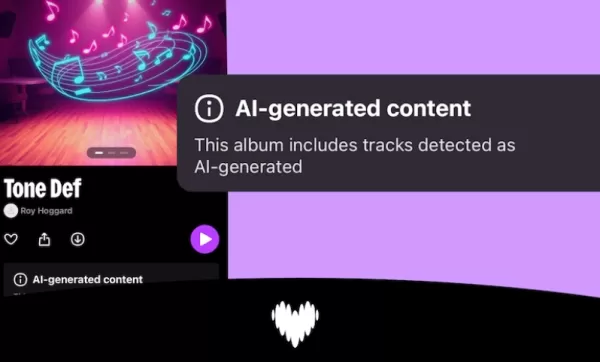 Deezer、1日のアップロードの50%以上がAI生成の楽曲であると報告、再生されていないコンテンツは6か月後に削除する方針
大手音楽ストリーミングサービス「Deezer」は最近、憂慮すべき統計を明らかにした。同サービスへの1日あたりのアップロード曲のうち、AI生成曲がすでに半数以上を占めているという。6月には、AI音楽の投稿が急増し、1日平均約9万曲が記録された。このAIコンテンツの氾濫により、主要なストリーミングサービス各社はコンテンツポリシーの見直しを迫られているが、業界全体での合意にはまだ至っていない。Bandc
XIX.AIが厳選した、大規模な編集サイトやプログラマティックSEOページ向けの2026年最新・最高評価のAI内部リンク監査ツール。これらの強力なツールは、脆弱なリンクを特定し、コンテンツのランキングを向上させ、SEOワークフローを効率化することで、画期的な生産性向上を実現します。 無料版と有料版の比較に加え、実地テストの結果や毎週更新されるランキングもご確認いただけます。今すぐチェックして、AIの力を最大限に活用しましょう。
10 ツール
xix.ai
2026年最新かつ最高評価を誇るAIコミック着色ツールを厳選!エピソード制作のスピードアップに最適です。XIX.AIは創造性を高め、作業フローを大幅に効率化する強力で革新的なソリューションを提供します。無料版と有料版の比較情報や実際のテスト結果、そして毎週更新されるランキングを確認し、最適なツールを見つけ出しましょう。今すぐチェックして、コミック制作におけるAI活用の強みを手に入れてください。
9 ツール
xix.ai
2026年版 クライアントとの通話記録に最適な、高評価のAI文字起こしツール!XIX.AIは、実環境でのテストを経て、正確かつ詳細な記録を作成できる、強力で画期的な「必試」ツールを厳選しました。無料版と有料版を並べて比較し、生産性がどのように向上するかをご確認ください。 今すぐチェックして、あなたにぴったりのツールを見つけ、クライアントとのコミュニケーションにおいてAIの力を最大限に活用しましょう!
10 ツール
xix.ai
2026年最新版・最高評価のAI吹き替えプラットフォーム!多言語ショート動画、チュートリアル、製品デモ向けに厳選!XIX.AIは、厳格な実世界テストと毎週更新されるランキングに基づき、革新的な強力なコレクションを厳選しています。生産性を大幅に向上させ、時間を無駄にせずに高品質なコンテンツを迅速に作成できる必須のオプションが見つかります。今すぐ探索して、あなたの完璧なツールを見つけ、AIによる優位性を解き放ちましょう。
9 ツール
xix.ai
2026年最新版!ChatGPTを活用した会議のフォローアップツールランキング!XIX.AIは、会議のメモを迅速に実行項目に変換し、担当者や期限を手間なく追跡し、プロジェクト全体を通じて整理整頓を維持するのに役立つ、高評価の強力なツールを厳選しました。すべてのツールは、信頼性を確保するために厳格な実地テストを経ています。 無料版と有料版の比較やランキングをチェックして、生産性を向上させる最適なソリューションを見つけてください。今すぐチェック!
9 ツール
xix.ai
「2026年 最新のAIアジェンダ作成ツール」ページでは、毎週のチームミーティングの計画作成を簡単にする、高評価のツールを厳選して紹介しています。これらの強力なソリューションを使えば、わずか数分で整理された効率的なアジェンダを作成でき、貴重な時間を節約し、生産性を向上させることができます。XIX.AIでは、掲載前にすべてのツールを厳格な実地テストにかけることを徹底しています。 無料版と有料版の比較を確認し、画期的な成果をもたらす「必試」のオプションを発見してください。今すぐチェックして、ワークフローをよりスムーズにする最適なツールを見つけましょう!
15 ツール
xix.ai












