


 Hogar
StepZen presenta la serie StepAudio 3 de modelos de voz, asegurando múltiples primeros mundiales
El 15 de septiembre, StepXingchen lanzó oficialmente la nueva serie de modelos de voz grandes StepAudio3. Este lanzamiento incluye cinco productos distintos: StepAudio3Realtime, StepAudio3ASR, StepAudio3TTS, StepAudio3Gen y StepAudio3Music. Varios de estos modelos han alcanzado la posición global número uno en la lista de evaluación autorizada de Artificial Analysis. Estos cinco modelos están ahora completamente disponibles en la plataforma abierta de StepXingchen, cubriendo cinco escenarios de aplicación centrales: generación de voz realista, creación integral de contenido de audio, interacción de voz en tiempo real, comprensión de voz en escenarios complejos y producción musical.
Para la interacción en tiempo real, StepAudio3Realtime está diseñado para ofrecer conversaciones nativas de dúplex completo. Alcanzó el primer lugar a nivel mundial con una puntuación global del 98,9 % en la clasificación de Dinámica Conversacional de Artificial Analysis, y también ocupó el primer puesto en la clasificación de Razonamiento de Voz de Artificial Analysis con una precisión del 99,7 %. El modelo captura con precisión el ritmo conversacional, maneja las interrupciones del usuario y la retroalimentación continua, y admite la comprensión de semántica, tono, emoción, paralingüística y sonidos ambientales. Además, permite el razonamiento paralelo y la generación de voz, junto con llamadas asíncronas a herramientas (Tool Call) y tareas largas, garantizando conversaciones de voz ininterrumpidas.
En cuanto al reconocimiento de voz, StepAudio3ASR combina una transcripción de alta precisión con las capacidades de razonamiento de conocimiento de los modelos de lenguaje grandes, superando los métodos tradicionales de transcripción solo de audio. Admite diversos escenarios, incluyendo chino, inglés, dialectos, idiomas mezclados, audio largo y campos especializados. El modelo destaca en contextos médicos, legales, financieros, automotrices y de programación, y gestiona eficazmente entornos de entrada complejos como volumen bajo, altas velocidades de habla, pronunciación poco clara, canto y música de fondo. Su tasa de error de palabras (WER) en el reconocimiento de voz no en streaming es de solo 1,7 %, empatando en el primer lugar a nivel mundial.
En la generación de voz, StepAudio3TTS es un modelo realista diseñado para la interacción en tiempo real. Se alinea perfectamente con los patrones naturales del habla humana en cuanto a tono base, entonación, ritmo y pausas. El modelo reproduce expresiones paralingüísticas como risas, vacilaciones, tartamudeos, repeticiones y correcciones, y puede ajustar autónomamente los tonos emocionales según el contenido semántico. Utilizando una arquitectura de generación en streaming, el modelo sincroniza la generación y la reproducción.
Para la generación integral de contenido de audio, StepAudio3Gen simplifica el tradicional proceso largo de producción, edición y mezcla. Los usuarios pueden generar voces, efectos de sonido, sonidos ambientales y música de fondo simultáneamente mediante descripciones en lenguaje natural y audio de referencia. El modelo permite un control fino sobre características paralingüísticas como la voz del personaje, el estilo de habla, la emoción, los dialectos y las risas. También permite a los usuarios especificar el momento y la secuencia del diálogo, los efectos de sonido y la música de fondo, influyendo directamente en el diseño sonoro y la secuenciación temporal de todo el contenido.
En la creación musical, StepAudio3Music admite tanto la generación de cero intentos como la creación interactiva en múltiples rondas basada en notación ABC. Los usuarios pueden introducir letras, a capella, canciones de referencia o notación, y utilizar lenguaje natural para controlar el género, las voces, la melodía, el ritmo, los instrumentos y las emociones. El modelo comprende profundamente la estructura de la canción, el desarrollo melódico entre párrafos y los cambios de energía. Particularmente en escenarios de acompañamiento a capella, una sola pista a capella puede generar automáticamente armonía, ritmo, instrumentos y arreglos completos, facilitando una verdadera producción musical.
Artículo relacionado
 Kimi K3 se lanza este mes con 2,5 billones de parámetros
El panorama de los modelos grandes se ha intensificado en la segunda mitad de 2026. Junto con DeepSeek V4, se confirma que Kimi K3 de Moonshot AI se lanzará este mes.Aunque las fechas específicas siguen sin revelarse, fuentes internas informan que K
La película de Jia Zhangke 'Madre de Dunhuang' se registró: Madre soltera se enamora de la IA, viaja por China
En julio de 2026, la Administración Nacional de Cine aprobó el esquema del guion de la próxima película de Jia Zhangke, "Dunhuang Mama". La sinopsis describe una historia contemporánea de una madre soltera en Dunhuang que recurre gradualmente a la in
Deezer informa de que más del 50 % de las subidas diarias son música generada por IA y tiene previsto eliminar el contenido no reproducido al cabo de seis meses
Deezer, uno de los principales servicios de streaming musical, ha revelado recientemente unas estadísticas alarmantes: las canciones generadas por IA representan ya más de la mitad de las subidas diar
Recomendaciones de temas especiales relacionados
SEO
 Mejores auditores de enlaces internos con IA para grandes sitios editoriales y páginas de SEO programático
2026 Últimas Mejores Valoradas Herramientas de Auditoría de Enlaces Internos con IA para Grandes Sitios Editoriales y Páginas de SEO Programático, seleccionadas por XIX.AI. Estas potentes herramientas ofrecen una eficiencia revolucionaria para identificar enlaces débiles, mejorar el posicionamiento del contenido y optimizar los flujos de trabajo de SEO. Obtén una comparación gratuita entre versiones gratuitas y de pago junto con pruebas del mundo real y clasificaciones actualizadas semanalmente. Explora ahora para desbloquear tu ventaja con IA.
 10 herramientas
 xix.ai
Creación de cómics
Herramientas de coloreado de cómics con IA para una producción rápida de episodios
¡Herramientas 2026 más recientes, mejores y mejor calificadas para colorear cómics con IA, seleccionadas especialmente para una producción rápida de episodios! XIX.AI ofrece soluciones potentes que revolucionan el proceso, impulsan la creatividad y optimizan significativamente los flujos de trabajo. Obtenga una comparación gratuita contra las versiones de pago, vea pruebas en entornos reales y acceda a clasificaciones actualizadas semanalmente para ayudarlo a encontrar la herramienta perfecta que debe probar. Explore ahora mismo y aproveche toda la ventaja que le brinda la IA en la producción de cómics.
9 herramientas
xix.ai
Asistente de reuniones
Las mejores herramientas de transcripción con IA para las notas de las llamadas con los clientes
¡Las mejores herramientas de transcripción con IA mejor valoradas de 2026 para las notas de las llamadas con los clientes! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, sometidas a pruebas en el mundo real para ofrecer notas precisas y detalladas. Puedes comparar las opciones gratuitas y de pago y ver cómo aumentan tu productividad. ¡Explora ahora mismo para descubrir tu herramienta perfecta y sacar el máximo partido a la IA en la comunicación con tus clientes!
10 herramientas
xix.ai
Texto a voz
Las mejores plataformas de doblaje con IA para videos cortos multilingües, tutoriales y recorridos por productos
¡Las mejores plataformas de doblaje con IA de 2026, mejor valoradas y de primer nivel para cortos multilingües, tutoriales y recorridos por productos! XIX.AI selecciona una poderosa colección transformadora tras rigurosas pruebas en el mundo real y clasificaciones actualizadas semanalmente. Encontrarás opciones imprescindibles que aumentan significativamente la productividad, ayudándote a crear contenido de alta calidad más rápido sin perder tiempo. Explora ahora para descubrir tu herramienta perfecta y desbloquear tu ventaja con IA.
9 herramientas
xix.ai
Productividad
Herramientas de seguimiento de reuniones de ChatGPT para el control de tareas pendientes, responsables y plazos
¡Clasificación de las mejores herramientas de 2026 para el seguimiento de reuniones con ChatGPT! XIX.AI ha seleccionado una colección de herramientas potentes y muy bien valoradas que te ayudan a convertir rápidamente las notas de las reuniones en acciones concretas, a realizar un seguimiento de los responsables y los plazos sin esfuerzo, y a mantenerte organizado a lo largo de tus proyectos. Cada herramienta se somete a rigurosas pruebas en condiciones reales para garantizar su fiabilidad. Echa un vistazo a la comparación entre las versiones gratuitas y de pago, así como a las clasificaciones, para descubrir la solución perfecta que te permita aumentar tu productividad. ¡Explora ahora!
9 herramientas
xix.ai
Asistente de reuniones
Los mejores creadores de agendas basados en IA: planifica mejor tus reuniones semanales en cuestión de minutos
La página «Los mejores creadores de órdenes del día con IA de 2026» presenta una selección de las herramientas mejor valoradas que facilitan la planificación de las reuniones semanales del equipo. Estas potentes soluciones te ayudan a crear órdenes del día organizadas y eficientes en solo unos minutos, lo que te permite ahorrar un tiempo valioso y aumentar la productividad. XIX.AI se asegura de que todas las herramientas pasen por rigurosas pruebas en condiciones reales antes de incluirlas. Consigue una comparación entre las versiones gratuitas y de pago y descubre las opciones imprescindibles que ofrecen resultados revolucionarios. ¡Explora ahora mismo para encontrar la herramienta perfecta que te permita optimizar tus flujos de trabajo!
15 herramientas
xix.ai

 comentario (0)
0/500
El 15 de septiembre, StepXingchen lanzó oficialmente la nueva serie de modelos de voz grandes StepAudio3. Este lanzamiento incluye cinco productos distintos: StepAudio3Realtime, StepAudio3ASR, StepAudio3TTS, StepAudio3Gen y StepAudio3Music. Varios de estos modelos han alcanzado la posición global número uno en la lista de evaluación autorizada de Artificial Analysis. Estos cinco modelos están ahora completamente disponibles en la plataforma abierta de StepXingchen, cubriendo cinco escenarios de aplicación centrales: generación de voz realista, creación integral de contenido de audio, interacción de voz en tiempo real, comprensión de voz en escenarios complejos y producción musical.
Para la interacción en tiempo real, StepAudio3Realtime está diseñado para ofrecer conversaciones nativas de dúplex completo. Alcanzó el primer lugar a nivel mundial con una puntuación global del 98,9 % en la clasificación de Dinámica Conversacional de Artificial Analysis, y también ocupó el primer puesto en la clasificación de Razonamiento de Voz de Artificial Analysis con una precisión del 99,7 %. El modelo captura con precisión el ritmo conversacional, maneja las interrupciones del usuario y la retroalimentación continua, y admite la comprensión de semántica, tono, emoción, paralingüística y sonidos ambientales. Además, permite el razonamiento paralelo y la generación de voz, junto con llamadas asíncronas a herramientas (Tool Call) y tareas largas, garantizando conversaciones de voz ininterrumpidas.
En cuanto al reconocimiento de voz, StepAudio3ASR combina una transcripción de alta precisión con las capacidades de razonamiento de conocimiento de los modelos de lenguaje grandes, superando los métodos tradicionales de transcripción solo de audio. Admite diversos escenarios, incluyendo chino, inglés, dialectos, idiomas mezclados, audio largo y campos especializados. El modelo destaca en contextos médicos, legales, financieros, automotrices y de programación, y gestiona eficazmente entornos de entrada complejos como volumen bajo, altas velocidades de habla, pronunciación poco clara, canto y música de fondo. Su tasa de error de palabras (WER) en el reconocimiento de voz no en streaming es de solo 1,7 %, empatando en el primer lugar a nivel mundial.
En la generación de voz, StepAudio3TTS es un modelo realista diseñado para la interacción en tiempo real. Se alinea perfectamente con los patrones naturales del habla humana en cuanto a tono base, entonación, ritmo y pausas. El modelo reproduce expresiones paralingüísticas como risas, vacilaciones, tartamudeos, repeticiones y correcciones, y puede ajustar autónomamente los tonos emocionales según el contenido semántico. Utilizando una arquitectura de generación en streaming, el modelo sincroniza la generación y la reproducción.
Para la generación integral de contenido de audio, StepAudio3Gen simplifica el tradicional proceso largo de producción, edición y mezcla. Los usuarios pueden generar voces, efectos de sonido, sonidos ambientales y música de fondo simultáneamente mediante descripciones en lenguaje natural y audio de referencia. El modelo permite un control fino sobre características paralingüísticas como la voz del personaje, el estilo de habla, la emoción, los dialectos y las risas. También permite a los usuarios especificar el momento y la secuencia del diálogo, los efectos de sonido y la música de fondo, influyendo directamente en el diseño sonoro y la secuenciación temporal de todo el contenido.
En la creación musical, StepAudio3Music admite tanto la generación de cero intentos como la creación interactiva en múltiples rondas basada en notación ABC. Los usuarios pueden introducir letras, a capella, canciones de referencia o notación, y utilizar lenguaje natural para controlar el género, las voces, la melodía, el ritmo, los instrumentos y las emociones. El modelo comprende profundamente la estructura de la canción, el desarrollo melódico entre párrafos y los cambios de energía. Particularmente en escenarios de acompañamiento a capella, una sola pista a capella puede generar automáticamente armonía, ritmo, instrumentos y arreglos completos, facilitando una verdadera producción musical.








 Kimi K3 se lanza este mes con 2,5 billones de parámetros
El panorama de los modelos grandes se ha intensificado en la segunda mitad de 2026. Junto con DeepSeek V4, se confirma que Kimi K3 de Moonshot AI se lanzará este mes.Aunque las fechas específicas siguen sin revelarse, fuentes internas informan que K
 La película de Jia Zhangke 'Madre de Dunhuang' se registró: Madre soltera se enamora de la IA, viaja por China
En julio de 2026, la Administración Nacional de Cine aprobó el esquema del guion de la próxima película de Jia Zhangke, "Dunhuang Mama". La sinopsis describe una historia contemporánea de una madre soltera en Dunhuang que recurre gradualmente a la in
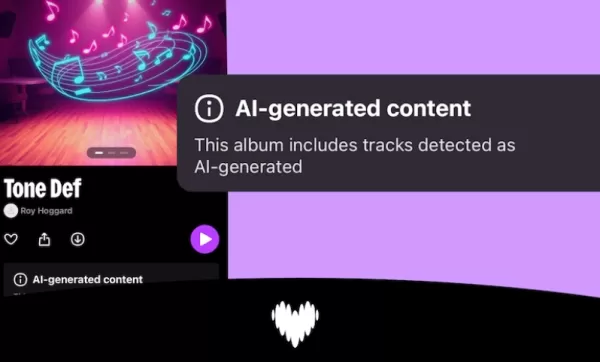 Deezer informa de que más del 50 % de las subidas diarias son música generada por IA y tiene previsto eliminar el contenido no reproducido al cabo de seis meses
Deezer, uno de los principales servicios de streaming musical, ha revelado recientemente unas estadísticas alarmantes: las canciones generadas por IA representan ya más de la mitad de las subidas diar
2026 Últimas Mejores Valoradas Herramientas de Auditoría de Enlaces Internos con IA para Grandes Sitios Editoriales y Páginas de SEO Programático, seleccionadas por XIX.AI. Estas potentes herramientas ofrecen una eficiencia revolucionaria para identificar enlaces débiles, mejorar el posicionamiento del contenido y optimizar los flujos de trabajo de SEO. Obtén una comparación gratuita entre versiones gratuitas y de pago junto con pruebas del mundo real y clasificaciones actualizadas semanalmente. Explora ahora para desbloquear tu ventaja con IA.
10 herramientas
xix.ai
¡Herramientas 2026 más recientes, mejores y mejor calificadas para colorear cómics con IA, seleccionadas especialmente para una producción rápida de episodios! XIX.AI ofrece soluciones potentes que revolucionan el proceso, impulsan la creatividad y optimizan significativamente los flujos de trabajo. Obtenga una comparación gratuita contra las versiones de pago, vea pruebas en entornos reales y acceda a clasificaciones actualizadas semanalmente para ayudarlo a encontrar la herramienta perfecta que debe probar. Explore ahora mismo y aproveche toda la ventaja que le brinda la IA en la producción de cómics.
9 herramientas
xix.ai
¡Las mejores herramientas de transcripción con IA mejor valoradas de 2026 para las notas de las llamadas con los clientes! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, sometidas a pruebas en el mundo real para ofrecer notas precisas y detalladas. Puedes comparar las opciones gratuitas y de pago y ver cómo aumentan tu productividad. ¡Explora ahora mismo para descubrir tu herramienta perfecta y sacar el máximo partido a la IA en la comunicación con tus clientes!
10 herramientas
xix.ai
¡Las mejores plataformas de doblaje con IA de 2026, mejor valoradas y de primer nivel para cortos multilingües, tutoriales y recorridos por productos! XIX.AI selecciona una poderosa colección transformadora tras rigurosas pruebas en el mundo real y clasificaciones actualizadas semanalmente. Encontrarás opciones imprescindibles que aumentan significativamente la productividad, ayudándote a crear contenido de alta calidad más rápido sin perder tiempo. Explora ahora para descubrir tu herramienta perfecta y desbloquear tu ventaja con IA.
9 herramientas
xix.ai
¡Clasificación de las mejores herramientas de 2026 para el seguimiento de reuniones con ChatGPT! XIX.AI ha seleccionado una colección de herramientas potentes y muy bien valoradas que te ayudan a convertir rápidamente las notas de las reuniones en acciones concretas, a realizar un seguimiento de los responsables y los plazos sin esfuerzo, y a mantenerte organizado a lo largo de tus proyectos. Cada herramienta se somete a rigurosas pruebas en condiciones reales para garantizar su fiabilidad. Echa un vistazo a la comparación entre las versiones gratuitas y de pago, así como a las clasificaciones, para descubrir la solución perfecta que te permita aumentar tu productividad. ¡Explora ahora!
9 herramientas
xix.ai
La página «Los mejores creadores de órdenes del día con IA de 2026» presenta una selección de las herramientas mejor valoradas que facilitan la planificación de las reuniones semanales del equipo. Estas potentes soluciones te ayudan a crear órdenes del día organizadas y eficientes en solo unos minutos, lo que te permite ahorrar un tiempo valioso y aumentar la productividad. XIX.AI se asegura de que todas las herramientas pasen por rigurosas pruebas en condiciones reales antes de incluirlas. Consigue una comparación entre las versiones gratuitas y de pago y descubre las opciones imprescindibles que ofrecen resultados revolucionarios. ¡Explora ahora mismo para encontrar la herramienta perfecta que te permita optimizar tus flujos de trabajo!
15 herramientas
xix.ai












