


 Lar
A StepZen apresenta a série StepAudio 3 de modelos de voz, garantindo múltiplos primeiros lugares globais
Em 15 de setembro, a StepXingchen lançou oficialmente a nova série de modelos de linguagem de voz StepAudio3. Este lançamento apresenta cinco produtos distintos: StepAudio3Realtime, StepAudio3ASR, StepAudio3TTS, StepAudio3Gen e StepAudio3Music. Vários desses modelos conquistaram a primeira posição global na lista de avaliação da Artificial Analysis, uma autoridade reconhecida. Estes cinco modelos estão agora totalmente disponíveis na plataforma aberta da StepXingchen, atendendo a cinco cenários de aplicação principais: geração de voz realista, criação abrangente de conteúdo de áudio, interação de voz em tempo real, compreensão de voz em cenários complexos e produção musical.
Para interação em tempo real, o StepAudio3Realtime foi projetado para oferecer conversas nativas full-duplex. Ele alcançou a primeira posição global com uma pontuação geral de 98,9% no ranking de Dinâmica Conversacional da Artificial Analysis, e também ocupou o primeiro lugar no ranking de Raciocínio de Fala da Artificial Analysis, com uma precisão de 99,7%. O modelo captura com precisão o ritmo da conversa, lida com interrupções do usuário e feedback contínuo, e suporta a compreensão de semântica, tom, emoção, paralinguística e sons ambientes. Além disso, ele permite raciocínio paralelo e geração de voz, bem como chamadas de ferramentas assíncronas (Tool Call) e tarefas longas, garantindo conversas de voz ininterruptas.
No que diz respeito ao reconhecimento de fala, o StepAudio3ASR combina transcrição de alta precisão com as capacidades de raciocínio de conhecimento de grandes modelos de linguagem, superando os métodos tradicionais de transcrição apenas de áudio. Ele suporta diversos cenários, incluindo chinês, inglês, dialetos, linguagem mista, áudio longo e campos especializados. O modelo se destaca em contextos médicos, jurídicos, financeiros, automotivos e de programação, e gerencia eficazmente ambientes de entrada complexos, como volume baixo, alta velocidade de fala, pronúncia imprecisa, canto e música de fundo. Sua taxa de erro de palavra (WER) em reconhecimento de fala não em streaming é de apenas 1,7%, empatando na primeira posição global.
Na geração de voz, o StepAudio3TTS é um modelo realista projetado para interação em tempo real. Ele se alinha perfeitamente aos padrões naturais de fala humana em relação à base da voz, entonação, ritmo e pausas. O modelo reproduz expressões paralinguísticas como risos, hesitações, gagueiras, repetições e correções, e pode ajustar autonomamente os tons emocionais com base no conteúdo semântico. Utilizando uma arquitetura de geração em streaming, o modelo sincroniza a geração e a reprodução.
Para a geração abrangente de conteúdo de áudio, o StepAudio3Gen simplifica o tradicional processo longo de produção, edição e mixagem. Os usuários podem gerar vocais, efeitos sonoros, sons ambientes e música de fundo simultaneamente usando descrições em linguagem natural e áudio de referência. O modelo permite controle fino sobre características paralinguísticas, como voz do personagem, estilo de fala, emoção, dialetos e risos. Ele também permite que os usuários especifiquem o momento e a sequência de diálogos, efeitos sonoros e música de fundo, influenciando diretamente o design sonoro e a sequência temporal de todo o conteúdo.
Na criação musical, o StepAudio3Music suporta tanto a geração zero-shot quanto a criação interativa em múltiplas rodadas baseada na notação ABC. Os usuários podem inserir letras, a cappella, músicas de referência ou notação, e usar linguagem natural para controlar gênero, vocais, melodia, ritmo, instrumentos e emoções. O modelo compreende profundamente a estrutura da música, o desenvolvimento melódico entre parágrafos e as variações de energia. Particularmente em cenários de acompanhamento a cappella, uma única faixa a cappella pode gerar automaticamente harmonia, ritmo, instrumentos e arranjos completos, facilitando a verdadeira produção musical.
Artigo relacionado
 Conjunto Kimi K3 para lançamento este mês com 2,5 trilhão de parâmetros
O panorama de grandes modelos intensificou-se na segunda metade de 2026. Junto com o DeepSeek V4, o Kimi K3 da Moonshot AI está confirmado para lançamento este mês.Embora as datas específicas permaneçam não divulgadas, fontes internas relatam que o
O “Dunhuang Mama” de Jia Zhangke Registrou-se: Mãe Solteira Apaixona-se por IA, Viaja pela China
Em julho de 2026, a Administração Nacional de Cinema aprovou o esboço do roteiro do próximo filme de Jia Zhangke, "Dunhuang Mama". A sinopse retrata uma história contemporânea de uma mãe solteira em Dunhuang que, gradualmente, recorre à inteligência
A Deezer informa que mais de 50% dos uploads diários são músicas geradas por IA e planeja remover o conteúdo não reproduzido após seis meses
O Deezer, um importante serviço de streaming de música, revelou recentemente estatísticas alarmantes: as faixas geradas por IA agora representam mais da metade dos envios diários à plataforma. Em junh
Recomendações de tópicos especiais relacionados
SEO
 Os melhores auditores de links internos com IA para grandes sites editoriais e páginas de SEO programático
2026: os melhores e mais bem avaliados auditores de links internos com IA para grandes sites editoriais e páginas de SEO programático, selecionados pela XIX.AI. Essas ferramentas poderosas oferecem uma eficiência revolucionária para identificar links fracos, impulsionar a classificação do conteúdo e otimizar os fluxos de trabalho de SEO. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente. Explore agora para aproveitar sua vantagem com IA.
 10 ferramentas
 xix.ai
Criação de quadrinhos
Ferramentas de coloração de quadrinhos com IA para produção rápida de episódios
2026 – As melhores e mais bem avaliadas ferramentas de coloração de quadrinhos com IA, selecionadas especialmente para uma produção rápida de episódios! A XIX.AI oferece soluções poderosas que revolucionam o processo criativo e otimizam significativamente os fluxos de trabalho. Confira uma comparação entre as versões gratuitas e pagas, veja testes reais e acesse rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita a ser experimentada. Explore agora e aproveite toda a vantagem oferecida pela IA na produção de quadrinhos.
9 ferramentas
xix.ai
Assistente de Reunião
As melhores ferramentas de transcrição com IA para anotações de chamadas com clientes
As melhores e mais bem avaliadas ferramentas de transcrição com IA de 2026 para anotações de chamadas com clientes! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que passam por testes práticos para oferecer anotações precisas e detalhadas. Você pode comparar lado a lado as opções gratuitas e pagas e ver como elas aumentam sua produtividade. Explore agora para descobrir a ferramenta perfeita para você e aproveitar toda a vantagem da IA na comunicação com clientes!
10 ferramentas
xix.ai
Conversão de texto para fala
Melhores plataformas de dublagem por IA para vídeos curtos multilíngues, tutoriais e demonstrações de produtos
2026 Últimas Melhores Plataformas de Dublagem por IA Mais Bem Avaliadas para Vídeos Curtos Multilíngues, Tutoriais e Demonstrações de Produtos! A XIX.AI seleciona uma poderosa coleção transformadora após rigorosos testes no mundo real e rankings atualizados semanalmente. Você encontrará opções imperdíveis que aumentam significativamente a produtividade, ajudando você a criar conteúdo de alta qualidade mais rapidamente sem desperdiçar tempo. Explore agora para descobrir sua ferramenta perfeita e desbloqueie sua vantagem com IA.
9 ferramentas
xix.ai
Produtividade
Ferramentas de acompanhamento de reuniões do ChatGPT para itens de ação, responsáveis e acompanhamento de prazos
2026: Classificação das melhores e mais recentes ferramentas de acompanhamento de reuniões do ChatGPT! A XIX.AI selecionou uma coleção das ferramentas mais bem avaliadas e poderosas, que ajudam você a transformar rapidamente as anotações de reuniões em ações concretas, acompanhar responsáveis e prazos sem esforço e manter-se organizado ao longo de seus projetos. Cada ferramenta passa por rigorosos testes práticos para garantir sua confiabilidade. Confira a comparação entre versões gratuitas e pagas e os rankings para descobrir a solução perfeita para aumentar sua produtividade. Explore agora!
9 ferramentas
xix.ai
Assistente de Reunião
Os melhores criadores de agendas com IA: planeje melhor suas reuniões semanais em poucos minutos
A página “Os melhores criadores de agendas com IA de 2026” apresenta uma lista selecionada das ferramentas mais bem avaliadas, que facilitam o planejamento das reuniões semanais da equipe. Essas soluções poderosas ajudam você a criar agendas organizadas e eficientes em apenas alguns minutos, economizando tempo valioso e aumentando a produtividade. A XIX.AI garante que todas as ferramentas passem por rigorosos testes práticos antes de serem incluídas. Veja uma comparação entre as versões gratuita e paga e descubra as opções imperdíveis que oferecem resultados revolucionários. Explore agora para encontrar a ferramenta perfeita para fluxos de trabalho mais ágeis!
15 ferramentas
xix.ai

 Comentários (0)
Em 15 de setembro, a StepXingchen lançou oficialmente a nova série de modelos de linguagem de voz StepAudio3. Este lançamento apresenta cinco produtos distintos: StepAudio3Realtime, StepAudio3ASR, StepAudio3TTS, StepAudio3Gen e StepAudio3Music. Vários desses modelos conquistaram a primeira posição global na lista de avaliação da Artificial Analysis, uma autoridade reconhecida. Estes cinco modelos estão agora totalmente disponíveis na plataforma aberta da StepXingchen, atendendo a cinco cenários de aplicação principais: geração de voz realista, criação abrangente de conteúdo de áudio, interação de voz em tempo real, compreensão de voz em cenários complexos e produção musical.
Para interação em tempo real, o StepAudio3Realtime foi projetado para oferecer conversas nativas full-duplex. Ele alcançou a primeira posição global com uma pontuação geral de 98,9% no ranking de Dinâmica Conversacional da Artificial Analysis, e também ocupou o primeiro lugar no ranking de Raciocínio de Fala da Artificial Analysis, com uma precisão de 99,7%. O modelo captura com precisão o ritmo da conversa, lida com interrupções do usuário e feedback contínuo, e suporta a compreensão de semântica, tom, emoção, paralinguística e sons ambientes. Além disso, ele permite raciocínio paralelo e geração de voz, bem como chamadas de ferramentas assíncronas (Tool Call) e tarefas longas, garantindo conversas de voz ininterruptas.
No que diz respeito ao reconhecimento de fala, o StepAudio3ASR combina transcrição de alta precisão com as capacidades de raciocínio de conhecimento de grandes modelos de linguagem, superando os métodos tradicionais de transcrição apenas de áudio. Ele suporta diversos cenários, incluindo chinês, inglês, dialetos, linguagem mista, áudio longo e campos especializados. O modelo se destaca em contextos médicos, jurídicos, financeiros, automotivos e de programação, e gerencia eficazmente ambientes de entrada complexos, como volume baixo, alta velocidade de fala, pronúncia imprecisa, canto e música de fundo. Sua taxa de erro de palavra (WER) em reconhecimento de fala não em streaming é de apenas 1,7%, empatando na primeira posição global.
Na geração de voz, o StepAudio3TTS é um modelo realista projetado para interação em tempo real. Ele se alinha perfeitamente aos padrões naturais de fala humana em relação à base da voz, entonação, ritmo e pausas. O modelo reproduz expressões paralinguísticas como risos, hesitações, gagueiras, repetições e correções, e pode ajustar autonomamente os tons emocionais com base no conteúdo semântico. Utilizando uma arquitetura de geração em streaming, o modelo sincroniza a geração e a reprodução.
Para a geração abrangente de conteúdo de áudio, o StepAudio3Gen simplifica o tradicional processo longo de produção, edição e mixagem. Os usuários podem gerar vocais, efeitos sonoros, sons ambientes e música de fundo simultaneamente usando descrições em linguagem natural e áudio de referência. O modelo permite controle fino sobre características paralinguísticas, como voz do personagem, estilo de fala, emoção, dialetos e risos. Ele também permite que os usuários especifiquem o momento e a sequência de diálogos, efeitos sonoros e música de fundo, influenciando diretamente o design sonoro e a sequência temporal de todo o conteúdo.
Na criação musical, o StepAudio3Music suporta tanto a geração zero-shot quanto a criação interativa em múltiplas rodadas baseada na notação ABC. Os usuários podem inserir letras, a cappella, músicas de referência ou notação, e usar linguagem natural para controlar gênero, vocais, melodia, ritmo, instrumentos e emoções. O modelo compreende profundamente a estrutura da música, o desenvolvimento melódico entre parágrafos e as variações de energia. Particularmente em cenários de acompanhamento a cappella, uma única faixa a cappella pode gerar automaticamente harmonia, ritmo, instrumentos e arranjos completos, facilitando a verdadeira produção musical.








 Conjunto Kimi K3 para lançamento este mês com 2,5 trilhão de parâmetros
O panorama de grandes modelos intensificou-se na segunda metade de 2026. Junto com o DeepSeek V4, o Kimi K3 da Moonshot AI está confirmado para lançamento este mês.Embora as datas específicas permaneçam não divulgadas, fontes internas relatam que o
 O “Dunhuang Mama” de Jia Zhangke Registrou-se: Mãe Solteira Apaixona-se por IA, Viaja pela China
Em julho de 2026, a Administração Nacional de Cinema aprovou o esboço do roteiro do próximo filme de Jia Zhangke, "Dunhuang Mama". A sinopse retrata uma história contemporânea de uma mãe solteira em Dunhuang que, gradualmente, recorre à inteligência
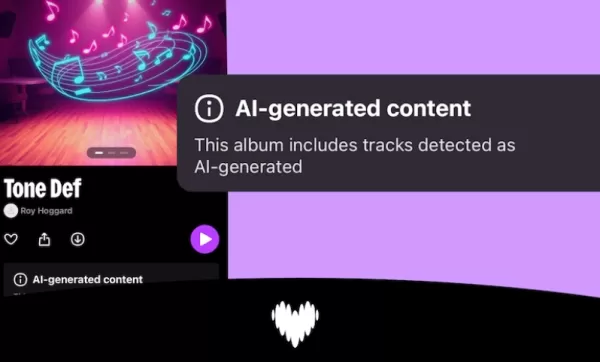 A Deezer informa que mais de 50% dos uploads diários são músicas geradas por IA e planeja remover o conteúdo não reproduzido após seis meses
O Deezer, um importante serviço de streaming de música, revelou recentemente estatísticas alarmantes: as faixas geradas por IA agora representam mais da metade dos envios diários à plataforma. Em junh
2026: os melhores e mais bem avaliados auditores de links internos com IA para grandes sites editoriais e páginas de SEO programático, selecionados pela XIX.AI. Essas ferramentas poderosas oferecem uma eficiência revolucionária para identificar links fracos, impulsionar a classificação do conteúdo e otimizar os fluxos de trabalho de SEO. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente. Explore agora para aproveitar sua vantagem com IA.
10 ferramentas
xix.ai
2026 – As melhores e mais bem avaliadas ferramentas de coloração de quadrinhos com IA, selecionadas especialmente para uma produção rápida de episódios! A XIX.AI oferece soluções poderosas que revolucionam o processo criativo e otimizam significativamente os fluxos de trabalho. Confira uma comparação entre as versões gratuitas e pagas, veja testes reais e acesse rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita a ser experimentada. Explore agora e aproveite toda a vantagem oferecida pela IA na produção de quadrinhos.
9 ferramentas
xix.ai
As melhores e mais bem avaliadas ferramentas de transcrição com IA de 2026 para anotações de chamadas com clientes! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que passam por testes práticos para oferecer anotações precisas e detalhadas. Você pode comparar lado a lado as opções gratuitas e pagas e ver como elas aumentam sua produtividade. Explore agora para descobrir a ferramenta perfeita para você e aproveitar toda a vantagem da IA na comunicação com clientes!
10 ferramentas
xix.ai
2026 Últimas Melhores Plataformas de Dublagem por IA Mais Bem Avaliadas para Vídeos Curtos Multilíngues, Tutoriais e Demonstrações de Produtos! A XIX.AI seleciona uma poderosa coleção transformadora após rigorosos testes no mundo real e rankings atualizados semanalmente. Você encontrará opções imperdíveis que aumentam significativamente a produtividade, ajudando você a criar conteúdo de alta qualidade mais rapidamente sem desperdiçar tempo. Explore agora para descobrir sua ferramenta perfeita e desbloqueie sua vantagem com IA.
9 ferramentas
xix.ai
2026: Classificação das melhores e mais recentes ferramentas de acompanhamento de reuniões do ChatGPT! A XIX.AI selecionou uma coleção das ferramentas mais bem avaliadas e poderosas, que ajudam você a transformar rapidamente as anotações de reuniões em ações concretas, acompanhar responsáveis e prazos sem esforço e manter-se organizado ao longo de seus projetos. Cada ferramenta passa por rigorosos testes práticos para garantir sua confiabilidade. Confira a comparação entre versões gratuitas e pagas e os rankings para descobrir a solução perfeita para aumentar sua produtividade. Explore agora!
9 ferramentas
xix.ai
A página “Os melhores criadores de agendas com IA de 2026” apresenta uma lista selecionada das ferramentas mais bem avaliadas, que facilitam o planejamento das reuniões semanais da equipe. Essas soluções poderosas ajudam você a criar agendas organizadas e eficientes em apenas alguns minutos, economizando tempo valioso e aumentando a produtividade. A XIX.AI garante que todas as ferramentas passem por rigorosos testes práticos antes de serem incluídas. Veja uma comparação entre as versões gratuita e paga e descubra as opções imperdíveis que oferecem resultados revolucionários. Explore agora para encontrar a ferramenta perfeita para fluxos de trabalho mais ágeis!
15 ferramentas
xix.ai












