


 Maison
StepZen dévoile le modèle vocal StepAudio 3 Series, remportant plusieurs premières mondiales
Le 15 septembre, StepXingchen a officiellement lancé la nouvelle série de modèles de langage vocal StepAudio3. Ce lancement comprend cinq produits distincts : StepAudio3Realtime, StepAudio3ASR, StepAudio3TTS, StepAudio3Gen et StepAudio3Music. Plusieurs de ces modèles ont obtenu la première place mondiale sur la liste d’évaluation authoritative d’Artificial Analysis. Ces cinq modèles sont désormais entièrement accessibles sur la plateforme ouverte StepXingchen, couvrant cinq scénarios d’application principaux : génération de voix réalistes, création complète de contenu audio, interaction vocale en temps réel, compréhension vocale dans des scénarios complexes et production musicale.
Pour l’interaction en temps réel, StepAudio3Realtime est conçu pour offrir des conversations natives en duplex intégral. Il a obtenu la première place mondiale avec un score global de 98,9 % dans le classement Conversational Dynamics d’Artificial Analysis, et a également pris la tête du classement Speech Reasoning d’Artificial Analysis avec une précision de 99,7 %. Le modèle capture avec précision le rythme conversationnel, gère les interruptions et les retours continus des utilisateurs, et prend en charge la compréhension de la sémantique, du ton, des émotions, des paralinguistiques et des sons ambiants. De plus, il permet un raisonnement parallèle et une génération vocale simultanés, ainsi que des appels d’outils asynchrones (Tool Call) et des tâches longues, garantissant ainsi des conversations vocales sans interruption.
En matière de reconnaissance vocale, StepAudio3ASR combine une transcription de haute précision avec les capacités de raisonnement par connaissances des grands modèles de langage, surpassant les méthodes traditionnelles de transcription audio uniquement. Il prend en charge divers scénarios incluant le chinois, l’anglais, les dialectes, les langues mixtes, les fichiers audio longs et les domaines spécialisés. Le modèle excelle dans les contextes médical, juridique, financier, automobile et de programmation, et gère efficacement des environnements d’entrée complexes tels que le faible volume, les débits de parole rapides, les prononciations floues, le chant et la musique d’ambiance. Son taux d’erreur de mots (WER) en reconnaissance vocale non en streaming est de seulement 1,7 %, partageant la première place mondiale.
En génération vocale, StepAudio3TTS est un modèle réaliste conçu pour l’interaction en temps réel. Il s’aligne parfaitement sur les schémas naturels de la parole humaine en ce qui concerne la base vocale, l’intonation, le rythme et les pauses. Le modèle reproduit les expressions paralinguistiques telles que le rire, les hésitations, les bégaiements, les répétitions et les corrections, et peut ajuster automatiquement les tons émotionnels en fonction du contenu sémantique. Grâce à une architecture de génération en streaming, le modèle synchronise la génération et la lecture.
Pour la génération complète de contenu audio, StepAudio3Gen simplifie le processus traditionnel de production longue, d’édition et de mixage. Les utilisateurs peuvent générer simultanément des voix, des effets sonores, des sons ambiants et de la musique d’arrière-plan à l’aide de descriptions en langage naturel et d’extraits audio de référence. Le modèle permet un contrôle fin des caractéristiques paralinguistiques telles que la voix des personnages, le style de parole, les émotions, les dialectes et le rire. Il permet également aux utilisateurs de spécifier le moment et la séquence des dialogues, des effets sonores et de la musique d’arrière-plan, influençant directement la conception sonore et le séquencement temporel de l’ensemble du contenu.
En création musicale, StepAudio3Music prend en charge à la fois la génération en zéro shot et la création interactive multi-tours basée sur la notation ABC. Les utilisateurs peuvent entrer des paroles, des chants a cappella, des chansons de référence ou des notations, et utiliser le langage naturel pour contrôler le genre, les voix, la mélodie, le rythme, les instruments et les émotions. Le modèle comprend en profondeur la structure des chansons, le développement mélodique inter-paragraphe et les variations d’énergie. Particulièrement dans les scénarios d’accompagnement a cappella, une seule piste a cappella peut générer automatiquement l’harmonie, le rythme, les instruments et des arrangements complets, facilitant ainsi une véritable production musicale.
Article connexe
 Kimi K3 Set for Launch This Month With 2.5 Trillion Parameters
Le paysage des grands modèles s’est intensifié au cours du second semestre 2026. Aux côtés de DeepSeek V4, Kimi K3 de Moonshot AI est confirmé pour une sortie ce mois-ci.Bien que les dates spécifiques restent non divulguées, des sources internes ind
«Maman de Dunhuang» de Jia Zhangke Enregistré : Une mère célibataire tombe amoureuse de l'IA, voyage en Chine
En juillet 2026, l'Administration nationale du cinéma a approuvé le synopsis du prochain film de Jia Zhangke, « Dunhuang Mama ». Le synopsis décrit une histoire contemporaine d'une mère célibataire à Dunhuang qui se tourne progressivement vers l'inte
Deezer indique que plus de 50 % des fichiers mis en ligne chaque jour sont des morceaux générés par IA et prévoit de supprimer les contenus non écoutés au bout de six mois
Deezer, l'un des principaux services de streaming musical, a récemment révélé des statistiques alarmantes : les morceaux générés par l'IA représentent désormais plus de la moitié des mises en ligne qu
Recommandations de sujets spéciaux liés
Référencement
 Meilleurs auditeurs de liens internes par IA pour les grands sites éditoriaux et les pages de référencement programmatique
2026 Derniers Meilleurs Évaluateurs de Liens Internes IA les mieux notés pour les grands sites éditoriaux et les pages de référencement programmatique, sélectionnés par XIX.AI. Ces outils puissants offrent une efficacité révolutionnaire pour identifier les liens faibles, améliorer le classement du contenu et rationaliser les workflows SEO. Obtenez une comparaison gratuite entre versions gratuites et payantes, ainsi que des tests concrets et des classements mis à jour chaque semaine. Explorez dès maintenant pour débloquer votre avantage IA.
 10 outils
 xix.ai
Création de bande dessinée
Outils de coloriage de bandes dessinées par IA pour une production rapide d’épisodes
2026 : Les meilleures outils de coloriage de bandes dessinées par IA, hautement notés et récents, sélectionnés pour une production rapide d’épisodes ! XIX.AI propose des solutions puissantes et révolutionnaires qui stimulent la créativité et simplifient considérablement les workflows. Obtenez une comparaison gratuite versus payante, consultez des tests réalisés dans la pratique, et accédez à des classements mis à jour chaque semaine pour vous aider à trouver l’outil idéal à essayer absolument. Découvrez-le dès maintenant afin de tirer parti au maximum des technologies d’IA dans la production de bandes dessinées.
9 outils
xix.ai
Assistante de réunion
Les meilleurs outils de transcription basés sur l'IA pour les comptes rendus d'appels clients
Les meilleurs outils de transcription IA les mieux notés de 2026 pour les comptes-rendus d'appels clients ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires à essayer absolument, qui ont fait leurs preuves dans la pratique pour fournir des comptes-rendus précis et détaillés. Vous pouvez comparer côte à côte les options gratuites et payantes et découvrir comment elles boostent votre productivité. Découvrez dès maintenant l'outil qui vous convient le mieux et tirez pleinement parti de l'IA pour optimiser votre communication avec vos clients !
10 outils
xix.ai
Synthèse vocale
Meilleures plateformes de doublage par IA pour les shorts multilingues, tutoriels et présentations de produits
2026 Dernières Meilleures Platesformes de Doublage IA les mieux notées pour les courtes vidéos multilingues, tutoriels et présentations de produits ! XIX.AI propose une collection puissante et révolutionnaire, sélectionnée après des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des options incontournables qui améliorent considérablement la productivité, vous permettant de créer du contenu de haute qualité plus rapidement sans perdre de temps. Explorez dès maintenant pour découvrir l’outil idéal et débloquer votre avantage grâce à l’IA.
9 outils
xix.ai
Productivité
Outils de suivi des réunions ChatGPT pour le suivi des actions à mener, des responsables et des échéances
Classement 2026 des meilleurs outils de suivi de réunions ChatGPT ! XIX.AI a sélectionné une collection d’outils performants et très bien notés qui vous aident à transformer rapidement vos notes de réunion en actions concrètes, à suivre sans effort les responsables et les échéances, et à rester organisé tout au long de vos projets. Chaque outil est soumis à des tests rigoureux en conditions réelles afin de garantir sa fiabilité. Consultez le comparatif entre les versions gratuites et payantes ainsi que les classements pour découvrir la solution idéale qui vous permettra de booster votre productivité. Découvrez-les dès maintenant !
9 outils
xix.ai
Assistante de réunion
Les meilleurs outils d'organisation d'agenda basés sur l'IA : planifiez plus efficacement vos réunions hebdomadaires en quelques minutes
La page « Les meilleurs outils de création d’ordres du jour basés sur l’IA en 2026 » présente une sélection d’outils les mieux notés qui facilitent la planification des réunions hebdomadaires d’équipe. Ces solutions performantes vous aident à créer des ordres du jour structurés et efficaces en quelques minutes seulement, vous permettant ainsi de gagner un temps précieux et d’améliorer votre productivité. XIX.AI s’assure que tous les outils proposés sont soumis à des tests rigoureux en conditions réelles avant d’être inclus dans la sélection. Consultez notre comparatif entre les versions gratuites et payantes et découvrez les options incontournables qui vous permettront d’obtenir des résultats révolutionnaires. Explorez dès maintenant notre sélection pour trouver l’outil idéal qui vous permettra de fluidifier vos processus de travail !
15 outils
xix.ai

 commentaires (0)
Le 15 septembre, StepXingchen a officiellement lancé la nouvelle série de modèles de langage vocal StepAudio3. Ce lancement comprend cinq produits distincts : StepAudio3Realtime, StepAudio3ASR, StepAudio3TTS, StepAudio3Gen et StepAudio3Music. Plusieurs de ces modèles ont obtenu la première place mondiale sur la liste d’évaluation authoritative d’Artificial Analysis. Ces cinq modèles sont désormais entièrement accessibles sur la plateforme ouverte StepXingchen, couvrant cinq scénarios d’application principaux : génération de voix réalistes, création complète de contenu audio, interaction vocale en temps réel, compréhension vocale dans des scénarios complexes et production musicale.
Pour l’interaction en temps réel, StepAudio3Realtime est conçu pour offrir des conversations natives en duplex intégral. Il a obtenu la première place mondiale avec un score global de 98,9 % dans le classement Conversational Dynamics d’Artificial Analysis, et a également pris la tête du classement Speech Reasoning d’Artificial Analysis avec une précision de 99,7 %. Le modèle capture avec précision le rythme conversationnel, gère les interruptions et les retours continus des utilisateurs, et prend en charge la compréhension de la sémantique, du ton, des émotions, des paralinguistiques et des sons ambiants. De plus, il permet un raisonnement parallèle et une génération vocale simultanés, ainsi que des appels d’outils asynchrones (Tool Call) et des tâches longues, garantissant ainsi des conversations vocales sans interruption.
En matière de reconnaissance vocale, StepAudio3ASR combine une transcription de haute précision avec les capacités de raisonnement par connaissances des grands modèles de langage, surpassant les méthodes traditionnelles de transcription audio uniquement. Il prend en charge divers scénarios incluant le chinois, l’anglais, les dialectes, les langues mixtes, les fichiers audio longs et les domaines spécialisés. Le modèle excelle dans les contextes médical, juridique, financier, automobile et de programmation, et gère efficacement des environnements d’entrée complexes tels que le faible volume, les débits de parole rapides, les prononciations floues, le chant et la musique d’ambiance. Son taux d’erreur de mots (WER) en reconnaissance vocale non en streaming est de seulement 1,7 %, partageant la première place mondiale.
En génération vocale, StepAudio3TTS est un modèle réaliste conçu pour l’interaction en temps réel. Il s’aligne parfaitement sur les schémas naturels de la parole humaine en ce qui concerne la base vocale, l’intonation, le rythme et les pauses. Le modèle reproduit les expressions paralinguistiques telles que le rire, les hésitations, les bégaiements, les répétitions et les corrections, et peut ajuster automatiquement les tons émotionnels en fonction du contenu sémantique. Grâce à une architecture de génération en streaming, le modèle synchronise la génération et la lecture.
Pour la génération complète de contenu audio, StepAudio3Gen simplifie le processus traditionnel de production longue, d’édition et de mixage. Les utilisateurs peuvent générer simultanément des voix, des effets sonores, des sons ambiants et de la musique d’arrière-plan à l’aide de descriptions en langage naturel et d’extraits audio de référence. Le modèle permet un contrôle fin des caractéristiques paralinguistiques telles que la voix des personnages, le style de parole, les émotions, les dialectes et le rire. Il permet également aux utilisateurs de spécifier le moment et la séquence des dialogues, des effets sonores et de la musique d’arrière-plan, influençant directement la conception sonore et le séquencement temporel de l’ensemble du contenu.
En création musicale, StepAudio3Music prend en charge à la fois la génération en zéro shot et la création interactive multi-tours basée sur la notation ABC. Les utilisateurs peuvent entrer des paroles, des chants a cappella, des chansons de référence ou des notations, et utiliser le langage naturel pour contrôler le genre, les voix, la mélodie, le rythme, les instruments et les émotions. Le modèle comprend en profondeur la structure des chansons, le développement mélodique inter-paragraphe et les variations d’énergie. Particulièrement dans les scénarios d’accompagnement a cappella, une seule piste a cappella peut générer automatiquement l’harmonie, le rythme, les instruments et des arrangements complets, facilitant ainsi une véritable production musicale.








 Kimi K3 Set for Launch This Month With 2.5 Trillion Parameters
Le paysage des grands modèles s’est intensifié au cours du second semestre 2026. Aux côtés de DeepSeek V4, Kimi K3 de Moonshot AI est confirmé pour une sortie ce mois-ci.Bien que les dates spécifiques restent non divulguées, des sources internes ind
 «Maman de Dunhuang» de Jia Zhangke Enregistré : Une mère célibataire tombe amoureuse de l'IA, voyage en Chine
En juillet 2026, l'Administration nationale du cinéma a approuvé le synopsis du prochain film de Jia Zhangke, « Dunhuang Mama ». Le synopsis décrit une histoire contemporaine d'une mère célibataire à Dunhuang qui se tourne progressivement vers l'inte
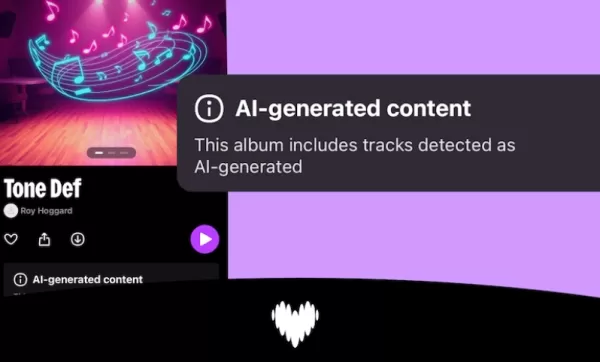 Deezer indique que plus de 50 % des fichiers mis en ligne chaque jour sont des morceaux générés par IA et prévoit de supprimer les contenus non écoutés au bout de six mois
Deezer, l'un des principaux services de streaming musical, a récemment révélé des statistiques alarmantes : les morceaux générés par l'IA représentent désormais plus de la moitié des mises en ligne qu
2026 Derniers Meilleurs Évaluateurs de Liens Internes IA les mieux notés pour les grands sites éditoriaux et les pages de référencement programmatique, sélectionnés par XIX.AI. Ces outils puissants offrent une efficacité révolutionnaire pour identifier les liens faibles, améliorer le classement du contenu et rationaliser les workflows SEO. Obtenez une comparaison gratuite entre versions gratuites et payantes, ainsi que des tests concrets et des classements mis à jour chaque semaine. Explorez dès maintenant pour débloquer votre avantage IA.
10 outils
xix.ai
2026 : Les meilleures outils de coloriage de bandes dessinées par IA, hautement notés et récents, sélectionnés pour une production rapide d’épisodes ! XIX.AI propose des solutions puissantes et révolutionnaires qui stimulent la créativité et simplifient considérablement les workflows. Obtenez une comparaison gratuite versus payante, consultez des tests réalisés dans la pratique, et accédez à des classements mis à jour chaque semaine pour vous aider à trouver l’outil idéal à essayer absolument. Découvrez-le dès maintenant afin de tirer parti au maximum des technologies d’IA dans la production de bandes dessinées.
9 outils
xix.ai
Les meilleurs outils de transcription IA les mieux notés de 2026 pour les comptes-rendus d'appels clients ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires à essayer absolument, qui ont fait leurs preuves dans la pratique pour fournir des comptes-rendus précis et détaillés. Vous pouvez comparer côte à côte les options gratuites et payantes et découvrir comment elles boostent votre productivité. Découvrez dès maintenant l'outil qui vous convient le mieux et tirez pleinement parti de l'IA pour optimiser votre communication avec vos clients !
10 outils
xix.ai
2026 Dernières Meilleures Platesformes de Doublage IA les mieux notées pour les courtes vidéos multilingues, tutoriels et présentations de produits ! XIX.AI propose une collection puissante et révolutionnaire, sélectionnée après des tests rigoureux en conditions réelles et des classements mis à jour chaque semaine. Vous y trouverez des options incontournables qui améliorent considérablement la productivité, vous permettant de créer du contenu de haute qualité plus rapidement sans perdre de temps. Explorez dès maintenant pour découvrir l’outil idéal et débloquer votre avantage grâce à l’IA.
9 outils
xix.ai
Classement 2026 des meilleurs outils de suivi de réunions ChatGPT ! XIX.AI a sélectionné une collection d’outils performants et très bien notés qui vous aident à transformer rapidement vos notes de réunion en actions concrètes, à suivre sans effort les responsables et les échéances, et à rester organisé tout au long de vos projets. Chaque outil est soumis à des tests rigoureux en conditions réelles afin de garantir sa fiabilité. Consultez le comparatif entre les versions gratuites et payantes ainsi que les classements pour découvrir la solution idéale qui vous permettra de booster votre productivité. Découvrez-les dès maintenant !
9 outils
xix.ai
La page « Les meilleurs outils de création d’ordres du jour basés sur l’IA en 2026 » présente une sélection d’outils les mieux notés qui facilitent la planification des réunions hebdomadaires d’équipe. Ces solutions performantes vous aident à créer des ordres du jour structurés et efficaces en quelques minutes seulement, vous permettant ainsi de gagner un temps précieux et d’améliorer votre productivité. XIX.AI s’assure que tous les outils proposés sont soumis à des tests rigoureux en conditions réelles avant d’être inclus dans la sélection. Consultez notre comparatif entre les versions gratuites et payantes et découvrez les options incontournables qui vous permettront d’obtenir des résultats révolutionnaires. Explorez dès maintenant notre sélection pour trouver l’outil idéal qui vous permettra de fluidifier vos processus de travail !
15 outils
xix.ai












