


 Heim
StepZen stellt die StepAudio 3-Serie der Sprachmodelle vor und sichert sich mehrere globale Erstveröffentlichungen
Am 15. September hat StepXingchen offiziell die neue Serie der Sprachgroßmodelle StepAudio3 veröffentlicht. Diese Veröffentlichung umfasst fünf verschiedene Produkte: StepAudio3Realtime, StepAudio3ASR, StepAudio3TTS, StepAudio3Gen und StepAudio3Music. Mehrere dieser Modelle haben in der autoritativen Auswertungsliste von Artificial Analysis den weltweit ersten Platz belegt. Diese fünf Modelle sind nun vollständig auf der offenen Plattform von StepXingchen verfügbar und decken fünf Kernanwendungsszenarien ab: realistische Sprachgenerierung, umfassende Audioinhaltscreation, Echtzeit-Sprachinteraktion, Sprachverständnis in komplexen Szenarien und Musikproduktion.
Für die Echtzeitinteraktion ist StepAudio3Realtime so konzipiert, dass es nativen Voll-Duplex-Gespräche ermöglicht. Es erreichte im Conversational Dynamics-Ranking von Artificial Analysis mit einem Gesamtscore von 98,9 % den ersten Platz weltweit und belegte auch im Speech Reasoning-Ranking von Artificial Analysis mit einer Genauigkeit von 99,7 % den ersten Platz. Das Modell erfasst präzise den Gesprächsrhythmus, verarbeitet Unterbrechungen und kontinuierliches Feedback der Nutzer und unterstützt das Verständnis von Semantik, Tonfall, Emotion, Paralinguistik und Umgebungsgeräuschen. Darüber hinaus ermöglicht es paralleles Reasoning und Sprachgenerierung sowie asynchrone Tool-Aufrufe (Tool Call) und lange Aufgaben, um unterbrechungsfreie Sprachkonversationen zu gewährleisten.
Bezüglich der Spracherkennung kombiniert StepAudio3ASR hochpräzise Transkription mit den Wissens-Reasoning-Fähigkeiten großer Sprachmodelle und übertrifft damit herkömmliche Methoden zur reinen Audio-Transkription. Es unterstützt vielfältige Szenarien, darunter Chinesisch, Englisch, Dialekte, gemischte Sprachen, lange Audiodateien und Fachgebiete. Das Modell glänzt in medizinischen, juristischen, finanziellen, automobiltechnischen und Programmierkontexten und bewältigt effektiv komplexe Eingabesituationen wie leise Lautstärke, hohe Sprechgeschwindigkeit, undeutliche Aussprache, Gesang und Hintergrundmusik. Die Wortfehlerquote (WER) der nicht-streamingbasierten Spracherkennung liegt bei lediglich 1,7 % und teilt sich den ersten Platz weltweit.
Bei der Sprachgenerierung ist StepAudio3TTS ein realistisches Modell, das für Echtzeitinteraktionen ausgelegt ist. Es stimmt perfekt mit natürlichen menschlichen Sprechmustern hinsichtlich Stimmgrund, Intonation, Rhythmus und Pausen überein. Das Modell reproduziert paralinguistische Ausdrücke wie Lachen, Zögern, Stottern, Wiederholungen und Korrekturen und kann emotionale Tonlagen autonom basierend auf semantischen Inhalten anpassen. Durch eine Streaming-Generierungsarchitektur synchronisiert das Modell Generierung und Wiedergabe.
Für die umfassende Audioinhaltsgenerierung vereinfacht StepAudio3Gen den traditionellen langen Produktions-, Bearbeitungs- und Mischprozess. Nutzer können Gesang, Soundeffekte, Umgebungsgeräusche und Hintergrundmusik gleichzeitig mithilfe natürlicher Sprachbeschreibungen und Referenzaudios generieren. Das Modell ermöglicht eine feine Steuerung paralinguistischer Merkmale wie Charakterstimme, Sprechstil, Emotion, Dialekte und Lachen. Es ermöglicht Nutzern auch, den Zeitpunkt und die Reihenfolge von Dialogen, Soundeffekten und Hintergrundmusik festzulegen, was direkt den gesamten Sounddesign- und Zeitablauf des Inhalts beeinflusst.
Bei der Musikproduktion unterstützt StepAudio3Music sowohl Zero-Shot-Generierung als auch mehrstufige interaktive Erstellung basierend auf ABC-Notation. Nutzer können Texte, A-cappella-Aufnahmen, Referenzlieder oder Notationen eingeben und natürliche Sprache verwenden, um Genre, Gesang, Melodie, Rhythmus, Instrumente und Emotionen zu steuern. Das Modell versteht tiefgreifend die Songstruktur, die melodische Entwicklung über Absätze hinweg und Energieverschiebungen. Besonders in Szenarien mit A-cappella-Begleitung kann ein einzelner A-cappella-Track automatisch Harmonien, Rhythmus, Instrumente und vollständige Arrangements generieren, was eine echte Musikproduktion erleichtert.
Verwandter Artikel
 Kimi K3-Set für diesen Monat mit 2,5 Billionen Parametern
Die Landschaft der großen Modelle hat sich im zweiten Halbjahr 2026 verschärft. Neben DeepSeek V4 ist die Veröffentlichung von Moonshot AIs Kimi K3 für diesen Monat bestätigt.Obwohl spezifische Daten noch nicht bekannt sind, berichten Insider, dass
Jia Zhangkes „Dunhuang Mama“ Registriert: Alleinerziehende Mutter verliebt sich in KI, bereist China
Im Juli 2026 genehmigte die Nationale Filmverwaltung das Drehbuchkonzept für den kommenden Film von Jia Zhangke „Dunhuang Mama“. Die Handlung beschreibt eine zeitgenössische Geschichte einer alleinerziehenden Mutter in Dunhuang, die zunehmend auf kün
Deezer berichtet, dass über 50 % der täglichen Uploads aus KI-Musik bestehen, und plant, nicht abgespielte Inhalte nach sechs Monaten zu löschen
Deezer, ein großer Musik-Streaming-Dienst, hat kürzlich alarmierende Zahlen veröffentlicht: KI-generierte Titel machen mittlerweile mehr als die Hälfte der täglichen Uploads aus. Im Juni verzeichnete
Empfehlungen zu verwandten Spezialthemen
SEO
 Die besten KI-gestützten Tools zur Überprüfung interner Links für große Redaktionsseiten und programmatische SEO-Seiten
2026 Neueste, beste und am höchsten bewertete KI-Tools für die interne Verlinkungsprüfung, speziell für große redaktionelle Websites und programmatische SEO-Seiten, kuratiert von XIX.AI. Diese leistungsstarken Tools bieten einen revolutionären Effizienzgewinn zur Identifizierung schwacher Links, zur Steigerung der Content-Rankings und zur Optimierung von SEO-Arbeitsabläufen. Erhalten Sie einen kostenlosen Vergleich zwischen kostenlosen und kostenpflichtigen Versionen sowie echte Tests und wöchentlich aktualisierte Rankings. Entdecken Sie jetzt, um Ihren KI-Vorteil zu nutzen.
 10 Tools
 xix.ai
Comic-Erstellung
AI-basierte Werkzeuge zum Ausmalen von Comics für eine schnelle Erstellung von Episoden
2026 – Die neuesten, besten und am höchsten bewerteten Tools zur Bemalung von AI-Comics für eine schnelle Erstellung von Episoden! XIX.AI bietet leistungsstarke Lösungen, die die Kreativität steigern und Arbeitsabläufe erheblich vereinfachen. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante, sehen Sie praktische Tests aus der Realität sowie wöchentlich aktualisierte Ranglisten – all das hilft Ihnen dabei, das perfekte Tool zu finden. Entdecken Sie jetzt, wie Sie durch KI Vorteile in der Comic-Produktion erlangen können.
9 Tools
xix.ai
Besprechungsassistent
Die besten KI-Tools zur Transkription von Kundengesprächen
Die besten und am besten bewerteten KI-Transkriptions-Tools für Kundengesprächsnotizen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Auswahl an Tools zusammengestellt, die Sie unbedingt ausprobieren sollten und die in der Praxis getestet wurden, um präzise und detaillierte Notizen zu liefern. Sie können kostenlose und kostenpflichtige Optionen direkt miteinander vergleichen und sehen, wie sie Ihre Produktivität steigern. Entdecken Sie jetzt Ihr perfektes Tool und nutzen Sie den KI-Vorteil in der Kundenkommunikation!
10 Tools
xix.ai
Text-zu-Sprache
Die besten KI-Synchronisationsplattformen für mehrsprachige Kurzvideos, Tutorials und Produktvorführungen
2026 Neueste Besten Top-bewertete KI-Dubbing-Plattformen für mehrsprachige Kurzvideos, Tutorials und Produktvorführungen! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Kollektion nach strengen Praxistests und wöchentlich aktualisierten Rankings. Sie finden unverzichtbare Optionen, die die Produktivität erheblich steigern und Ihnen helfen, qualitativ hochwertige Inhalte schneller zu erstellen, ohne Zeit zu verschwenden. Entdecken Sie jetzt Ihr perfektes Tool und erschließen Sie Ihren KI-Vorteil.
9 Tools
xix.ai
Produktivität
ChatGPT-Tools zur Nachbereitung von Besprechungen für die Erfassung von Aktionspunkten, Verantwortlichen und Fristen
2026: Die besten Tools zur Nachbereitung von Besprechungen mit ChatGPT im Ranking! XIX.AI hat eine Auswahl erstklassiger, leistungsstarker Tools zusammengestellt, mit denen Sie Besprechungsnotizen schnell in umsetzbare Maßnahmen umwandeln, Verantwortliche und Fristen mühelos im Blick behalten und Ihre Projekte stets gut organisiert halten können. Jedes Tool durchläuft strenge Praxistests, um seine Zuverlässigkeit sicherzustellen. Sehen Sie sich den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie die Rangliste an, um die perfekte Lösung zur Steigerung Ihrer Produktivität zu finden. Entdecken Sie die Tools jetzt!
9 Tools
xix.ai
Besprechungsassistent
Die besten KI-Agenda-Planer: Bessere wöchentliche Abstimmungen in wenigen Minuten planen
Die Seite „2026: Die besten KI-Agenda-Generatoren“ enthält eine sorgfältig zusammengestellte Liste der am besten bewerteten Tools, mit denen sich wöchentliche Team-Besprechungen mühelos planen lassen. Diese leistungsstarken Lösungen helfen Ihnen dabei, in nur wenigen Minuten übersichtliche und effiziente Tagesordnungen zu erstellen, wodurch Sie wertvolle Zeit sparen und Ihre Produktivität steigern können. XIX.AI stellt sicher, dass alle Einträge vor ihrer Aufnahme strengen Praxistests unterzogen werden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten und entdecken Sie die Optionen, die Sie unbedingt ausprobieren sollten und die bahnbrechende Ergebnisse liefern. Stöbern Sie jetzt und finden Sie Ihr perfektes Tool für reibungslosere Arbeitsabläufe!
15 Tools
xix.ai

 Kommentare (0)
Am 15. September hat StepXingchen offiziell die neue Serie der Sprachgroßmodelle StepAudio3 veröffentlicht. Diese Veröffentlichung umfasst fünf verschiedene Produkte: StepAudio3Realtime, StepAudio3ASR, StepAudio3TTS, StepAudio3Gen und StepAudio3Music. Mehrere dieser Modelle haben in der autoritativen Auswertungsliste von Artificial Analysis den weltweit ersten Platz belegt. Diese fünf Modelle sind nun vollständig auf der offenen Plattform von StepXingchen verfügbar und decken fünf Kernanwendungsszenarien ab: realistische Sprachgenerierung, umfassende Audioinhaltscreation, Echtzeit-Sprachinteraktion, Sprachverständnis in komplexen Szenarien und Musikproduktion.
Für die Echtzeitinteraktion ist StepAudio3Realtime so konzipiert, dass es nativen Voll-Duplex-Gespräche ermöglicht. Es erreichte im Conversational Dynamics-Ranking von Artificial Analysis mit einem Gesamtscore von 98,9 % den ersten Platz weltweit und belegte auch im Speech Reasoning-Ranking von Artificial Analysis mit einer Genauigkeit von 99,7 % den ersten Platz. Das Modell erfasst präzise den Gesprächsrhythmus, verarbeitet Unterbrechungen und kontinuierliches Feedback der Nutzer und unterstützt das Verständnis von Semantik, Tonfall, Emotion, Paralinguistik und Umgebungsgeräuschen. Darüber hinaus ermöglicht es paralleles Reasoning und Sprachgenerierung sowie asynchrone Tool-Aufrufe (Tool Call) und lange Aufgaben, um unterbrechungsfreie Sprachkonversationen zu gewährleisten.
Bezüglich der Spracherkennung kombiniert StepAudio3ASR hochpräzise Transkription mit den Wissens-Reasoning-Fähigkeiten großer Sprachmodelle und übertrifft damit herkömmliche Methoden zur reinen Audio-Transkription. Es unterstützt vielfältige Szenarien, darunter Chinesisch, Englisch, Dialekte, gemischte Sprachen, lange Audiodateien und Fachgebiete. Das Modell glänzt in medizinischen, juristischen, finanziellen, automobiltechnischen und Programmierkontexten und bewältigt effektiv komplexe Eingabesituationen wie leise Lautstärke, hohe Sprechgeschwindigkeit, undeutliche Aussprache, Gesang und Hintergrundmusik. Die Wortfehlerquote (WER) der nicht-streamingbasierten Spracherkennung liegt bei lediglich 1,7 % und teilt sich den ersten Platz weltweit.
Bei der Sprachgenerierung ist StepAudio3TTS ein realistisches Modell, das für Echtzeitinteraktionen ausgelegt ist. Es stimmt perfekt mit natürlichen menschlichen Sprechmustern hinsichtlich Stimmgrund, Intonation, Rhythmus und Pausen überein. Das Modell reproduziert paralinguistische Ausdrücke wie Lachen, Zögern, Stottern, Wiederholungen und Korrekturen und kann emotionale Tonlagen autonom basierend auf semantischen Inhalten anpassen. Durch eine Streaming-Generierungsarchitektur synchronisiert das Modell Generierung und Wiedergabe.
Für die umfassende Audioinhaltsgenerierung vereinfacht StepAudio3Gen den traditionellen langen Produktions-, Bearbeitungs- und Mischprozess. Nutzer können Gesang, Soundeffekte, Umgebungsgeräusche und Hintergrundmusik gleichzeitig mithilfe natürlicher Sprachbeschreibungen und Referenzaudios generieren. Das Modell ermöglicht eine feine Steuerung paralinguistischer Merkmale wie Charakterstimme, Sprechstil, Emotion, Dialekte und Lachen. Es ermöglicht Nutzern auch, den Zeitpunkt und die Reihenfolge von Dialogen, Soundeffekten und Hintergrundmusik festzulegen, was direkt den gesamten Sounddesign- und Zeitablauf des Inhalts beeinflusst.
Bei der Musikproduktion unterstützt StepAudio3Music sowohl Zero-Shot-Generierung als auch mehrstufige interaktive Erstellung basierend auf ABC-Notation. Nutzer können Texte, A-cappella-Aufnahmen, Referenzlieder oder Notationen eingeben und natürliche Sprache verwenden, um Genre, Gesang, Melodie, Rhythmus, Instrumente und Emotionen zu steuern. Das Modell versteht tiefgreifend die Songstruktur, die melodische Entwicklung über Absätze hinweg und Energieverschiebungen. Besonders in Szenarien mit A-cappella-Begleitung kann ein einzelner A-cappella-Track automatisch Harmonien, Rhythmus, Instrumente und vollständige Arrangements generieren, was eine echte Musikproduktion erleichtert.








 Kimi K3-Set für diesen Monat mit 2,5 Billionen Parametern
Die Landschaft der großen Modelle hat sich im zweiten Halbjahr 2026 verschärft. Neben DeepSeek V4 ist die Veröffentlichung von Moonshot AIs Kimi K3 für diesen Monat bestätigt.Obwohl spezifische Daten noch nicht bekannt sind, berichten Insider, dass
 Jia Zhangkes „Dunhuang Mama“ Registriert: Alleinerziehende Mutter verliebt sich in KI, bereist China
Im Juli 2026 genehmigte die Nationale Filmverwaltung das Drehbuchkonzept für den kommenden Film von Jia Zhangke „Dunhuang Mama“. Die Handlung beschreibt eine zeitgenössische Geschichte einer alleinerziehenden Mutter in Dunhuang, die zunehmend auf kün
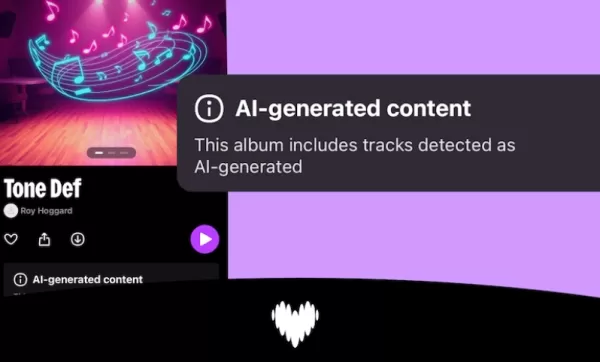 Deezer berichtet, dass über 50 % der täglichen Uploads aus KI-Musik bestehen, und plant, nicht abgespielte Inhalte nach sechs Monaten zu löschen
Deezer, ein großer Musik-Streaming-Dienst, hat kürzlich alarmierende Zahlen veröffentlicht: KI-generierte Titel machen mittlerweile mehr als die Hälfte der täglichen Uploads aus. Im Juni verzeichnete
2026 Neueste, beste und am höchsten bewertete KI-Tools für die interne Verlinkungsprüfung, speziell für große redaktionelle Websites und programmatische SEO-Seiten, kuratiert von XIX.AI. Diese leistungsstarken Tools bieten einen revolutionären Effizienzgewinn zur Identifizierung schwacher Links, zur Steigerung der Content-Rankings und zur Optimierung von SEO-Arbeitsabläufen. Erhalten Sie einen kostenlosen Vergleich zwischen kostenlosen und kostenpflichtigen Versionen sowie echte Tests und wöchentlich aktualisierte Rankings. Entdecken Sie jetzt, um Ihren KI-Vorteil zu nutzen.
10 Tools
xix.ai
2026 – Die neuesten, besten und am höchsten bewerteten Tools zur Bemalung von AI-Comics für eine schnelle Erstellung von Episoden! XIX.AI bietet leistungsstarke Lösungen, die die Kreativität steigern und Arbeitsabläufe erheblich vereinfachen. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante, sehen Sie praktische Tests aus der Realität sowie wöchentlich aktualisierte Ranglisten – all das hilft Ihnen dabei, das perfekte Tool zu finden. Entdecken Sie jetzt, wie Sie durch KI Vorteile in der Comic-Produktion erlangen können.
9 Tools
xix.ai
Die besten und am besten bewerteten KI-Transkriptions-Tools für Kundengesprächsnotizen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Auswahl an Tools zusammengestellt, die Sie unbedingt ausprobieren sollten und die in der Praxis getestet wurden, um präzise und detaillierte Notizen zu liefern. Sie können kostenlose und kostenpflichtige Optionen direkt miteinander vergleichen und sehen, wie sie Ihre Produktivität steigern. Entdecken Sie jetzt Ihr perfektes Tool und nutzen Sie den KI-Vorteil in der Kundenkommunikation!
10 Tools
xix.ai
2026 Neueste Besten Top-bewertete KI-Dubbing-Plattformen für mehrsprachige Kurzvideos, Tutorials und Produktvorführungen! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Kollektion nach strengen Praxistests und wöchentlich aktualisierten Rankings. Sie finden unverzichtbare Optionen, die die Produktivität erheblich steigern und Ihnen helfen, qualitativ hochwertige Inhalte schneller zu erstellen, ohne Zeit zu verschwenden. Entdecken Sie jetzt Ihr perfektes Tool und erschließen Sie Ihren KI-Vorteil.
9 Tools
xix.ai
2026: Die besten Tools zur Nachbereitung von Besprechungen mit ChatGPT im Ranking! XIX.AI hat eine Auswahl erstklassiger, leistungsstarker Tools zusammengestellt, mit denen Sie Besprechungsnotizen schnell in umsetzbare Maßnahmen umwandeln, Verantwortliche und Fristen mühelos im Blick behalten und Ihre Projekte stets gut organisiert halten können. Jedes Tool durchläuft strenge Praxistests, um seine Zuverlässigkeit sicherzustellen. Sehen Sie sich den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie die Rangliste an, um die perfekte Lösung zur Steigerung Ihrer Produktivität zu finden. Entdecken Sie die Tools jetzt!
9 Tools
xix.ai
Die Seite „2026: Die besten KI-Agenda-Generatoren“ enthält eine sorgfältig zusammengestellte Liste der am besten bewerteten Tools, mit denen sich wöchentliche Team-Besprechungen mühelos planen lassen. Diese leistungsstarken Lösungen helfen Ihnen dabei, in nur wenigen Minuten übersichtliche und effiziente Tagesordnungen zu erstellen, wodurch Sie wertvolle Zeit sparen und Ihre Produktivität steigern können. XIX.AI stellt sicher, dass alle Einträge vor ihrer Aufnahme strengen Praxistests unterzogen werden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten und entdecken Sie die Optionen, die Sie unbedingt ausprobieren sollten und die bahnbrechende Ergebnisse liefern. Stöbern Sie jetzt und finden Sie Ihr perfektes Tool für reibungslosere Arbeitsabläufe!
15 Tools
xix.ai












